 seedlookout
 Ziarna
 Mapa ziaren
 Wyszukiwarka ziaren
 Struktury
 Narzędzia
 Artykuły
 O nas
Wskaźnik doświadczeń dla ziaren gry Minecraft może pomóc odpowiedzieć na praktyczne pytanie: ile różnorodnego terenu i ile rodzajów miejsc do odwiedzenia oferuje to ziarno w obszarze, który chcę zbadać?
Nasz kalkulator doświadczeń z ziarna nazywa ten wskaźnik Indeksem odkryć w Overworldzie. Łączy rodziny biomów znalezione w próbkach i przewidywane typy struktur w wynik od 0 do 100, przyznając więcej punktów za odkrycia bliżej szacowanego punktu odrodzenia. Wybierasz edycję, wersję generowania i promień. Wynik opisuje modelowaną różnorodność; o tym, czy chcesz tam grać, nadal decydują twoje preferencje.
Zbadaliśmy po 1024 pseudolosowe ziarna w każdym z dwóch modeli generowania. Przy promieniu 2048 bloków mediana wyświetlanego wskaźnika wynosiła 62 w Java 26.3 i 63 w Bedrock 26.50. Matematyczna górna granica 100 w przyjętych zasadach punktacji jest inną wielkością niż środek tej próby. Poniższe wykresy pokazują, jak osadzić wynik w kontekście bez przekształcania go w ocenę przyjemności z gry.
Wybierz promień eksploracji
Kalkulator oferuje promienie wynoszące 512, 1024, 2048 i 4096 bloków. Każdy z nich wyznacza koło mierzone w poziomie od szacowanego punktu odrodzenia w świecie. Promień 2048 bloków sięga na taką odległość w każdym kierunku; nie oznacza to, że podczas wędrówki na dystansie 2048 bloków odwiedzisz wszystko w jego obrębie.
Domyślnie używamy 2048 bloków, ponieważ narzędzie potrzebuje początkowego obszaru. Nie skalibrowaliśmy tego wyboru na podstawie reprezentatywnej miary odległości, na jakie gracze gry Minecraft eksplorują świat. Poradnik eksploracji Mojang opisuje zarówno krótkie wyprawy, jak i większe przygody, ale nie podaje średniego promienia.
Wybierz promień pasujący do świata, którego szukasz. Małe koło pozwala ocenić różnorodność w pobliżu. Większe koło obejmuje więcej potencjalnych miejsc do odwiedzenia i przyznaje temu samemu pobliskiemu odkryciu więcej punktów za odległość. Porównuj dwa ziarna przy tym samym promieniu, aby kryterium porównania pozostało spójne.
Promień zmienia więc dwie rzeczy: przeszukiwany obszar i punktację za daną odległość. Przewidywana lokalizacja oddalona o 1024 bloki od punktu odrodzenia otrzymuje 0.75 punktu przy promieniu 2048, a 0.875 przy promieniu 4096. Przy większym promieniu wynik może wzrosnąć, zanim zostanie znaleziony kolejny typ. Taki wzrost odpowiada na pytanie o eksplorację większego obszaru; nie dowodzi, że samo ziarno się poprawiło.
Policz różne doświadczenia
Zliczanie biomów bez grupowania może przyznać kilka punktów za blisko spokrewnione rodzaje terenu. Kalkulator nadal pokazuje te niegrupowane identyfikatory, ale na potrzeby punktacji łączy pokrewne warianty w grupy. Plains i sunflower plains należą do jednej rodziny. Ocean i deep ocean tworzą kolejną. Kwiecisty las ma własną rodzinę; rodziny jaskiniowe również liczą się osobno.
Te rodziny są naszymi definicjami redakcyjnymi. Narzędzie nie punktuje zdobywania postępów. Każda rodzina kwalifikująca się do punktacji ma taką samą wagę w części wyniku dotyczącej biomów. Rodzina kwalifikuje się tylko wtedy, gdy katalog dla danej wersji wybranego modelu generowania zawiera przynajmniej jeden należący do niej biom.
Dla terenu na powierzchni kalkulator pobiera próbki w siatce co 32 bloki, na przybliżonej wysokości powierzchni. Jeśli na tej wysokości zostanie zwrócony biom jaskiniowy, pomija tę próbkę przy zliczaniu biomów powierzchniowych. Wąskie obszary mogą znaleźć się między punktami siatki, więc liczba bez grupowania oznacza liczbę identyfikatorów biomów znalezionych w próbkach, a nie ich pełny wykaz.
Próbki jaskiń są pobierane na siatce co 64 bloki na wysokościach Y -48, -32, -16, 0, 16, 32 and 48, z zachowaniem punktów co najmniej osiem bloków poniżej przybliżonej powierzchni. Te próbki pozwalają rozpoznać obszary biomów jaskiniowych. Punkt próbki może leżeć wewnątrz litego terenu, więc nie dowodzi, że pod tymi współrzędnymi znajduje się dostępna jaskinia. W tym pierwszym schemacie oceny przemieszczanie się w pionie i wysiłek związany z kopaniem nie powodują potrąceń za odległość.
Struktury wnoszą wkład według typu: wioski liczą się raz, niezależnie od tego, ile przewidywanych wiosek znajduje się wewnątrz koła. Wioska i wrak statku dodają dwa różne typy. Kalkulator szuka najbliższej przewidywanej lokalizacji każdego uwzględnianego typu, w tym miejsc pod ziemią, gdy obsługują je kryteria danej wersji.
Opuszczone kopalnie są wyłączone z każdego profilu, ponieważ dostępna funkcja wyszukiwania najbliższej struktury nie może ustalić pokrycia wyszukiwaniem dla wszystkich oferowanych promieni. Wynik mierzy zatem wymienione w nim kryteria, a nie wszystkie możliwe miejsca do odwiedzenia w Overworld.
Przyznawaj większą wartość punktową pobliskim odkryciom
Dla każdej znalezionej rodziny lub typu struktury odległość w poziomie określa wartość punktową:
credit = 1 − 0.5 × distance / radius
Odkrycie w punkcie odrodzenia otrzymuje wartość 1. W odległości równej połowie promienia otrzymuje 0.75, a na granicy 0.5. Nieznalezione kryterium otrzymuje 0. Średnia każdej kategorii uwzględnia w mianowniku wszystkie kwalifikujące się kryteria, także te nieznalezione.
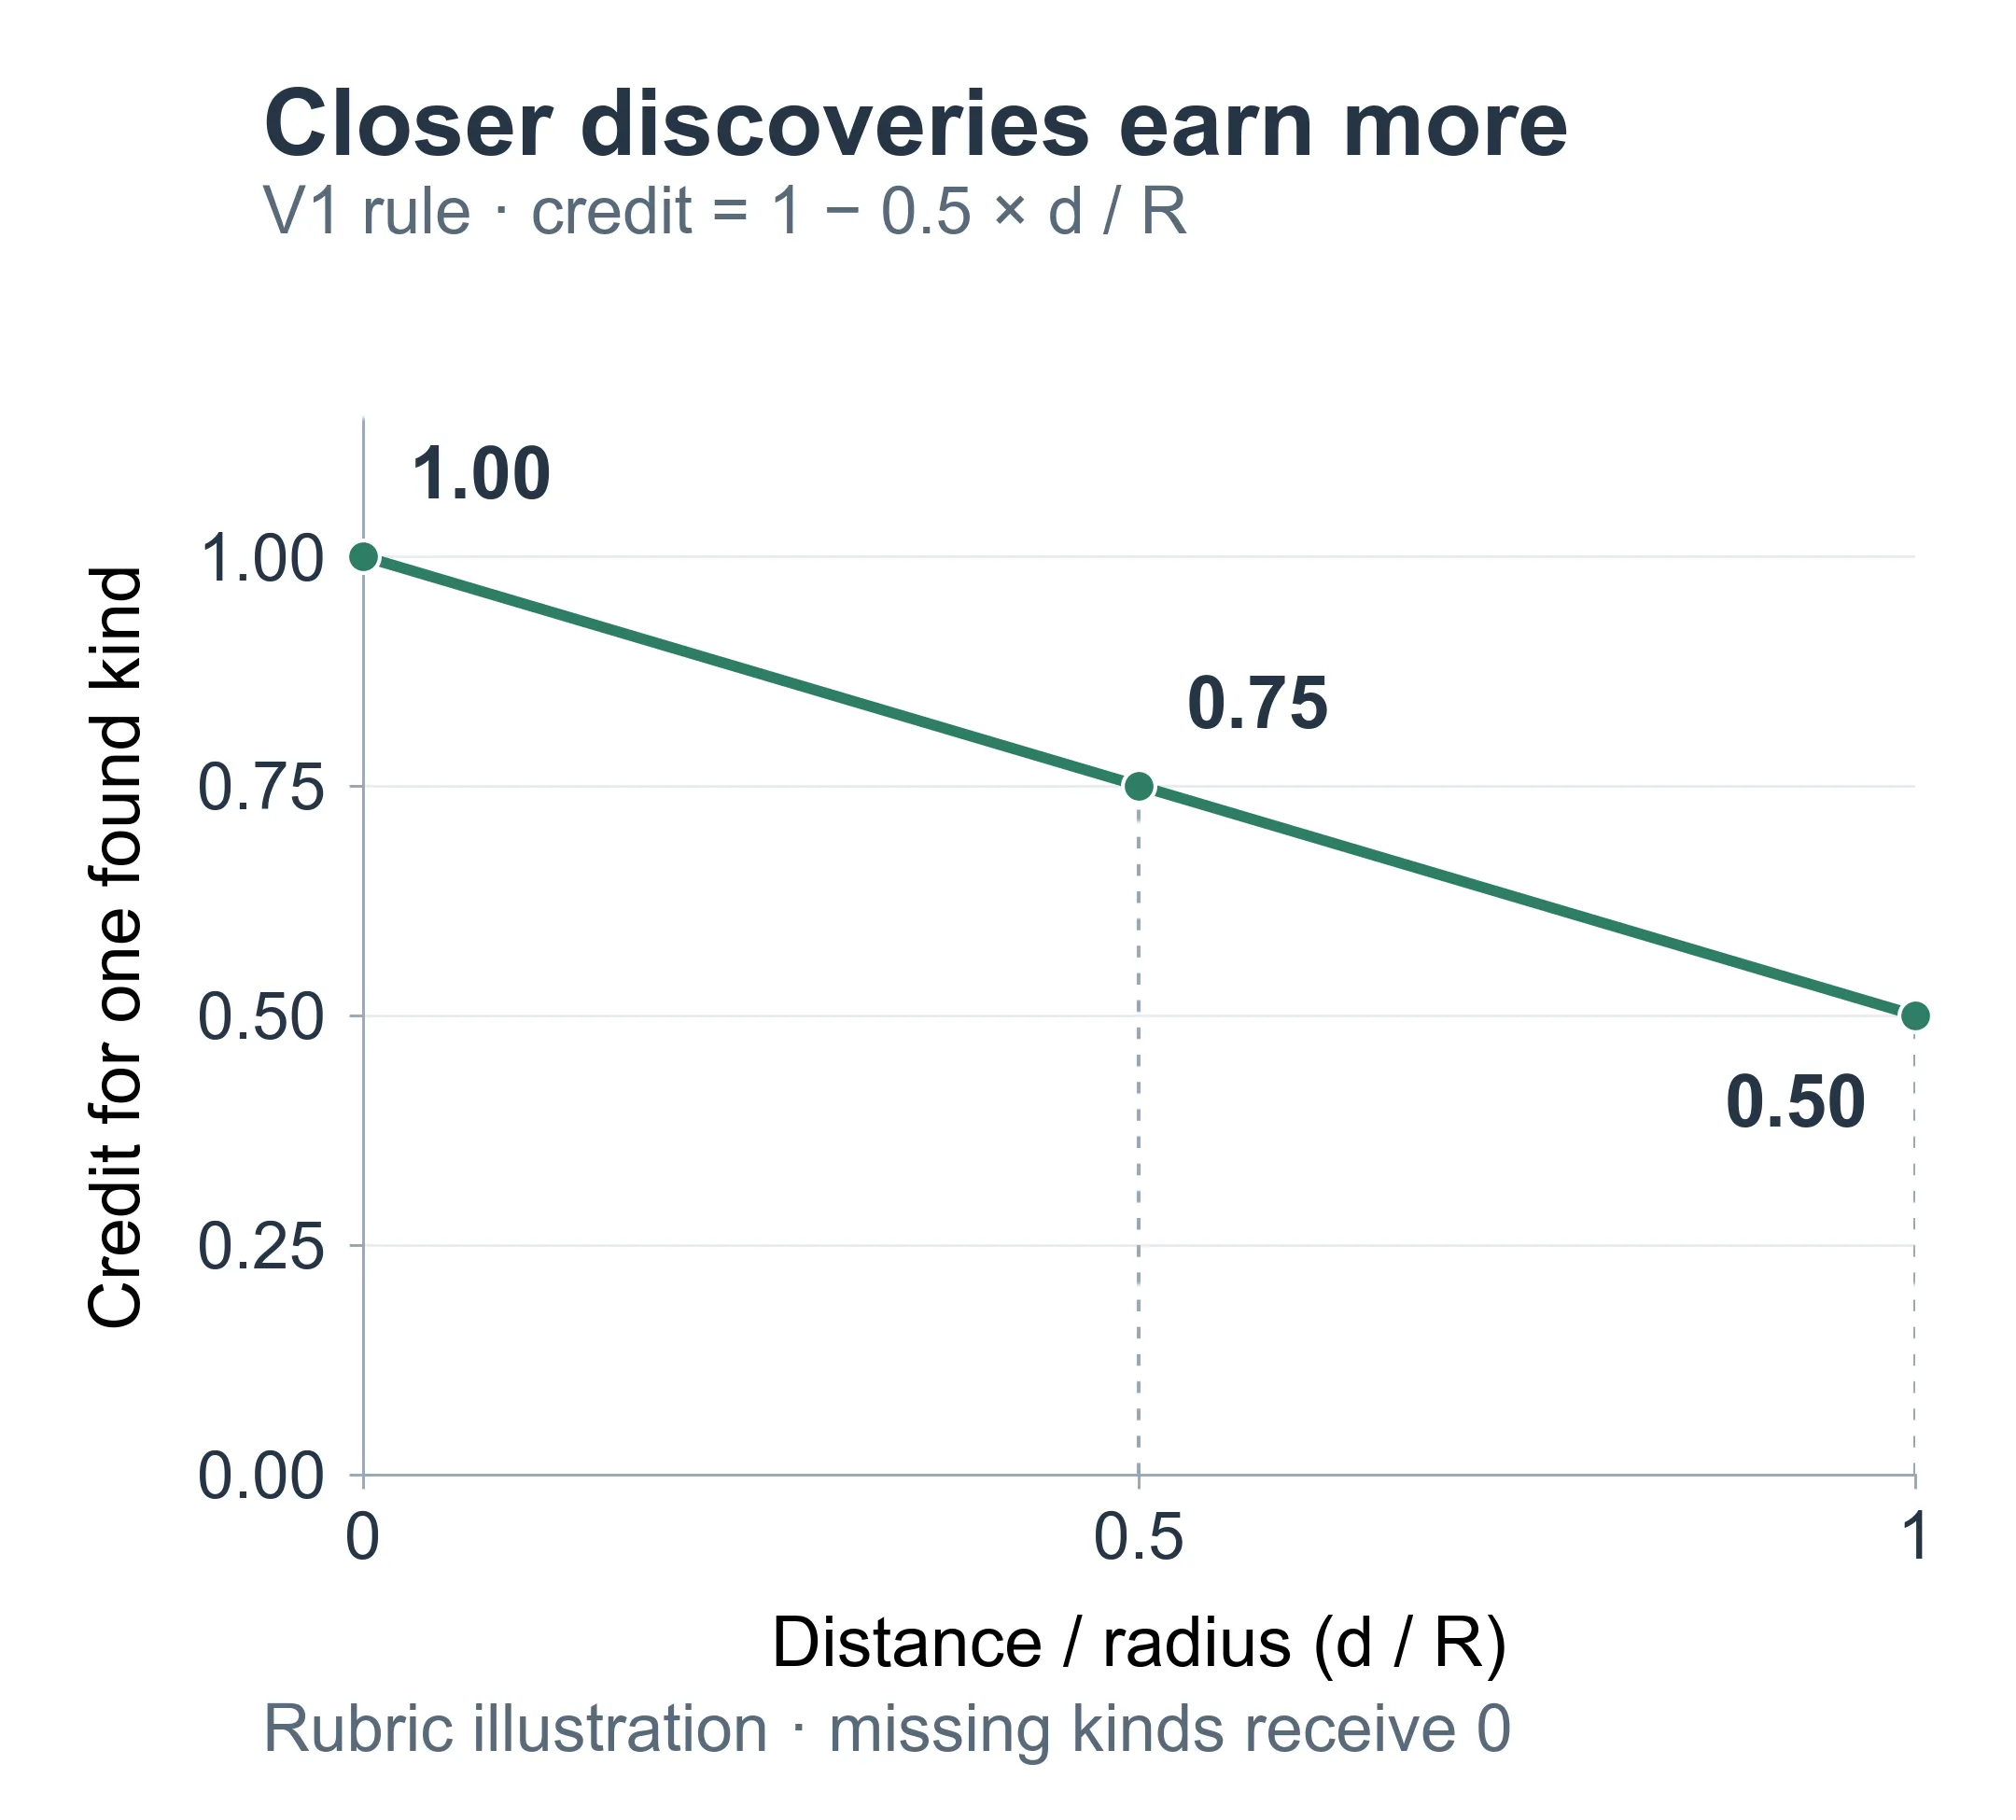
Ilustracja schematu oceny, a nie próbka światów. Oś pozioma przedstawia odległość podzieloną przez wybrany promień; oś pionowa pokazuje wartość punktową jednego znalezionego kryterium.
Końcowe obliczenie nadaje obu kategoriom równe wagi:
index = round(100 × (0.5 × biome average + 0.5 × structure average))
W profilach Java 26.3 i Bedrock 26.50 biomy mogą otrzymać do 50 punktów za 35 rodzin, a struktury do 50 za 17 typów. Jedna rodzina może wnieść około 50 / 35 = 1.43 punktu indeksu przed zaokrągleniem; jeden typ struktury może wnieść około 50 / 17 = 2.94. Oba wkłady maleją wraz z odległością. Połączenie wszystkich 52 kryteriów w jedną listę o równych wagach nadałoby biomom większy wpływ; podział na dwie połowy utrzymuje równe łączne wagi obu kategorii.
Oto hipotetyczny przykład pokazujący obliczenia, a nie wynik dla konkretnego ziarna:
| Kategoria | Wartości punktowe uwzględnianych w niej kryteriów | Średnia |
|---|---|---|
| Cztery rodziny biomów | 1, 0.75, 0.5, 0 | 0.5625 |
| Trzy typy struktur | 0.75, 0, 0 | 0.25 |
Indeks wynosi round(100 × (0.5 × 0.5625 + 0.5 × 0.25)) = 41.
Grupowanie, równe wagi kategorii i połowa wartości punktowej na granicy to wybory przyjęte w rewizji 1. Nie dopasowaliśmy tych wyborów do ankiety na temat tego, co sprawia graczom przyjemność. Rodzina lub typ struktury nie otrzymuje automatycznie dodatkowej wartości punktowej dlatego, że rzadziej występuje w próbie odniesienia.
Narzędzie rozróżnia też zakończone wyszukiwanie bez znalezionej przewidywanej lokalizacji od nieukończonego wyszukiwania. Gdy ograniczone pokrycie wyszukiwaniem struktur pozostawia status typu nieznany, łączny wynik nie jest podawany. Nieznane pokrycie nie liczy się ani jako udane odkrycie, ani jako brak typu.
Współdziel kod obliczeń, sprawdzaj kryteria dla poszczególnych wersji
Obsługa wersji Minecraft wymaga dwóch osobnych decyzji: jakiego modelu generowania użyć i jakie kryteria obliczeń zastosować.
Kalkulator korzysta z jednego wspólnego rdzenia pobierania próbek i obliczania punktacji. Java i Bedrock używają istniejących w witrynie modeli generowania właściwych dla danej edycji. Jawny rejestr łączy każdą obsługiwaną wersję generowania z jej kryteriami obliczeń. Wersje mogą współdzielić zestaw kryteriów, gdy zasady są takie same; nie potrzebują osobnych kopii silnika kalkulatora.
Kryteria określają uwzględniane typy struktur, odstępy między próbkami, głębokości jaskiń, wagi kategorii i wartość punktową zależną od odległości. Katalog biomów pochodzi z wybranej wersji modelu i jest dopasowywany do sprawdzonych definicji rodzin. Nieznana nazwa biomu lub nieobsługiwana wersja zatrzymuje obliczenia do czasu sprawdzenia odpowiednich kryteriów.
Na przykład obecny profil Java 1.18.2 uwzględnia 29 rodzin biomów i 13 typów struktur. Java 26.3 ma 35 rodzin i 17 typów. To mianowniki kalkulatora, a nie liczby dla jakiegokolwiek pojedynczego ziarna. Starszy profil nigdy nie traci punktów za kategorie spoza modelu i kryteriów jego wersji.
Każdy wynik wskazuje edycję, wersję generowania i rewizję obliczeń. Jeśli grupowanie lub wagi się zmienią, schemat oceny wymaga nowej rewizji. Odpowiadająca mu próba odniesienia również musi zostać oceniona według tych zasad. Pozwala to utrzymywać kod obliczeń, zachowując znaczenie zapisanego wyniku.
Odczytuj wynik jako zbiór przewidywań
Widok wyniku pokazuje wynik zapisany dużymi cyframi, paski wartości punktowej zależnej od odległości oraz ikony każdej uwzględnianej rodziny biomów i każdego typu struktury. Przygaszone ikony biomów oznaczają „nie objęto próbkowaniem”; przygaszone ikony struktur oznaczają „nie znaleziono przewidywanej lokalizacji”. Nieznane pokrycie ma osobny stan, a typy wyłączone lub nieuwzględniane w danej wersji znajdują się poza listami objętymi punktacją.
Zestawy ikon pokazują, jakie rodzaje były reprezentowane. Paski wkładu wyjaśniają, ile z możliwej wartości punktowej pozostało po potrąceniu za odległość. Dwa ziarna mogą mieć takie same liczby rodzin i typów, ale różne wyniki, jeśli ich najbliższe odkrycia leżą w różnych odległościach. Porównując je, uwzględniaj te liczby i wkłady obu kategorii obok łącznego wyniku.
Wynik zachowuje liczby biomów powierzchniowych i jaskiniowych znalezionych w próbkach, oba mianowniki i współrzędne najbliższych lokalizacji. Linki do mapy ziarna pozwalają przyjrzeć się tym miejscom. Współrzędne biomu wskazują najbliższy punkt próbki, a nie dokładną granicę biomu. Punkt odrodzenia i wysokość powierzchni są szacunkowe.
Przewidywania struktur wykorzystują dostępne kontrole rozmieszczenia i biomów; późniejsze etapy generowania nadal mogą uniemożliwić powstanie struktury. Bedrock korzysta z modelu zgodności, którego dokładności nie sprawdzono niezależnie w grze. Strona o witrynie wyjaśnia stosowane w niej oznaczenia dowodów.
Profil obejmuje domyślne generowanie. Niestandardowe pakiety danych, Large Biomes, światy typu superflat oraz istniejące chunki wygenerowane przed aktualizacją świata wykraczają poza jego zakres. Użyj wersji, w której wygenerowano oceniany obszar.
Wysoki indeks nie potwierdza atrakcyjnych krajobrazów, łatwej gry w trybie przetrwania ani cennych łupów. Nie mówi też, jaką część koła faktycznie odwiedzisz. Świat z wyspami i niskim wynikiem różnorodności może pasować ci bardziej niż ziarno z wieloma kategoriami w pobliżu.
Oblicz wynik ziarna, które cię interesuje
Otwórz kalkulator, wpisz ziarno i wybierz jego edycję oraz wersję generowania. Java przyjmuje też tekst ziarna i przekształca go w ziarno liczbowe; Bedrock przyjmuje ziarno liczbowe. Wybierz promień, a następnie uruchom obliczenia.
Zanim porównasz końcowe liczby, sprawdź podział na kategorie. Jeśli najbardziej zależy ci na konkretnym biomie lub strukturze, użyj wyszukiwarki ziaren, aby wyszukać ziarna spełniające ten warunek, a następnie oceń różnorodność otoczenia w kalkulatorze. Adres URL kalkulatora zachowuje wprowadzone ustawienia, więc możesz wrócić do tego samego pytania.
Co mówią nam losowe ziarna
Wybraliśmy 1024 pseudolosowe ziarna liczbowe zapisane jako 64-bitowe liczby ze znakiem i oceniliśmy każde ziarno zarówno w edycji Java 26.3, jak i w edycji Bedrock 26.50. Obie kohorty korzystają z domyślnego generowania wymiaru Overworld, promienia 2048 bloków i rewizji obliczeń 1, z 35 kwalifikującymi się rodzinami biomów i 17 typami struktur. Te same wartości ziaren tworzą badanie sparowane; rozkład każdej edycji podsumowujemy osobno. Ukończono wszystkie 2048 ocen modelu, bez pominięcia ani zastąpienia jakiegokolwiek nieudanego lub niepełnego wyniku.
Wybraliśmy ziarna liczbowe bez dobierania ich z opublikowanego katalogu. To badanie opisuje kalkulator przy tych ustawieniach; nie mierzy światów, które gracze postanowili zachować.
Odczytaj rozkład ogólnego wyniku
Tabela opisuje wyświetlany, zaokrąglony indeks. Zakres P10 do P90 podaje wartości 10. i 90. percentyla próby. Powtarzające się wyniki całkowitoliczbowe sprawiają, że odsetek wyników między tymi wartościami może przekraczać 80%; ten zakres nie jest przedziałem ufności.
| Model generowania | Średni indeks | Mediana indeksu | P10 do P90 | Mediana liczby rodzin w próbkach | Mediana liczby przewidywanych typów |
|---|---|---|---|---|---|
| Java 26.3 | 62.4 | 62 | 56 do 68 | 27 z 35 | 13 z 17 |
| Bedrock 26.50 | 62.8 | 63 | 57 do 69 | 27 z 35 | 13 z 17 |
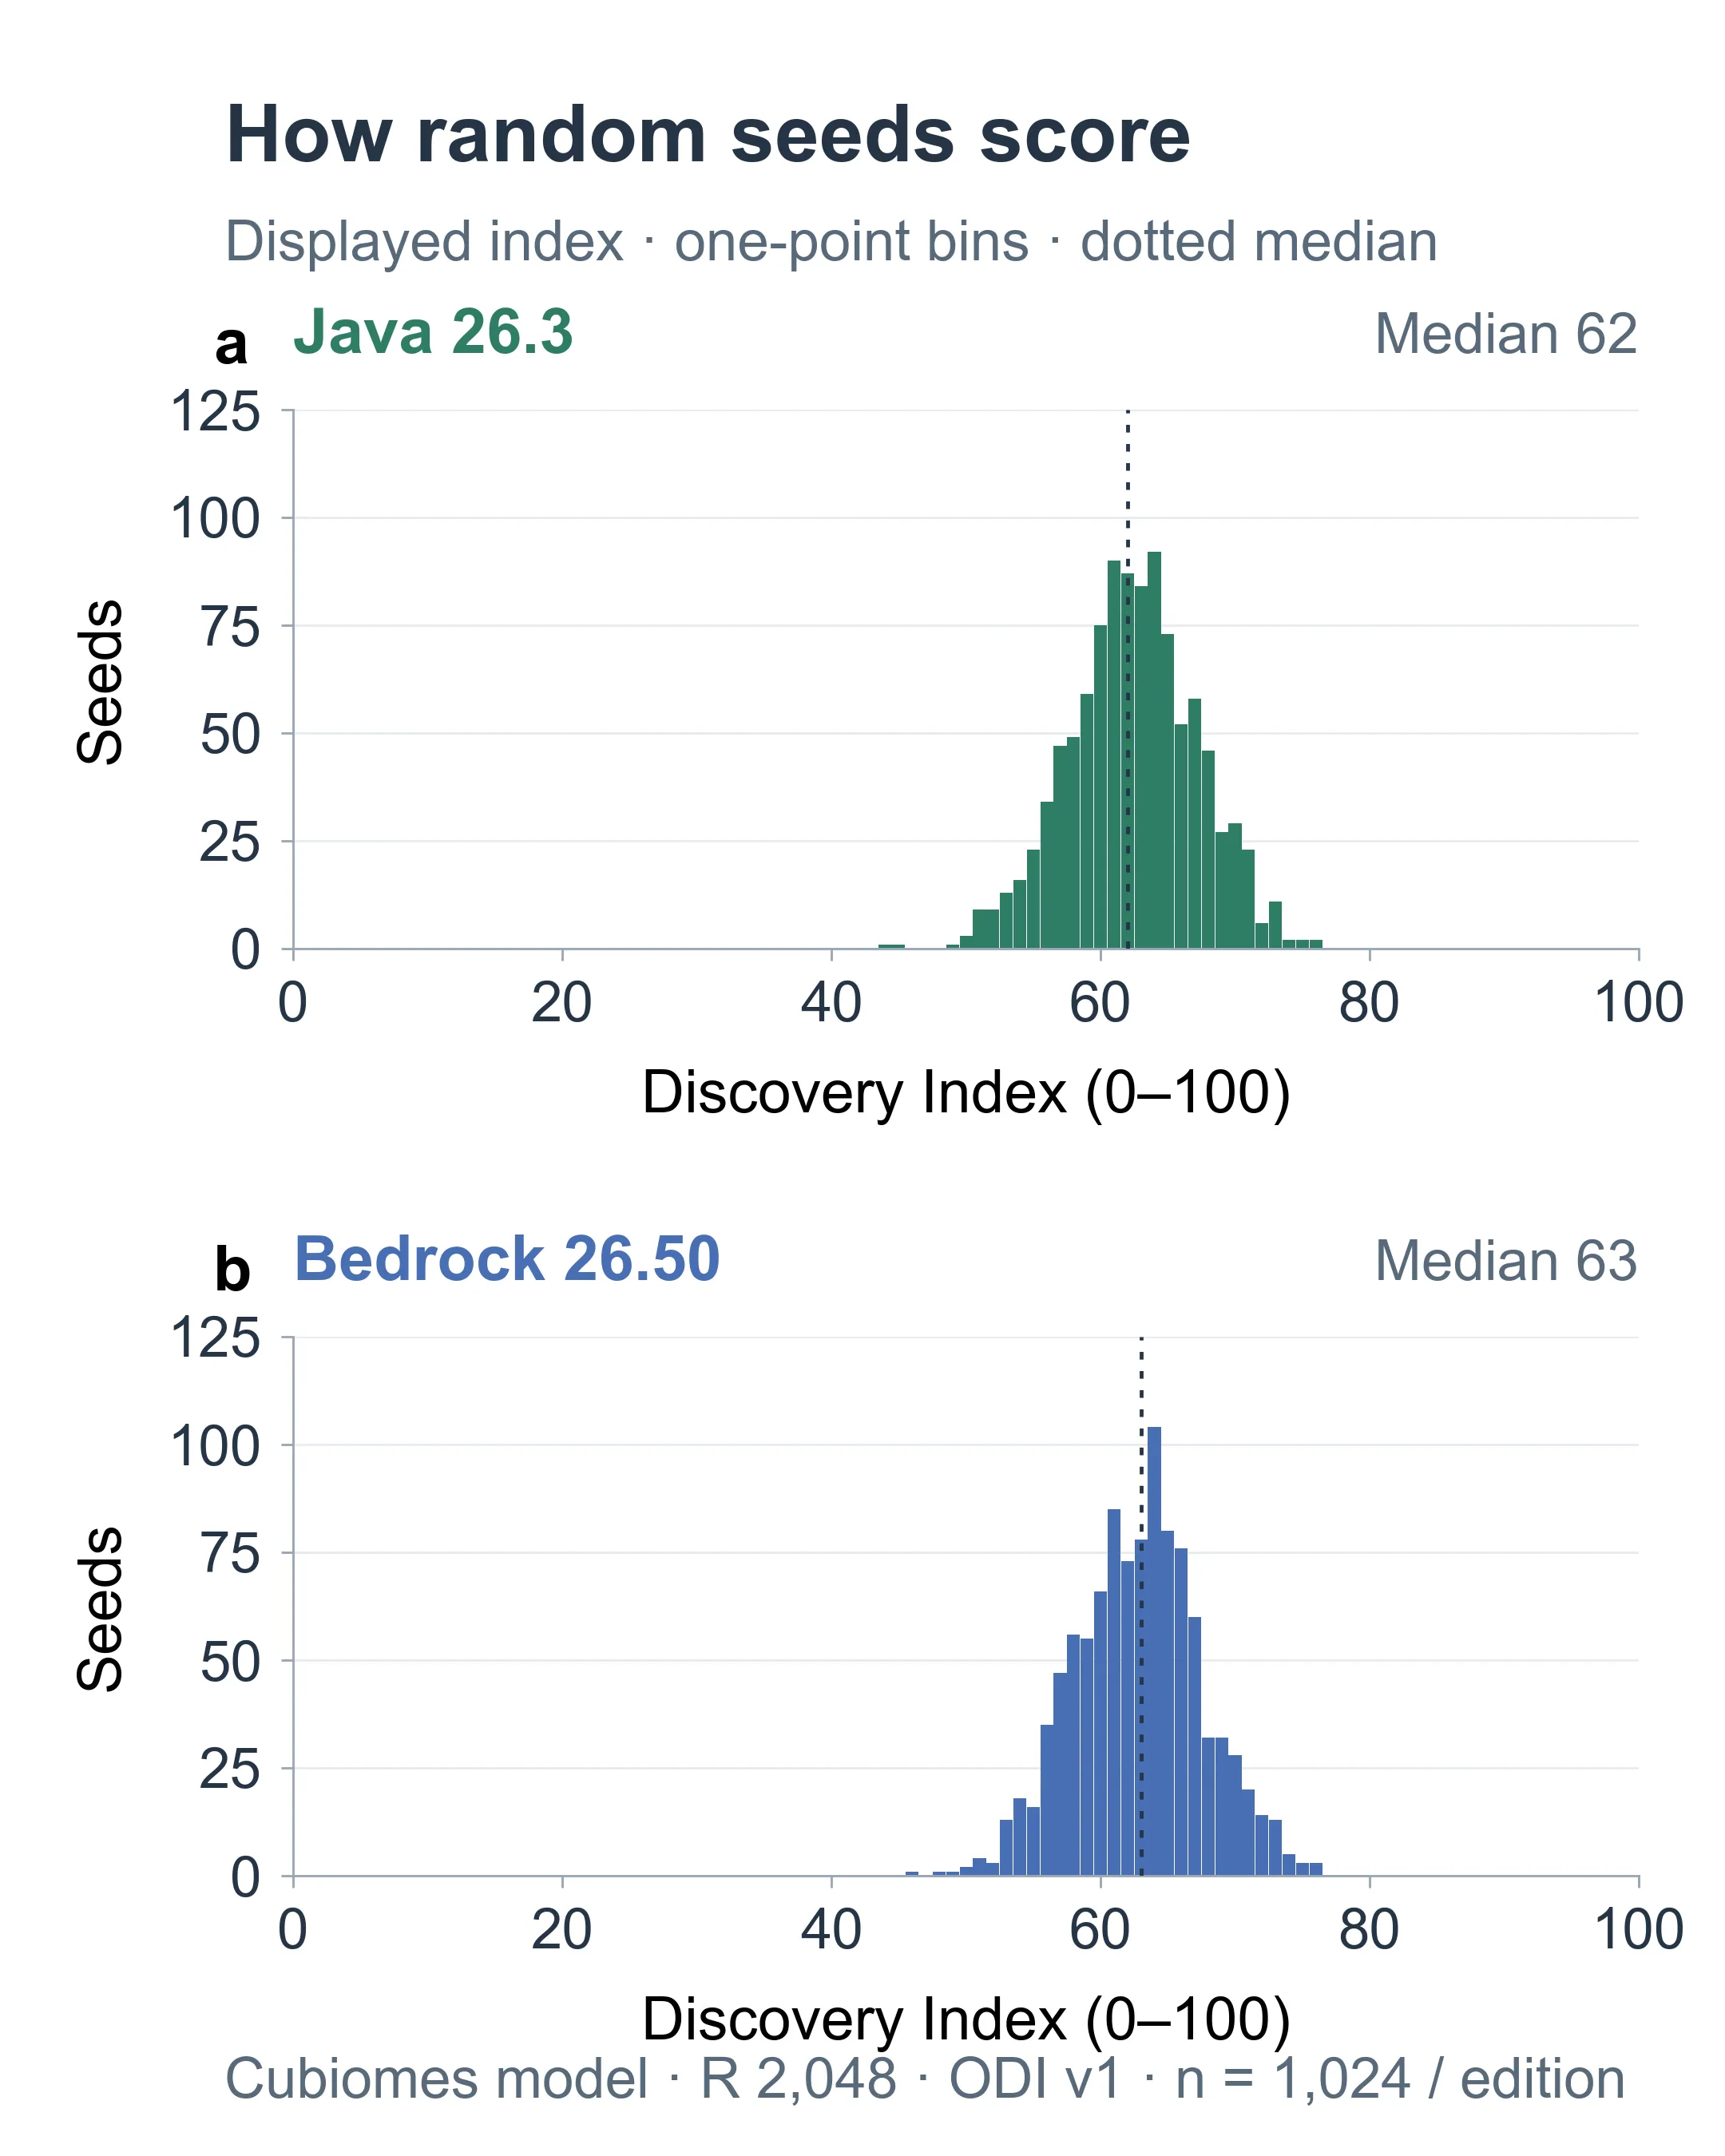
Przewidywania modelu kalkulatora. Każdy wąski słupek zlicza ziarna z jedną wyświetlaną wartością indeksu. Oba panele używają pełnej skali wyników od 0 do 100 i tej samej skali liczby ziaren.
Oś pozioma przedstawia wyświetlany indeks, a oś pionowa liczbę ziaren z próby, które go otrzymały. Wyższe słupki oznaczają częstsze wyniki w kohorcie. Wyniki Java mieszczą się w zakresie od 44 do 76, a wyniki Bedrock od 46 do 76. Ich mediany leżą blisko środka tych zaobserwowanych rozkładów, znacznie poniżej teoretycznego maksimum wynoszącego 100.
Wynik 69 jest zatem wyższy od mediany w każdej z tych odpowiadających sobie prób odniesienia. Podział na biomy i struktury wyjaśnia, które odkrycia dostarczyły tych punktów.
Oddziel różnorodność odkryć od punktacji za odległość
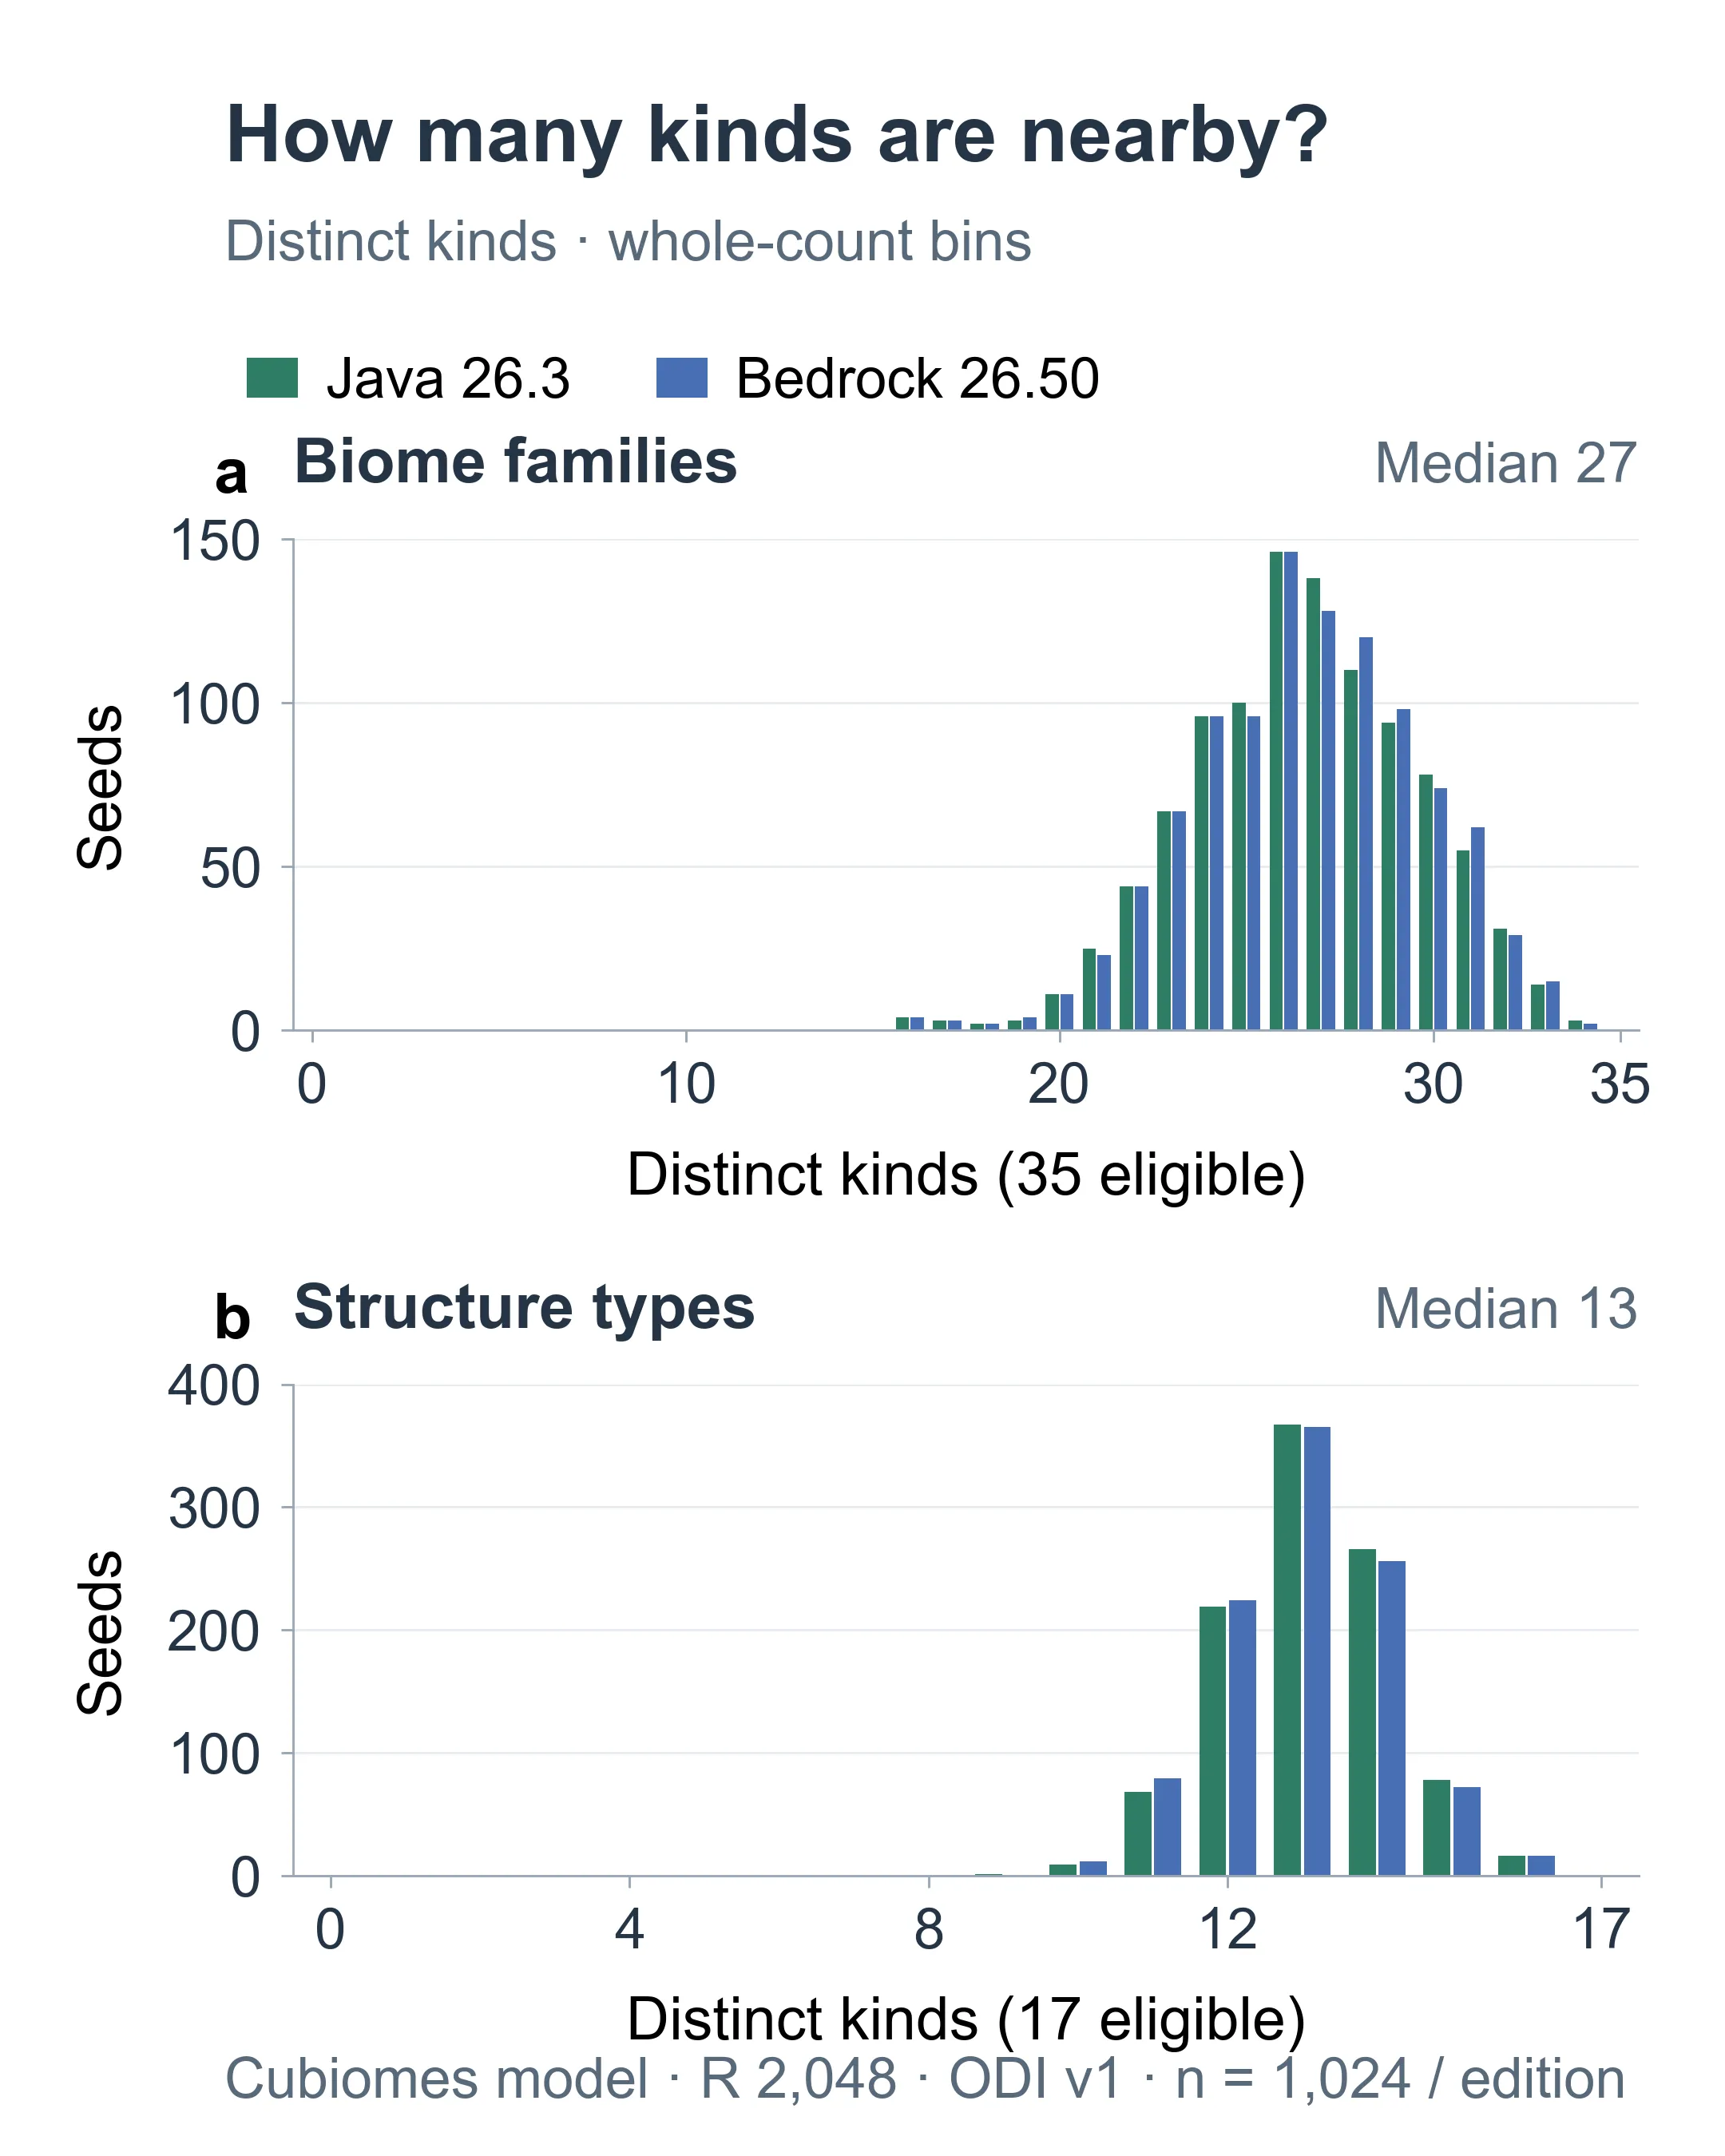
Każdy słupek zlicza ziarna ocenione przez model z określoną liczbą reprezentowanych rodzin lub typów struktur. Uwzględniono rodziny powierzchniowe i jaskiniowe. Te liczby nie są ważone odległością.
Górny panel pokazuje, ile różnych rodzin biomów zidentyfikowano w próbkach wewnątrz koła. Dolny panel pokazuje, dla ilu różnych typów struktur przewidziano wystąpienie w jego obrębie. Odczytuj zielone i niebieskie słupki osobno w każdej grupie odpowiadającej liczbie całkowitej; dodanie ich połączyłoby dwie edycje, których ustawienia odniesienia muszą pozostać odrębne.
W obu edycjach mediana wynosi 27 rodzin zidentyfikowanych w próbkach i 13 przewidywanych typów. Liczba rodzin mieści się w zakresie od 16 do 34 w każdej kohorcie. Liczba przewidywanych typów wynosi od 9 do 16 w edycji Java i od 10 do 16 w edycji Bedrock. Przy tych ustawieniach modelu żaden świat z próby nie reprezentował wszystkich 35 rodzin ani wszystkich 17 typów.
Różnorodność odkryć mówi, ile rodzajów jest reprezentowanych, niezależnie od odległości ich najbliższych próbek lub przewidywanych wystąpień. Końcowy wynik nagradza też bliskość. Dlatego ani liczby 27 rodzin, ani liczby 13 struktur nie należy odczytywać jako wyniku składowej wynoszącego 27 lub 13 na 100.
Przyjrzyj się połowie wyniku dotyczącej biomów
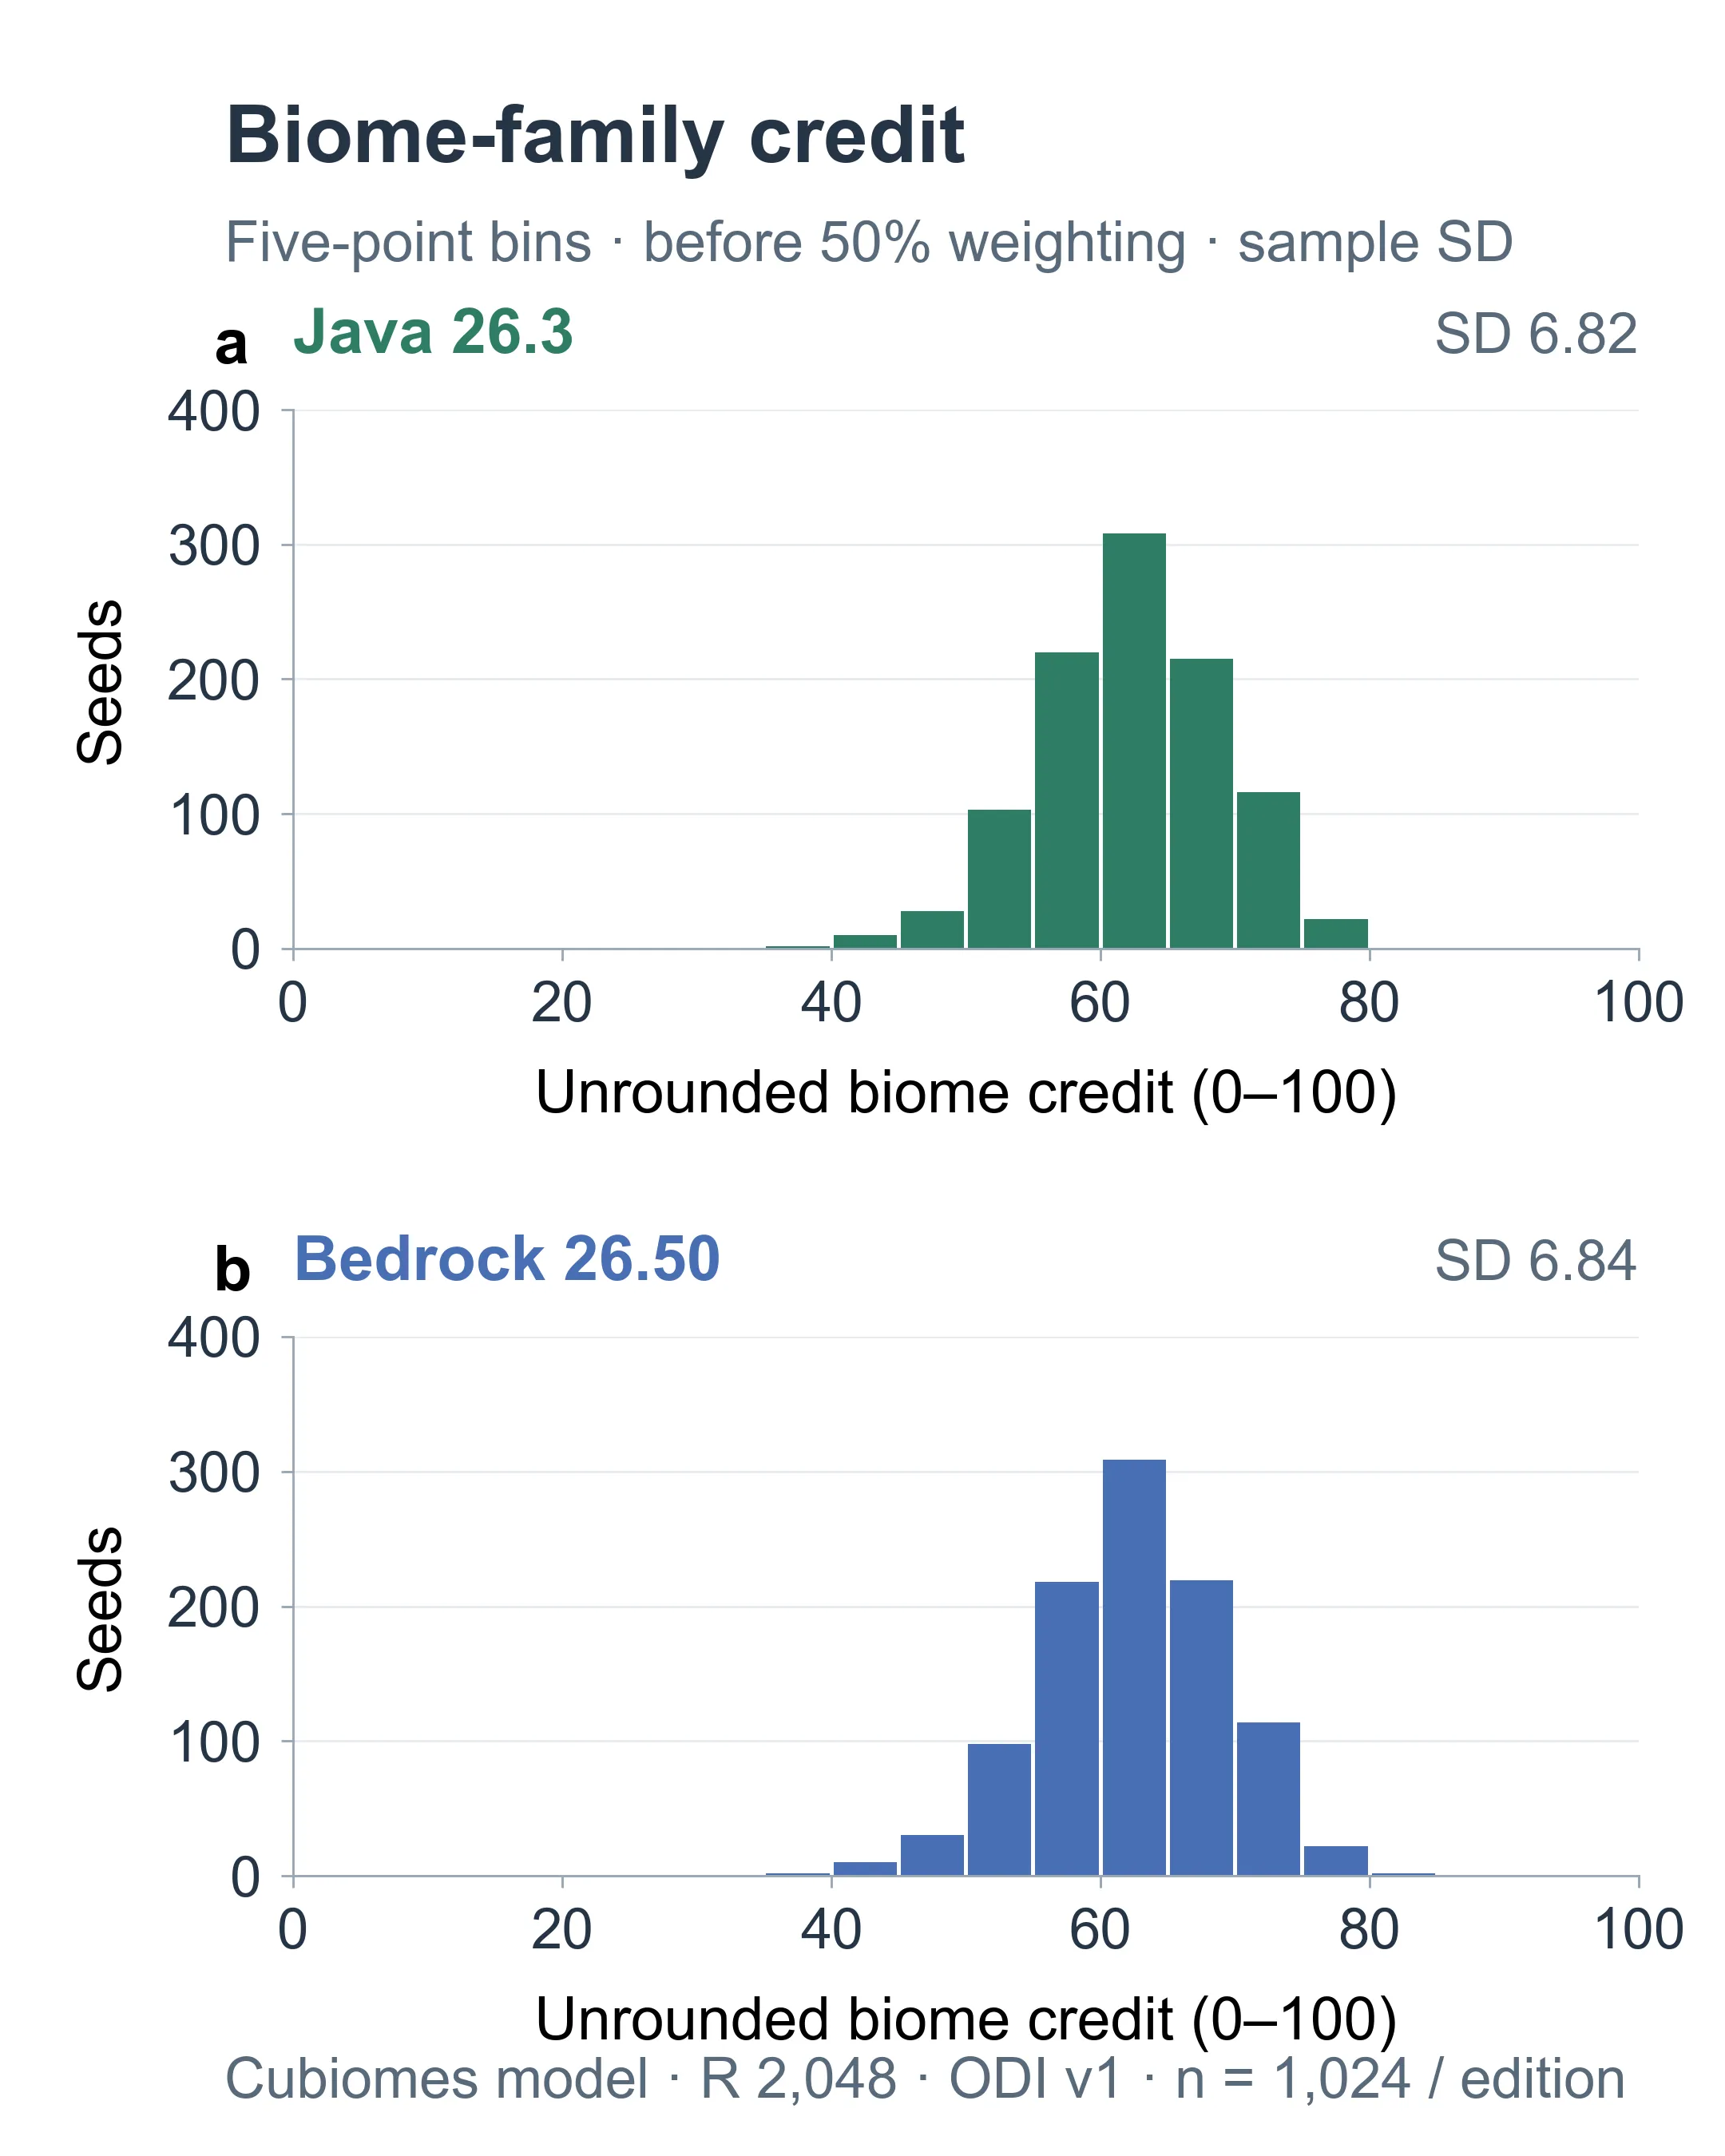
Przewidywania modelu z tej samej sparowanej próby ziaren. Te wartości na osi poziomej to wyniki biomów przed zastosowaniem ich wagi równej połowie w ogólnym indeksie.
Każdy słupek obejmuje przedział o szerokości pięciu punktów, w odróżnieniu od słupków odpowiadających pojedynczym liczbom całkowitym na histogramie ogólnego wyniku. Wynik składowej biomów wynoszący 70 wniósłby 35 punktów do indeksu przed końcowym zaokrągleniem. Oznacza to, że średnia punktacja za odległość wśród kwalifikujących się rodzin wynosi 0.70; nie oznacza to, że zbadano 70 rodzin lub 70% koła.
Rozkłady wyników za biomy są w tych próbach bardziej rozproszone niż przedstawione poniżej rozkłady wyników za struktury. Ich odchylenia standardowe w próbie wynoszą około 6.82 punktu w Java i 6.84 w Bedrock. NIST opisuje odchylenie standardowe jako miarę rozproszenia wokół średniej z próby, wyrażoną w pierwotnych jednostkach. Tutaj jednostkami są punkty wyniku składowej. Opisuje ono zróżnicowanie wyników ziaren, a nie margines błędu średniej. Oba rozkłady wyników za biomy wykazują też statystycznie wykrywalne odstępstwo od kształtu rozkładu normalnego w naszym teście diagnostycznym po zastosowaniu korekty na wielokrotne testowanie.
Liczba rodzin i odległości wspólnie odpowiadają za to rozproszenie. Histogram nie wskazuje, której rodziny brakuje w konkretnym ziarnie; na to pytanie odpowiadają ikony i szczegóły współrzędnych w kalkulatorze.
Przyjrzyj się połowie dotyczącej struktur
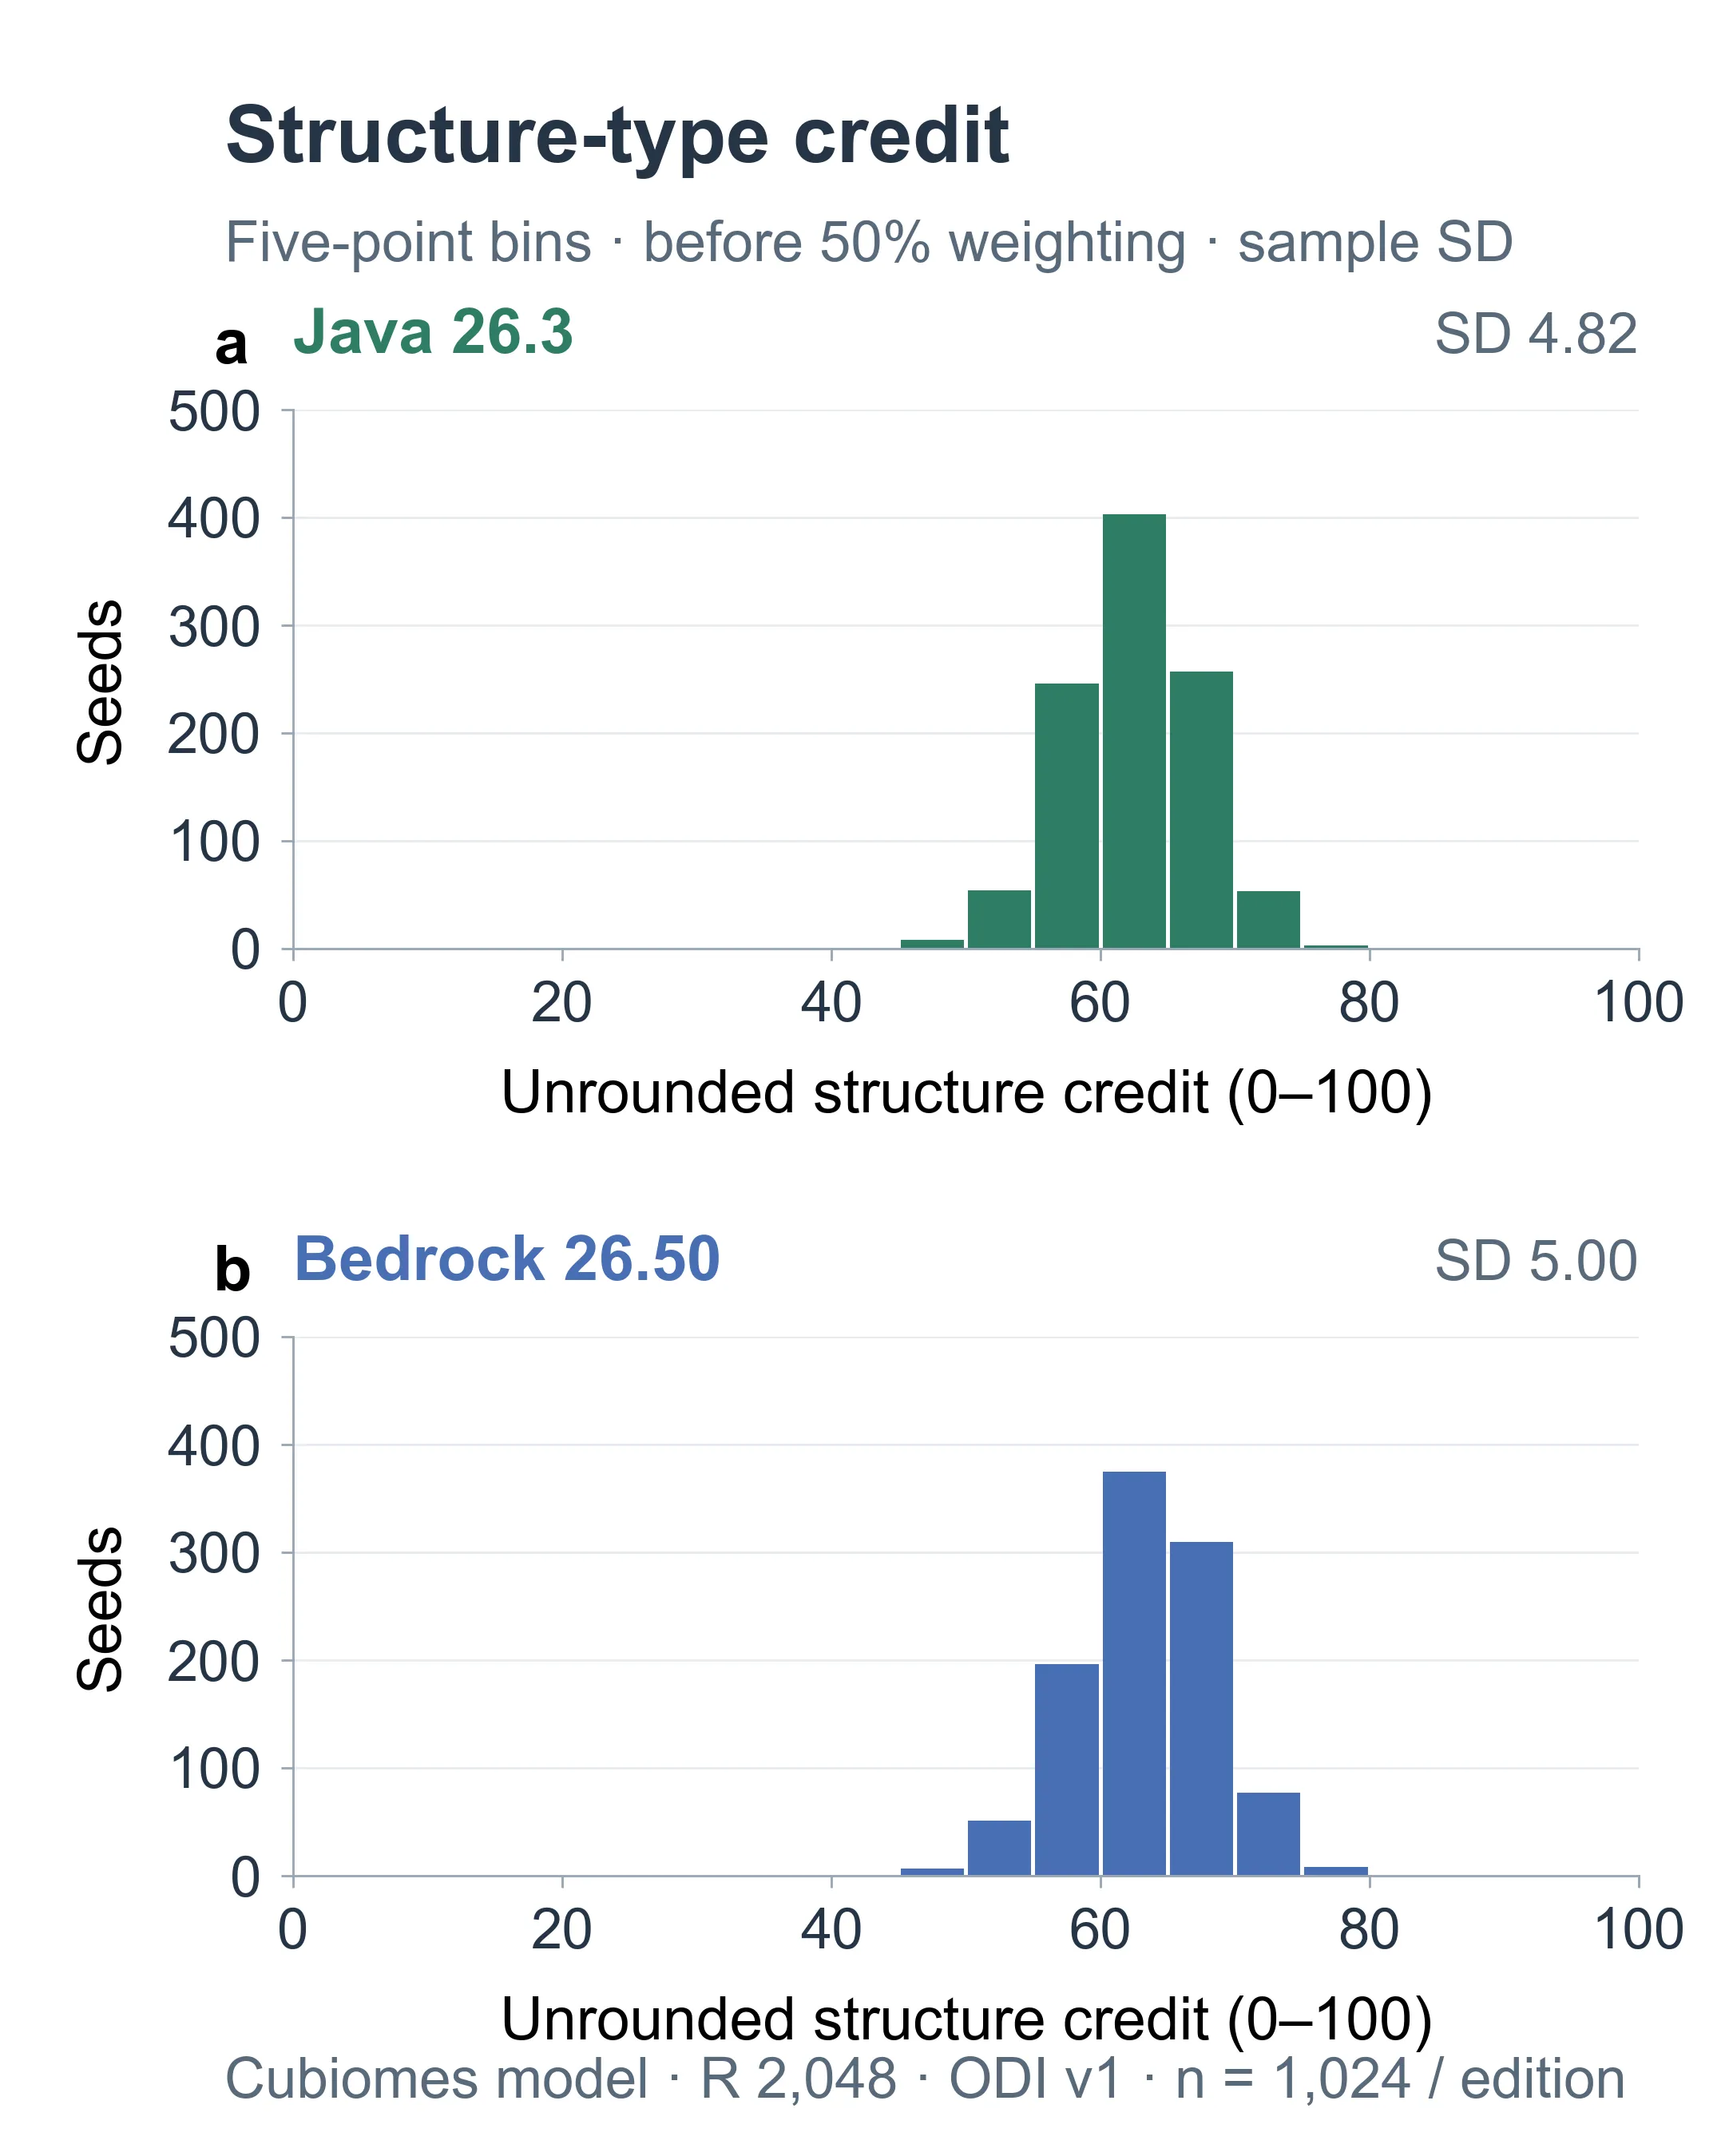
Każdy modelowany typ struktury wnosi wkład do wyniku raz, poprzez najbliższą przewidywaną lokalizację. Wykres nie zlicza wszystkich struktur w świecie.
Osie i przedziały o szerokości pięciu punktów mają takie samo znaczenie jak na wykresie składowej dotyczącej biomów, więc można porównywać ich rozproszenie w poziomie. Każdy wykres ma własną podziałkę liczby ziaren na osi pionowej. Odchylenia standardowe w próbie wynoszą około 4.82 punktu dla Java i 5.00 dla Bedrock i są mniejsze niż dla składowej dotyczącej biomów. Nasz test normalności z korektą nie odrzucił hipotezy o normalności żadnego z rozkładów składowej dotyczącej struktur.
Połowa dotycząca struktur łączy liczbę reprezentowanych typów z bliskością w poziomie. Dodatkowe wioski tego samego typu nie dodają punktów za różnorodność, a pobliska przewidywana twierdza nie otrzymuje żadnej dodatkowej korekty uwzględniającej trud dotarcia do niej pod ziemią. Są to właściwości tych zasad punktacji, a nie ustalenia dotyczące trudności tych światów.
Łączny indeks jest średnią tych dwóch różnych wyników składowych, obliczaną przed zaokrągleniem. Jego rozkład może różnić się od rozkładu każdej z połówek. W tych kohortach rozkład wyników łącznych ma kształt zbliżony do dzwonu, mimo że składowa dotycząca biomów odbiega od rozkładu normalnego. Oceniamy wynik łączny bezpośrednio; połączenie dwóch wyników nie ustanawia ogólnej reguły dla każdej wersji czy każdego promienia.
Sprawdź ogony rozkładu za pomocą wykresu Q-Q dla rozkładu normalnego
Histogram pomaga zobaczyć, w jakich przedziałach mieści się większość wyników, ale jego przedziały mogą ukrywać mniejsze różnice w kształcie rozkładu. Wykres Q-Q dla rozkładu normalnego porównuje uporządkowane niezaokrąglone wyniki z wynikami oczekiwanymi w rozkładzie normalnym, z wykorzystaniem zaobserwowanej średniej i odchylenia standardowego z próby dla każdej kohorty. Objaśnienie wykresów prawdopodobieństwa normalnego autorstwa NIST opisuje, jak odchylenia od prostej linii odniesienia ujawniają różnice względem kształtu rozkładu normalnego.
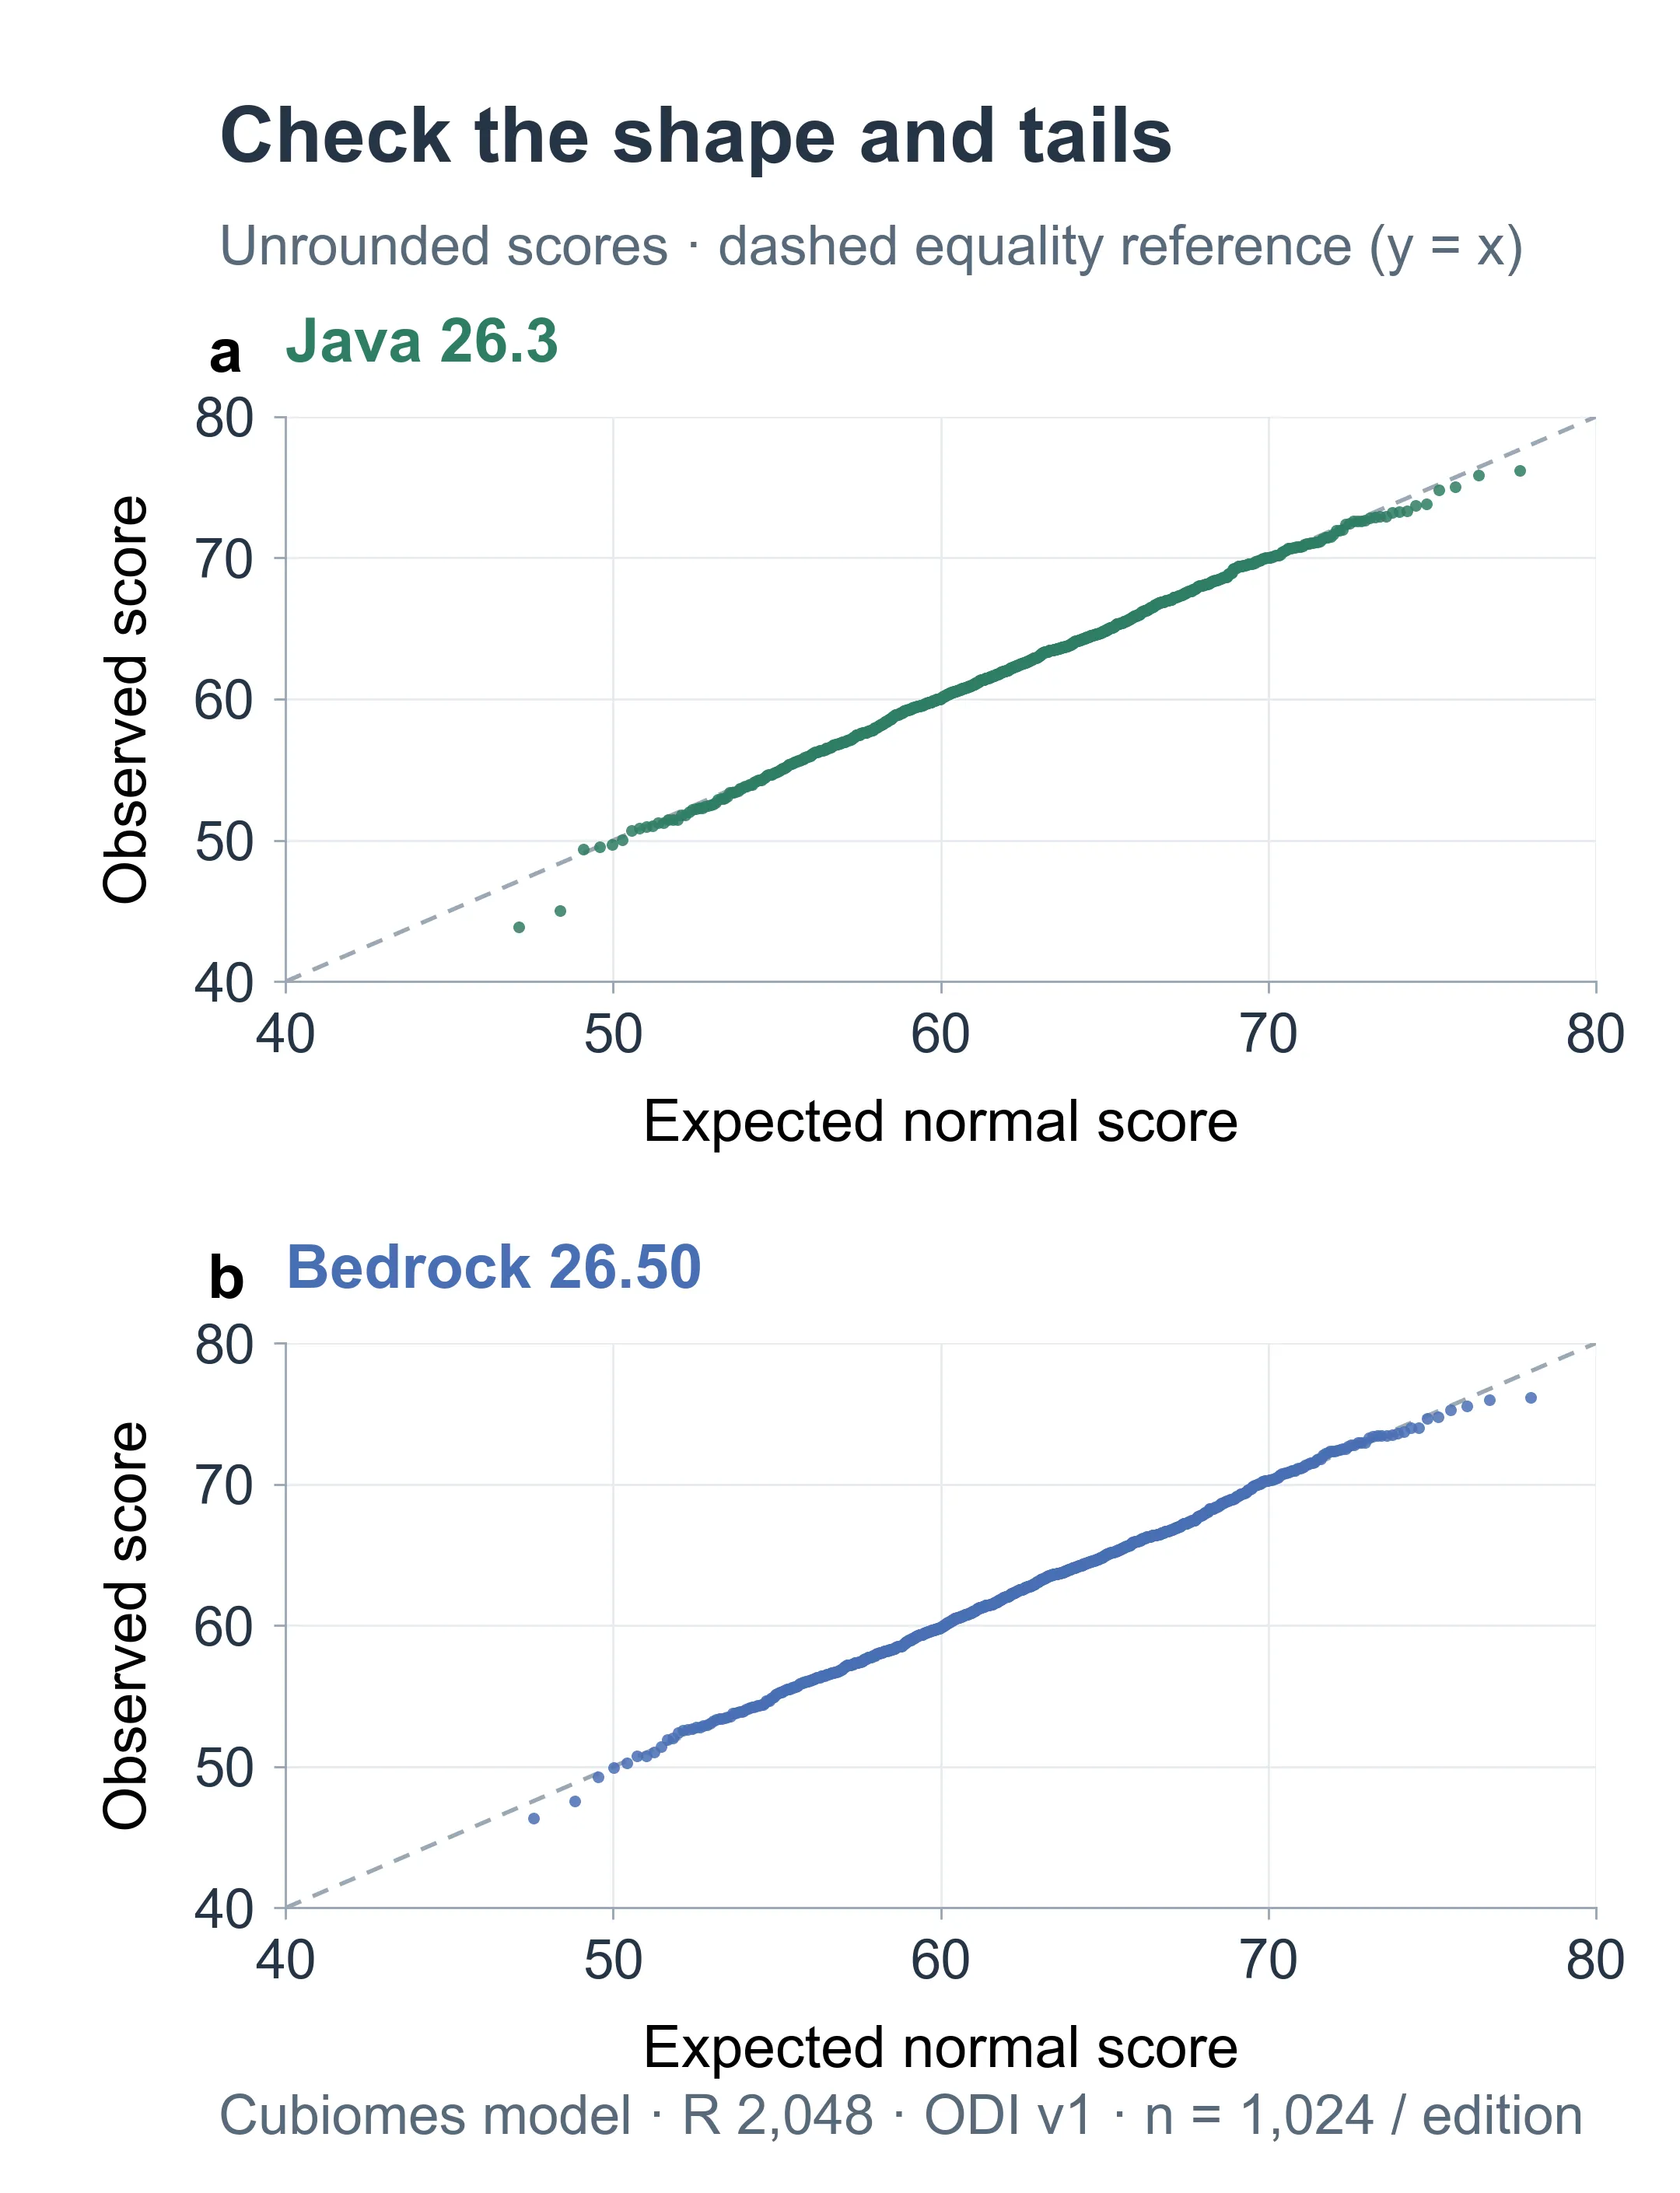
Każdy panel zawiera wszystkie 1024 niezaokrąglone wyniki łączne. Oczekiwane wyniki z rozkładu normalnego wykorzystują średnią i odchylenie standardowe z próby; szara przekątna oznacza równe wartości oczekiwane i zaobserwowane. Nie jest to pas ufności.
Obie osie używają punktów indeksu. Punkt na przekątnej ma zaobserwowany wynik równy wynikowi oczekiwanemu na tej pozycji w porównaniu z rozkładem normalnym. Punkty powyżej niej mają wyższe zaobserwowane wyniki, a punkty poniżej — niższe. Punkty najbardziej na lewo i najbardziej na prawo reprezentują dolny i górny ogon rozkładu w próbie.
Większość punktów leży blisko przekątnej, z odchyleniami na krańcach. Te skrajne punkty mają znaczenie, gdy pytanie dotyczy wyjątkowo niskich lub wysokich wyników. Dobre dopasowanie w środku nie zapewnia wiarygodnego oszacowania na podstawie krzywej normalnej dla bardzo rzadkiego wyniku poza zaobserwowanym zakresem.
Co ustala test normalności
Zastosowaliśmy test Shapiro-Wilka opisany w dokumentacji SciPy do niezaokrąglonego wyniku łącznego i obu niezaokrąglonych składowych w każdej edycji. Użycie niezaokrąglonych wartości pozwala uniknąć traktowania powtarzających się całkowitych wartości wyświetlanego wyniku jako pomiarów ciągłych. Zastosowaliśmy próg 0.05 i korektę Holma dla tych sześciu testów.
| Badany rozkład | Java 26.3 — skorygowana wartość p | Bedrock 26.50 — skorygowana wartość p | Wynik przy progu 0.05 |
|---|---|---|---|
| Łączny indeks | 0.667 | 0.667 | Nie wykryto odstępstwa |
| Składowa dotycząca biomów | 0.0059 | 0.0059 | Wykryto odstępstwo |
| Składowa dotycząca struktur | 0.231 | 0.472 | Nie wykryto odstępstwa |
Nieskorygowane wartości p w testach wyniku łącznego wyniosły 0.334 dla Java i 0.660 dla Bedrock. Brak odrzucenia hipotezy o normalności jest zgodny z kształtami zbliżonymi do dzwonu w tych konkretnych próbach. Nie dowodzi to normalności, nie potwierdza poprawności modeli generowania ani nie określa prawdopodobieństwa, że gra w danym świecie będzie przyjemna.
Wyniki pozostają ograniczone do zakresu od 0 do 100. Do porównywania ziaren używamy rzeczywistych zaobserwowanych częstości, bez przeliczania wyniku za pomocą dopasowanej krzywej normalnej. Testy i wykresy opisują te dwie kohorty; inne edycje, wersje, promienie lub przyszłe zmiany zasad punktacji wymagają osobnej oceny.
Pełne podsumowanie statystyczne i wszystkie wyniki modelu z próby zawierają pomiary stojące za tymi wykresami. Pięć wykresów rozkładu wykorzystuje tę samą próbę sparowaną; wykres punktacji za odległość ilustruje wzór.
Umieść pojedynczy wynik w kontekście
Dla przykładowego ziarna ziarno Java 26.3 12345 kalkulator przewiduje wynik 69, przy objęciu próbkowaniem 30 z 35 rodzin i przewidywanej obecności 14 z 17 typów struktur. Takie liczby uwzględnionych rodzin i typów dają około 84 możliwych punktów przed odliczeniami za odległość: 50 × 30 / 35 + 50 × 14 / 17 ≈ 84. Odległości do najbliższych elementów obniżają ten wynik do wyświetlanej wartości 69. W dopasowanej próbie odniesienia 922 wyniki były niższe, 27 było takich samych, a 75 było wyższych.
Remisy w wynikach mają znaczenie. Każda wyświetlana wartość 69 oznacza zaokrąglony wynik, który mogą dać różne kombinacje punktów za biomy i struktury. Dokładne liczby niższych, równych i wyższych wyświetlanych wyników zachowują te remisy. Wyjaśniają też porównanie bardziej bezpośrednio niż przypisywanie bez wyjaśnienia każdemu ziarnu z takim samym wynikiem tego samego szacowanego percentyla rozkładu normalnego.
Kalkulator pokazuje zaobserwowany histogram, medianę próby, zakres od P10 do P90 oraz liczby wyników niższych od twojego, równych twojemu i wyższych od twojego, gdy edycja, wersja, promień, zasady punktacji i model generowania są dokładnie zgodne. Dla innych ustawień nadal otrzymujesz zestawienie odkryć; obecnie nie ma dla nich dopasowanej próby odniesienia.
Częstość występowania również wymaga własnego mianownika. W grupie ziaren Java 26.3 przy tym promieniu model wykrył w próbkowaniu rodzinę mushroom-fields w 294 z 1024 ziaren (28.7%) i przewidział leśny dwór w 158 (15.4%). Chodzi o wystąpienia gdzieś wewnątrz koła wokół szacowanego punktu odrodzenia, a nie o prawdopodobieństwo odrodzenia się w tym biomie czy miarę jego powierzchni w całym świecie.
Histogram wyników łącznych odpowiada na pytanie, jak często kalkulator uzyskiwał określone sumy w tej próbie. Kryterium z wagami zależnymi od rzadkości dotyczyłoby innego pytania: częstości występowania poszczególnych rodzin lub typów struktur. Wersja 1 zasad zachowuje równe wagi w obrębie każdej kategorii; tych pomiarów nie przekształcono w premie za rzadkość. Taka zmiana wymagałaby wartości odniesienia dla częstości występowania dopasowanych do edycji, wersji generowania, promienia i zasad próbkowania, a także nowej, sprawdzonej wersji zasad punktacji.
To próba odniesienia złożona z przewidywań modelu, a nie percentyl rzadkości w całej populacji, próba światów, w których grano, ani pomiar odległości pokonywanych przez graczy. Wynik 80 nie oznacza, że ziarno jest bardziej zróżnicowane niż 80% wszystkich ziaren. Użyj kalkulatora, aby porównać modelowane odkrycia na obszarze, który zamierzasz eksplorować, a następnie obejrzyj na mapie ziarna miejsca, które są dla ciebie ważne.