seedlookout
Un indice d’expérience des graines Minecraft peut aider à répondre à une question pratique : combien de terrains différents et de types de destinations cette graine offre-t-elle dans la zone que je veux explorer ?
Notre calculateur d’expérience des graines appelle ce score l’Indice de découverte du Monde normal. Il combine les familles de biomes échantillonnées et les types de structures prédits en un score de 0 à 100, avec davantage de crédit pour les découvertes proches du point d’apparition estimé. Vous choisissez l’édition, la version de génération et le rayon. Le score décrit la diversité modélisée ; vos préférences déterminent toujours si vous voulez y jouer.
Nous avons examiné 1 024 graines pseudo-aléatoires dans chacun de deux modèles de génération. Avec un rayon de 2 048 blocs, l’indice affiché médian était de 62 dans Java 26.3 et de 63 dans Bedrock 26.50. Le plafond mathématique de 100 de la grille est une quantité différente du centre de cet échantillon. Les graphiques ci-dessous montrent comment situer un score sans en faire une note de plaisir de jeu.
Choisissez un rayon d’exploration
Le calculateur propose des rayons de 512, 1 024, 2 048 et 4 096 blocs. Chacun forme un cercle mesuré horizontalement depuis le point d’apparition estimé du monde. Un rayon de 2 048 blocs atteint cette distance dans chaque direction ; il ne signifie pas qu’une marche de 2 048 blocs permet de visiter tout son contenu.
Nous utilisons 2 048 blocs par défaut, car l’outil a besoin d’une zone de départ. Nous n’avons pas calibré ce choix sur une mesure représentative de la distance explorée par les joueurs Minecraft. Le guide d’exploration de Mojang décrit aussi bien de courts trajets que de grandes aventures, sans donner de rayon moyen.
Choisissez le rayon adapté au monde souhaité. Un petit cercle interroge la diversité proche. Un cercle plus grand inclut davantage de destinations possibles et donne plus de crédit de distance à la même découverte proche. Comparez deux graines avec le même rayon pour conserver une question cohérente.
Le rayon change donc deux choses : la zone explorée par la recherche et le crédit attribué à une distance donnée. Une prédiction à 1 024 blocs du point d’apparition reçoit un crédit de 0,75 avec un rayon de 2 048, mais de 0,875 avec un rayon de 4 096. Un score peut augmenter avec un rayon plus grand avant même qu’un autre type soit trouvé. Cette hausse répond à une question d’exploration plus large ; elle n’établit pas que la graine elle-même s’est améliorée.
Comptez des expériences différentes
Un décompte brut de biomes peut donner plusieurs points à des terrains très proches. Le calculateur garde ces identifiants bruts visibles, mais regroupe les variantes apparentées pour le score. Les Plaines et les Plaines de tournesols partagent une famille. L’Océan et l’Océan profond en partagent une autre. La Forêt fleurie possède sa propre famille ; les familles de grottes comptent aussi séparément.
Ces familles sont nos définitions éditoriales. L’outil ne note pas l’accomplissement des progrès. Chaque famille admissible possède le même poids dans la partie biomes du score. Une famille est admissible uniquement si le catalogue de versions du modèle de génération sélectionné contient l’un de ses membres.
Pour le terrain de surface, le calculateur échantillonne une grille de 32 blocs à la hauteur approximative de la surface. Si cette hauteur renvoie un biome de grotte, il exclut cet échantillon du décompte de surface. Des zones étroites peuvent se trouver entre les points de la grille ; le décompte brut est donc le nombre d’identifiants de biomes échantillonnés, pas un inventaire exhaustif.
L’échantillonnage des grottes utilise une grille de 64 blocs aux Y -48, -32, -16, 0, 16, 32 and 48, en conservant les points situés au moins huit blocs sous la surface approximative. Ces échantillons identifient des régions de biomes de grottes. Un point peut se trouver dans un terrain solide : il ne prouve donc pas qu’une grotte accessible existe à ces coordonnées. Les déplacements verticaux et l’effort d’excavation ne reçoivent aucune pénalité de distance dans cette première grille.
Les structures contribuent par type : les villages comptent une fois, quel que soit le nombre de villages prédits dans le cercle. Un village et une épave ajoutent deux types différents. Le calculateur cherche la prédiction la plus proche de chaque type admissible, y compris les destinations souterraines lorsque les critères de la version les prennent en charge.
Les mines abandonnées sont exclues de tous les profils, car l’outil disponible pour trouver la plus proche ne peut pas établir la couverture pour tous les rayons proposés. Le score mesure donc les critères répertoriés, pas toutes les destinations possibles du Monde normal.
Accordez plus de crédit aux découvertes proches
Pour chaque famille ou type de structure trouvé, la distance horizontale détermine le crédit :
credit = 1 − 0.5 × distance / radius
Une découverte au point d’apparition reçoit 1. À la moitié du rayon, elle reçoit 0,75, et à la limite 0,5. Un critère non trouvé reçoit 0. La moyenne de chaque catégorie inclut tous les critères admissibles dans son dénominateur, y compris ceux qui n’ont pas été trouvés.
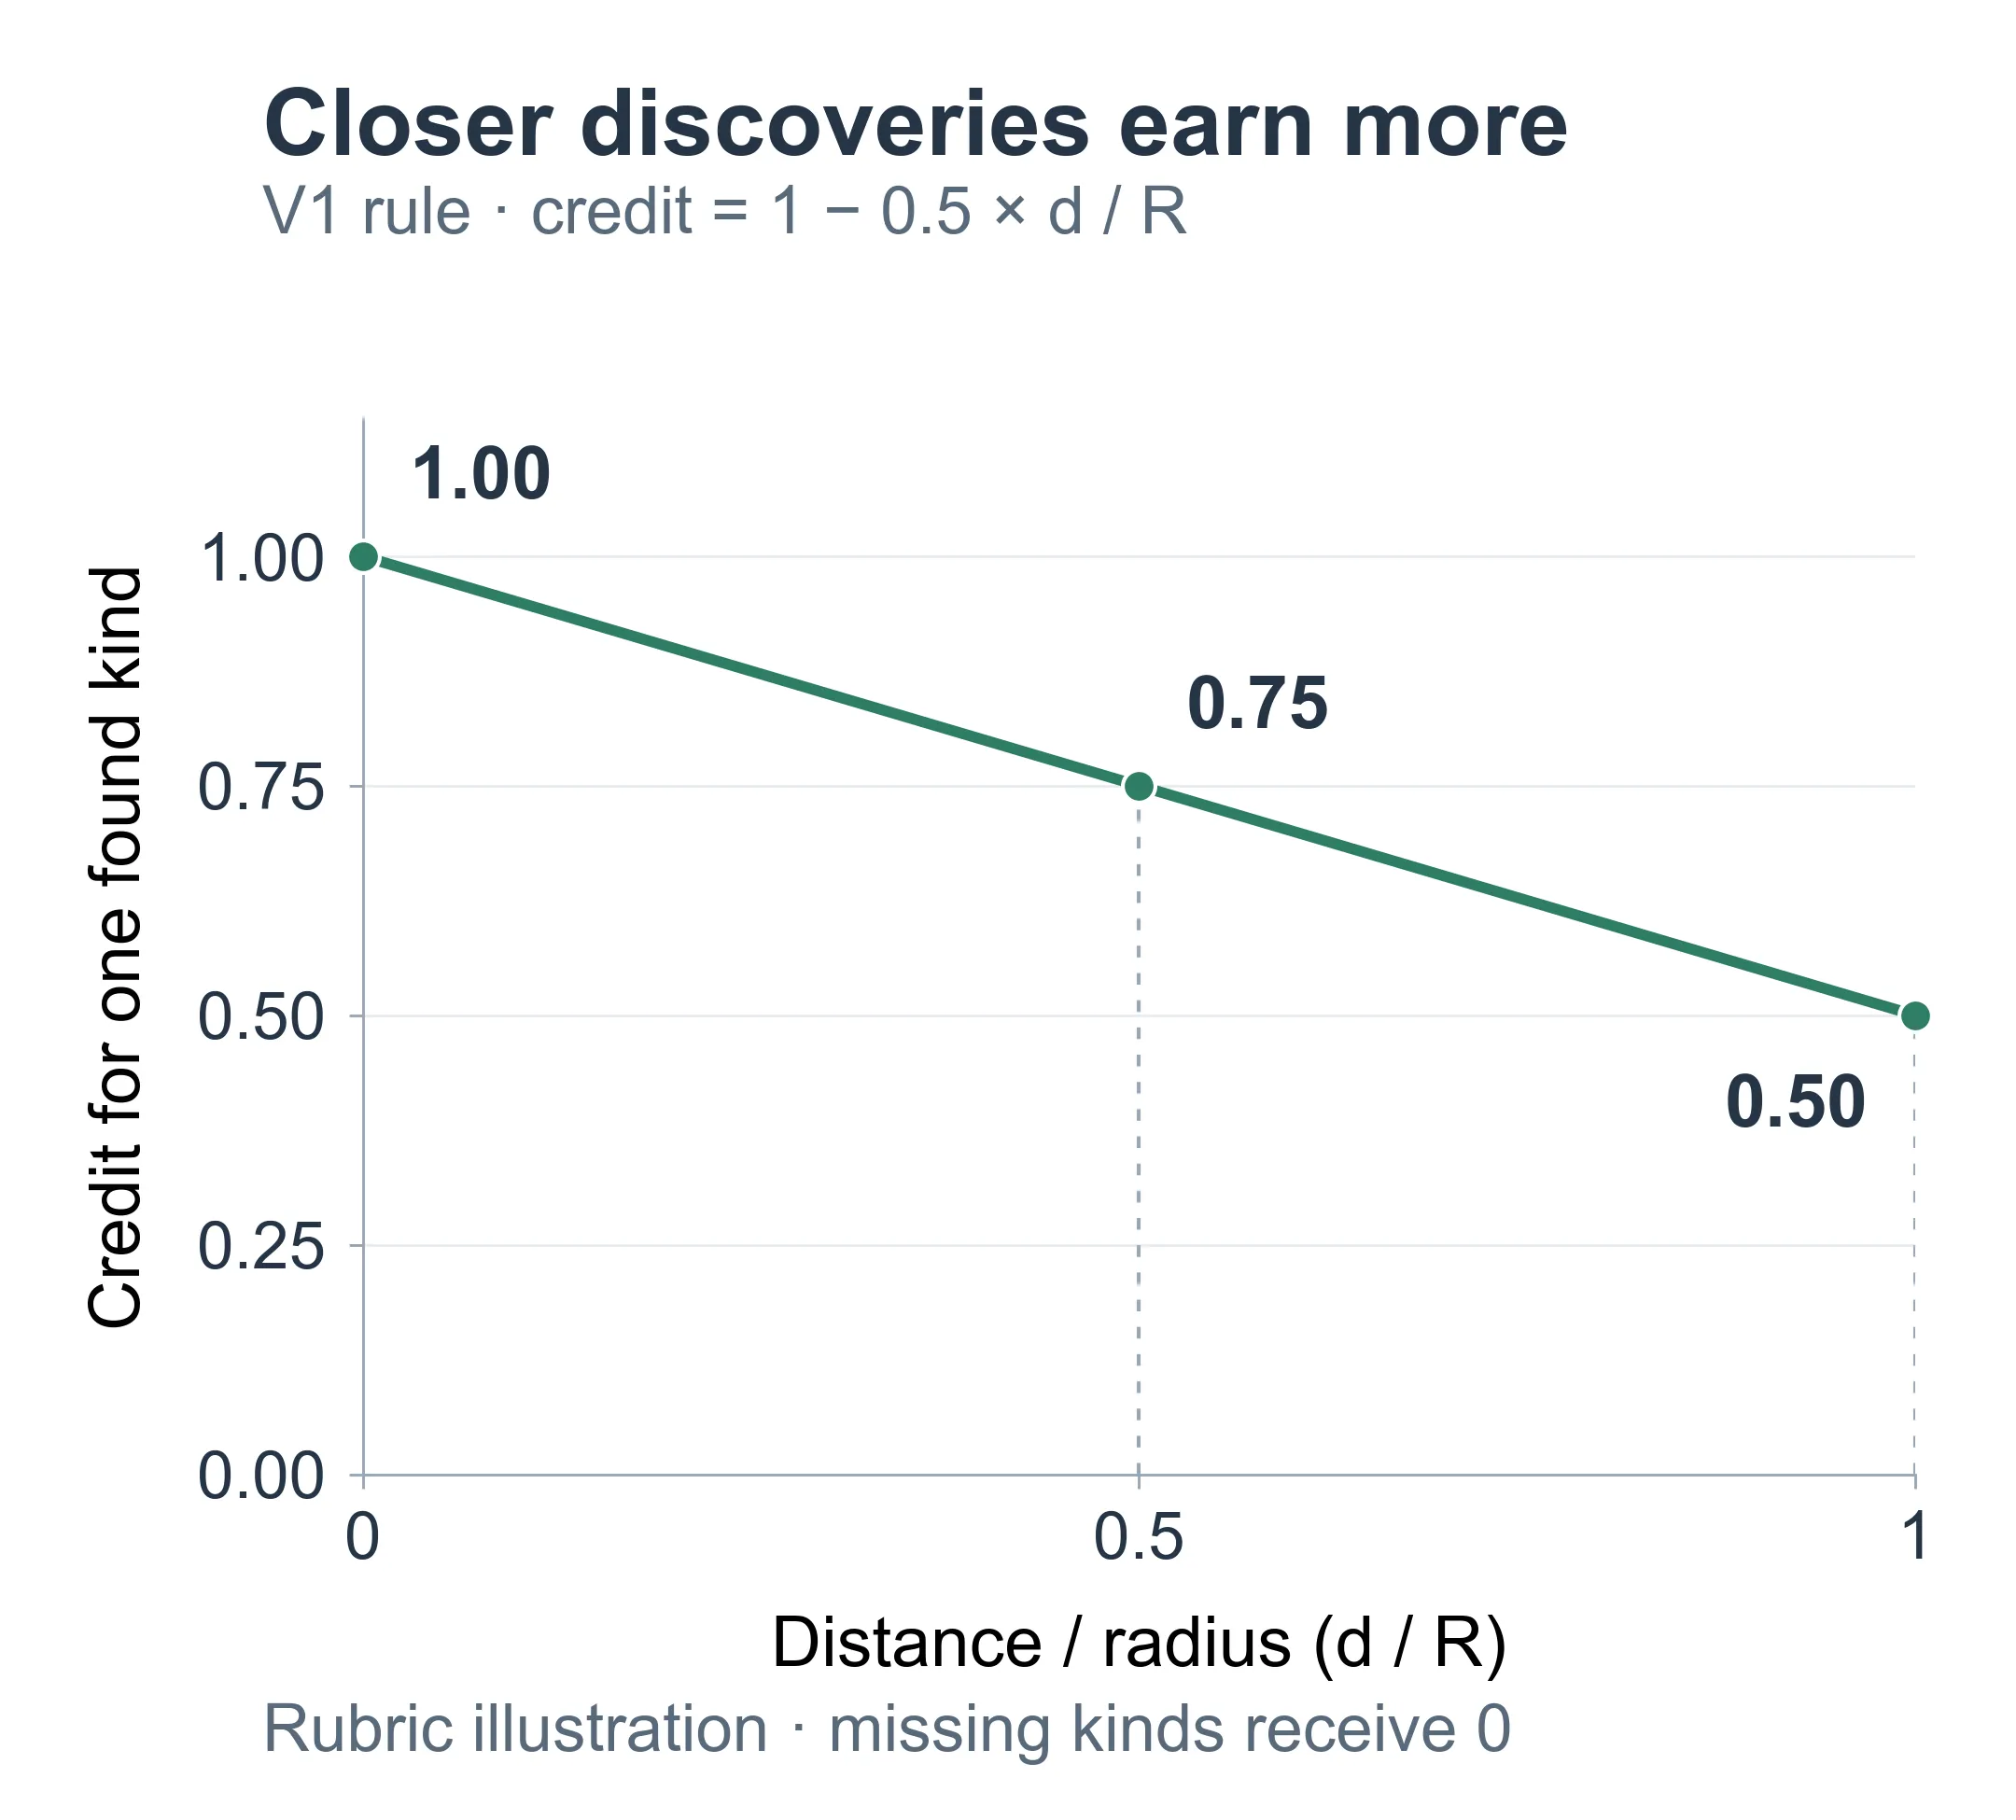
Illustration de la grille, pas un échantillon de mondes. L’axe horizontal divise la distance par le rayon choisi ; l’axe vertical montre le crédit d’un critère trouvé.
Le calcul final donne le même poids aux deux catégories :
index = round(100 × (0.5 × biome average + 0.5 × structure average))
Dans les profils Java 26.3 et Bedrock 26.50, les biomes peuvent rapporter jusqu’à 50 points répartis sur 35 familles, et les structures jusqu’à 50 points répartis sur 17 types. Une famille peut contribuer environ 50 / 35 = 1.43 point d’indice avant arrondi ; un type de structure environ 50 / 17 = 2.94. Les deux contributions diminuent avec la distance. Réunir les 52 critères dans une seule liste à poids égaux donnerait davantage d’influence aux biomes ; les deux moitiés gardent leurs poids totaux égaux.
Voici un exemple hypothétique pour montrer le calcul, pas le résultat d’une graine particulière :
| Catégorie | Crédits pour ses critères admissibles | Moyenne |
|---|---|---|
| Quatre familles de biomes | 1; 0,75; 0,5; 0 | 0,5625 |
| Trois types de structures | 0,75; 0; 0 | 0,25 |
L’indice est round(100 × (0.5 × 0.5625 + 0.5 × 0.25)) = 41.
Le regroupement, l’égalité des poids des catégories et le demi-crédit à la limite sont des choix de la révision 1. Nous ne les avons pas ajustés à une enquête sur ce que les joueurs apprécient. Une famille ou un type de structure ne reçoit pas automatiquement plus de crédit parce qu’il apparaît moins souvent dans l’échantillon de référence.
L’outil distingue aussi une recherche terminée sans prédiction d’une recherche incomplète. Lorsque les limites de couverture des structures laissent un type inconnu, le score global n’est pas affiché. Une couverture inconnue ne compte ni comme une découverte réussie ni comme un type absent.
Partagez le code de calcul, examinez les critères par version
La prise en charge des versions Minecraft nécessite deux décisions distinctes : le modèle de génération à utiliser et les critères de calcul applicables.
Le calculateur partage un même cœur d’échantillonnage et de calcul du score. Java et Bedrock utilisent les modèles de génération propres à chaque édition déjà présents sur le site. Un registre explicite associe chaque version de génération prise en charge à ses critères de calcul. Les versions peuvent partager une même recette de critères lorsque les règles sont identiques ; elles n’ont pas besoin de copies distinctes du moteur du calculateur.
Les critères déterminent les types de structures admissibles, l’espacement de l’échantillonnage, les profondeurs des grottes, les poids des catégories et le crédit de distance. Le catalogue des biomes provient de la version du modèle sélectionné et est comparé aux définitions de familles examinées. Un nom de biome inconnu ou une version non prise en charge arrête le calcul jusqu’à l’examen de ses critères.
Par exemple, le profil Java 1.18.2 actuel possède 29 familles de biomes admissibles et 13 types de structures. Java 26.3 possède 35 familles et 17 types. Ce sont les dénominateurs du calculateur, pas les décomptes d’une graine particulière. L’ancien profil n’est jamais pénalisé pour des catégories absentes du modèle et des critères de sa version.
Chaque résultat indique son édition, sa version de génération et sa révision de calcul. Si le regroupement ou les poids changent, la grille nécessite une nouvelle révision. L’échantillon de référence correspondant doit aussi être évalué selon ces règles. Cela rend le calcul maintenable tout en conservant le sens d’un résultat enregistré.
Lisez le résultat comme un ensemble de prédictions
Le résultat présente un grand score, des barres de crédit de distance et des icônes pour chaque famille de biomes et type de structure admissible. Les icônes de biomes atténuées signifient « non échantillonné » ; celles des structures signifient « aucune prédiction trouvée ». La couverture inconnue possède son propre état, et les types exclus ou non admissibles pour la version restent hors des listes notées.
Les collections d’icônes indiquent quels types étaient représentés. Les barres de contribution expliquent quelle part de leur crédit possible subsiste après la déduction liée à la distance. Deux graines peuvent avoir les mêmes décomptes de familles et de types, mais des scores différents si leurs découvertes les plus proches se trouvent à des distances différentes. Conservez les décomptes et les contributions des deux catégories avec le nombre global lors des comparaisons.
Le résultat conserve les décomptes de biomes de surface et de grottes échantillonnés, les deux dénominateurs et les coordonnées les plus proches. Ses liens vers la carte des graines permettent d’examiner ces lieux. Une coordonnée de biome est le point échantillonné le plus proche, pas une limite exacte du biome. Le point d’apparition et la hauteur de surface sont des estimations.
Les prédictions de structures utilisent les vérifications disponibles de placement et de biomes ; la génération ultérieure peut encore empêcher une structure d’apparaître. Bedrock utilise un modèle de compatibilité dont la précision n’a pas été vérifiée indépendamment dans le jeu. La page À propos explique les étiquettes de preuve du site.
Le profil couvre la génération par défaut. Les packs de données personnalisés, les Grands biomes, les mondes plats et les chunks existants générés avant une mise à jour du monde sont hors de son périmètre. Utilisez la version qui a généré la zone évaluée.
Un indice élevé n’établit ni la beauté du paysage, ni une survie facile, ni un butin précieux. Il ne dit pas non plus quelle fraction du cercle vous visiterez réellement. Un monde insulaire avec un faible score de diversité peut mieux vous convenir qu’une graine comportant de nombreuses catégories proches.
Calculez une graine qui vous intéresse
Ouvrez le calculateur, saisissez une graine et choisissez son édition et sa version de génération. Java accepte aussi les graines textuelles et les convertit en graines numériques ; Bedrock demande une graine numérique. Choisissez un rayon, puis lancez le calcul.
Examinez le détail des catégories avant de comparer les nombres finaux. Si un biome ou une structure vous importe particulièrement, utilisez l’outil de recherche de graines pour chercher cette condition, puis évaluez la diversité environnante avec le calculateur. Son URL conserve les réglages d’entrée pour que vous puissiez revenir à la même question.
Ce que les graines aléatoires nous apprennent
Nous avons sélectionné 1 024 graines numériques pseudo-aléatoires parmi les entiers signés de 64 bits et évalué chaque graine dans Java 26.3 et Bedrock 26.50. Les deux cohortes utilisent la génération par défaut du Monde normal, un rayon de 2 048 blocs et la révision 1 du calcul, avec 35 familles de biomes admissibles et 17 types de structures. Les mêmes numéros de graine forment une étude appariée ; la distribution de chaque édition est résumée séparément. Les 2 048 évaluations du modèle se sont terminées, sans omission ni remplacement d’un résultat échoué ou incomplet.
Nous avons sélectionné des graines numériques sans les choisir dans le catalogue publié. Cette étude décrit le calculateur avec ces réglages ; elle ne mesure pas les mondes que les joueurs ont choisi de conserver.
Lisez la distribution globale
Le tableau décrit l’indice affiché et arrondi. P10 à P90 donne les valeurs des 10e et 90e percentiles de l’échantillon. Les égalités sur les entiers peuvent faire dépasser 80% à la proportion située entre ces valeurs ; cette plage n’est pas un intervalle de confiance.
| Modèle de génération | Indice moyen | Indice médian | P10 à P90 | Médiane des familles échantillonnées | Médiane des types prédits |
|---|---|---|---|---|---|
| Java 26.3 | 62,4 | 62 | 56 à 68 | 27 sur 35 | 13 sur 17 |
| Bedrock 26.50 | 62,8 | 63 | 57 à 69 | 27 sur 35 | 13 sur 17 |
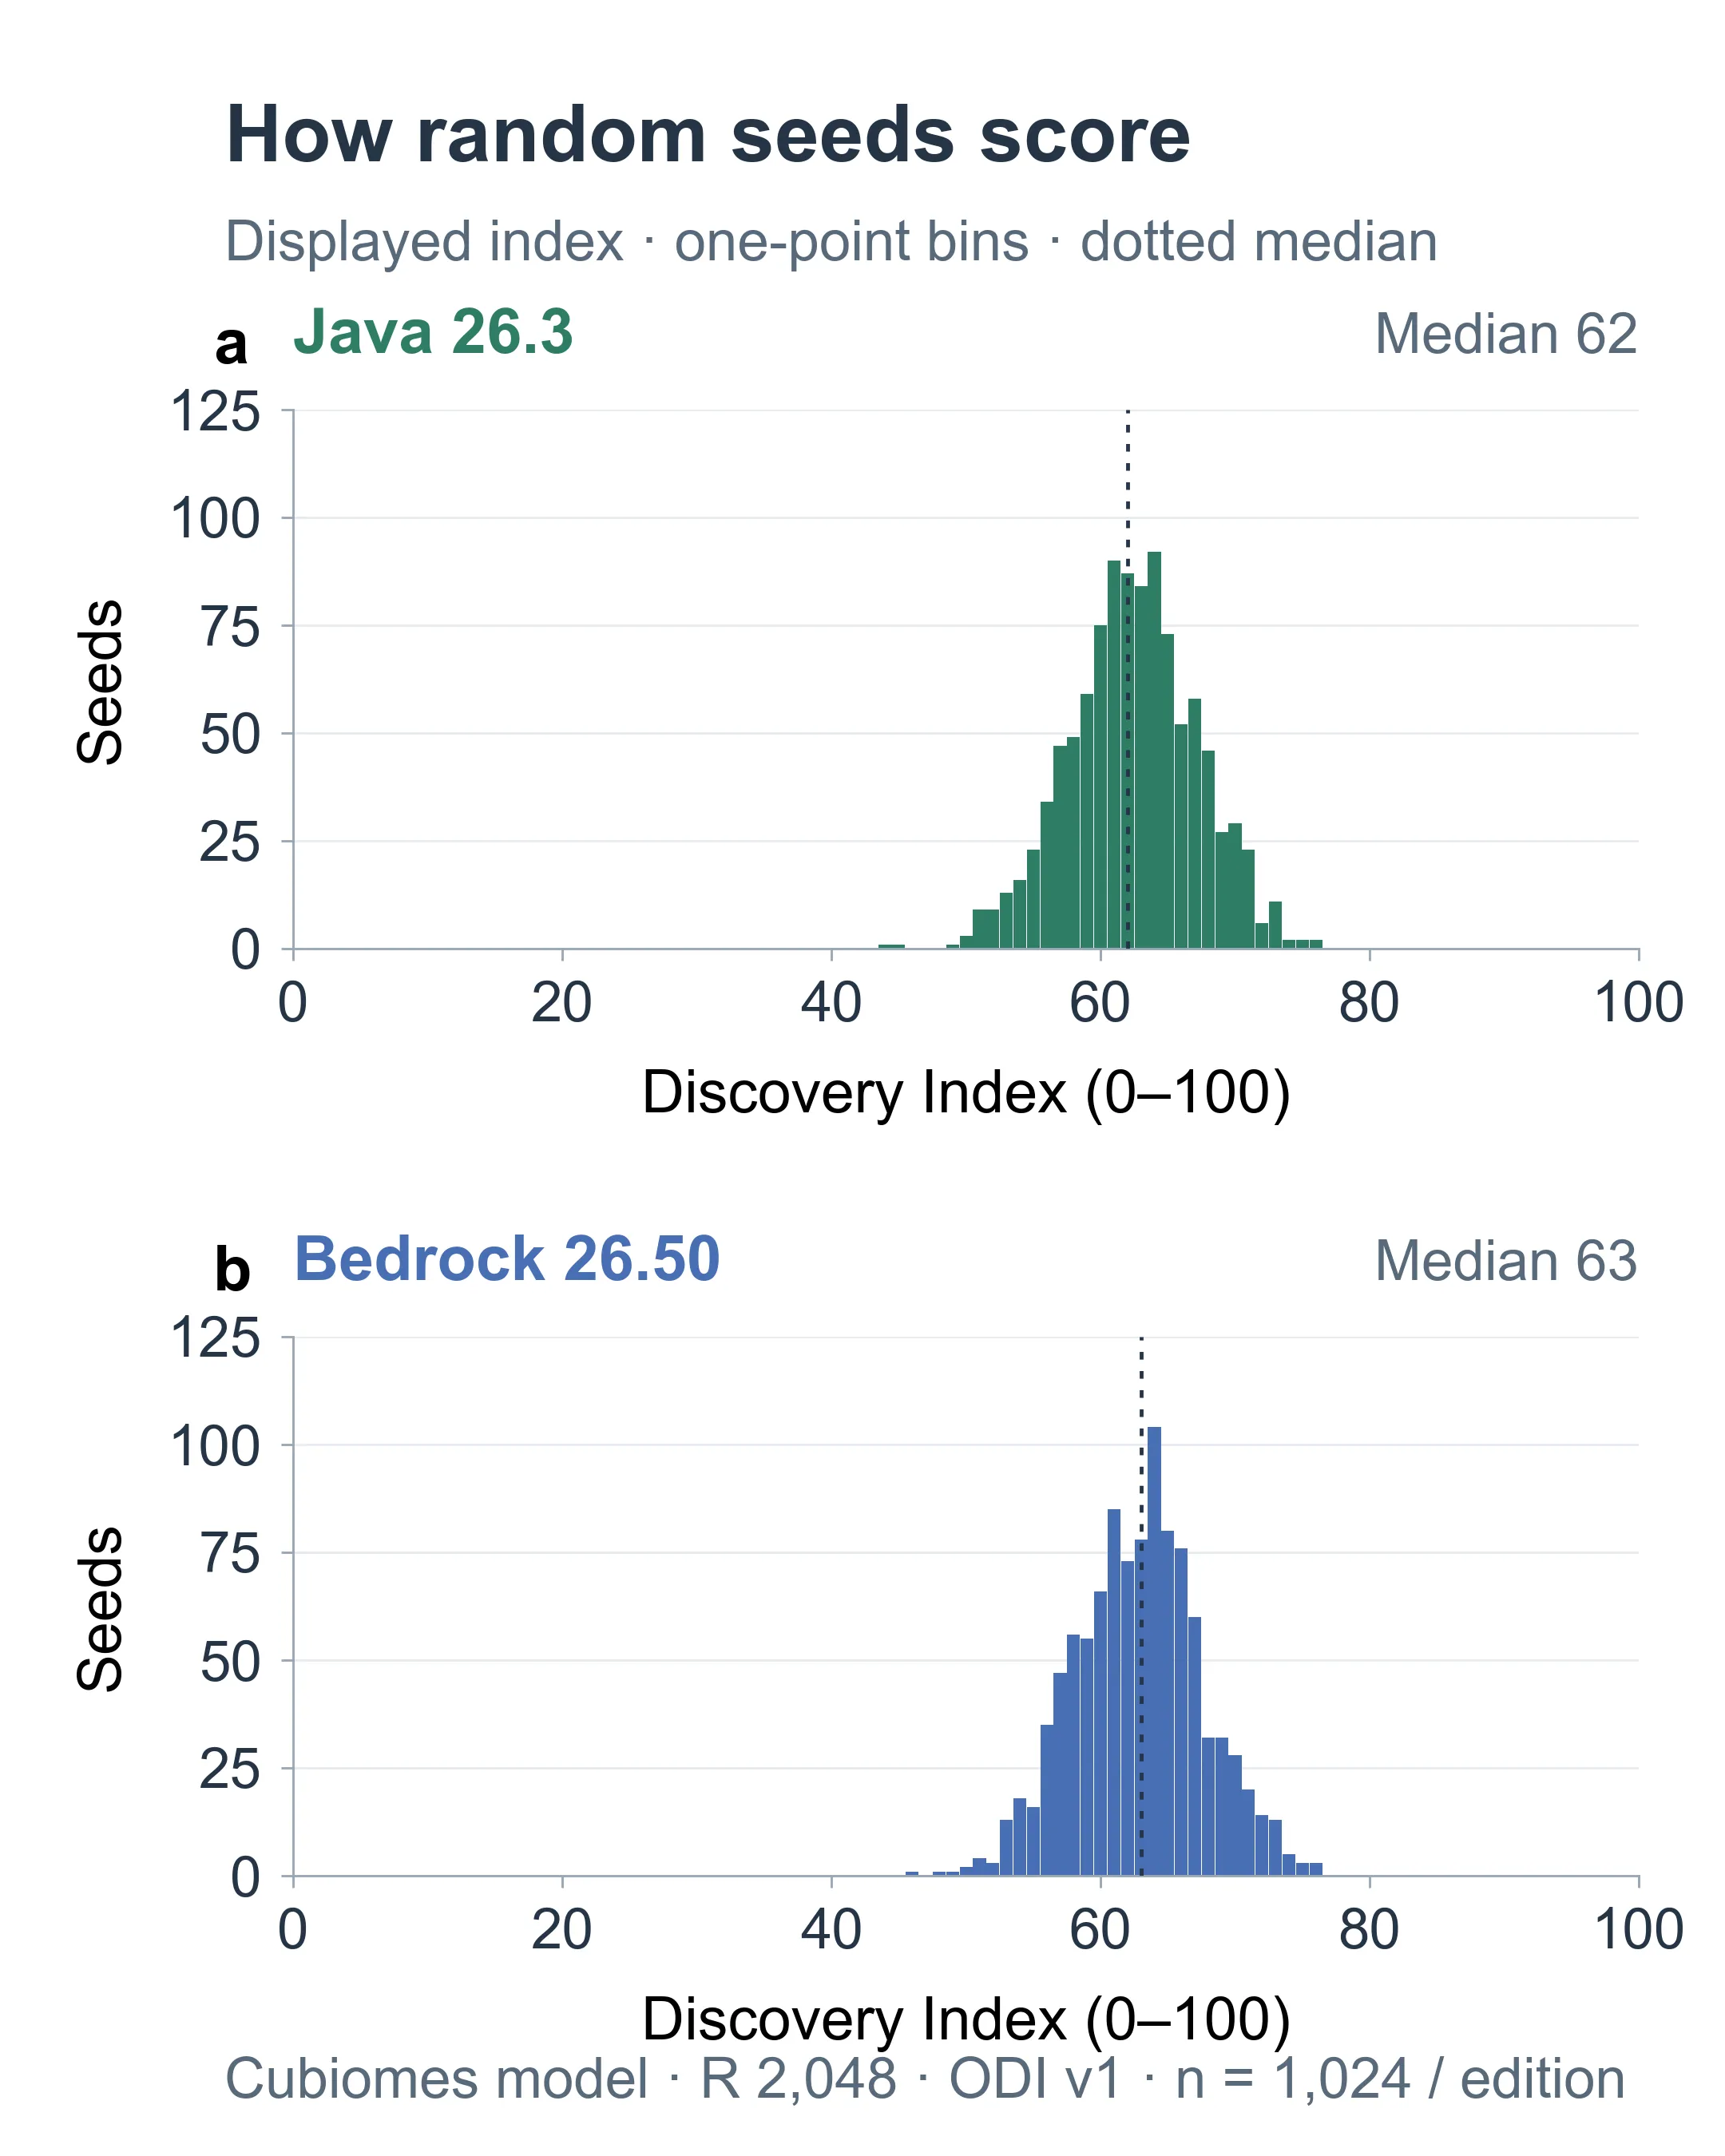
Prédictions du modèle du calculateur. Chaque barre étroite compte les graines recevant une valeur d’indice affichée. Les deux panneaux utilisent l’échelle complète de score de 0 à 100 et la même échelle de nombre de graines.
L’axe horizontal est l’indice affiché ; l’axe vertical est le nombre de graines échantillonnées qui le reçoivent. Les barres plus hautes indiquent les scores plus courants dans la cohorte. Les scores Java vont de 44 à 76, et les scores Bedrock de 46 à 76. Leurs médianes se trouvent près du milieu des distributions observées, bien en dessous du plafond théorique de 100.
Un score de 69 se situe donc au-dessus de la médiane de chacun de ces échantillons de référence correspondants. Le détail des biomes et des structures explique quelles découvertes ont fourni ces points.
Distinguez l’étendue de la diversité du crédit de distance
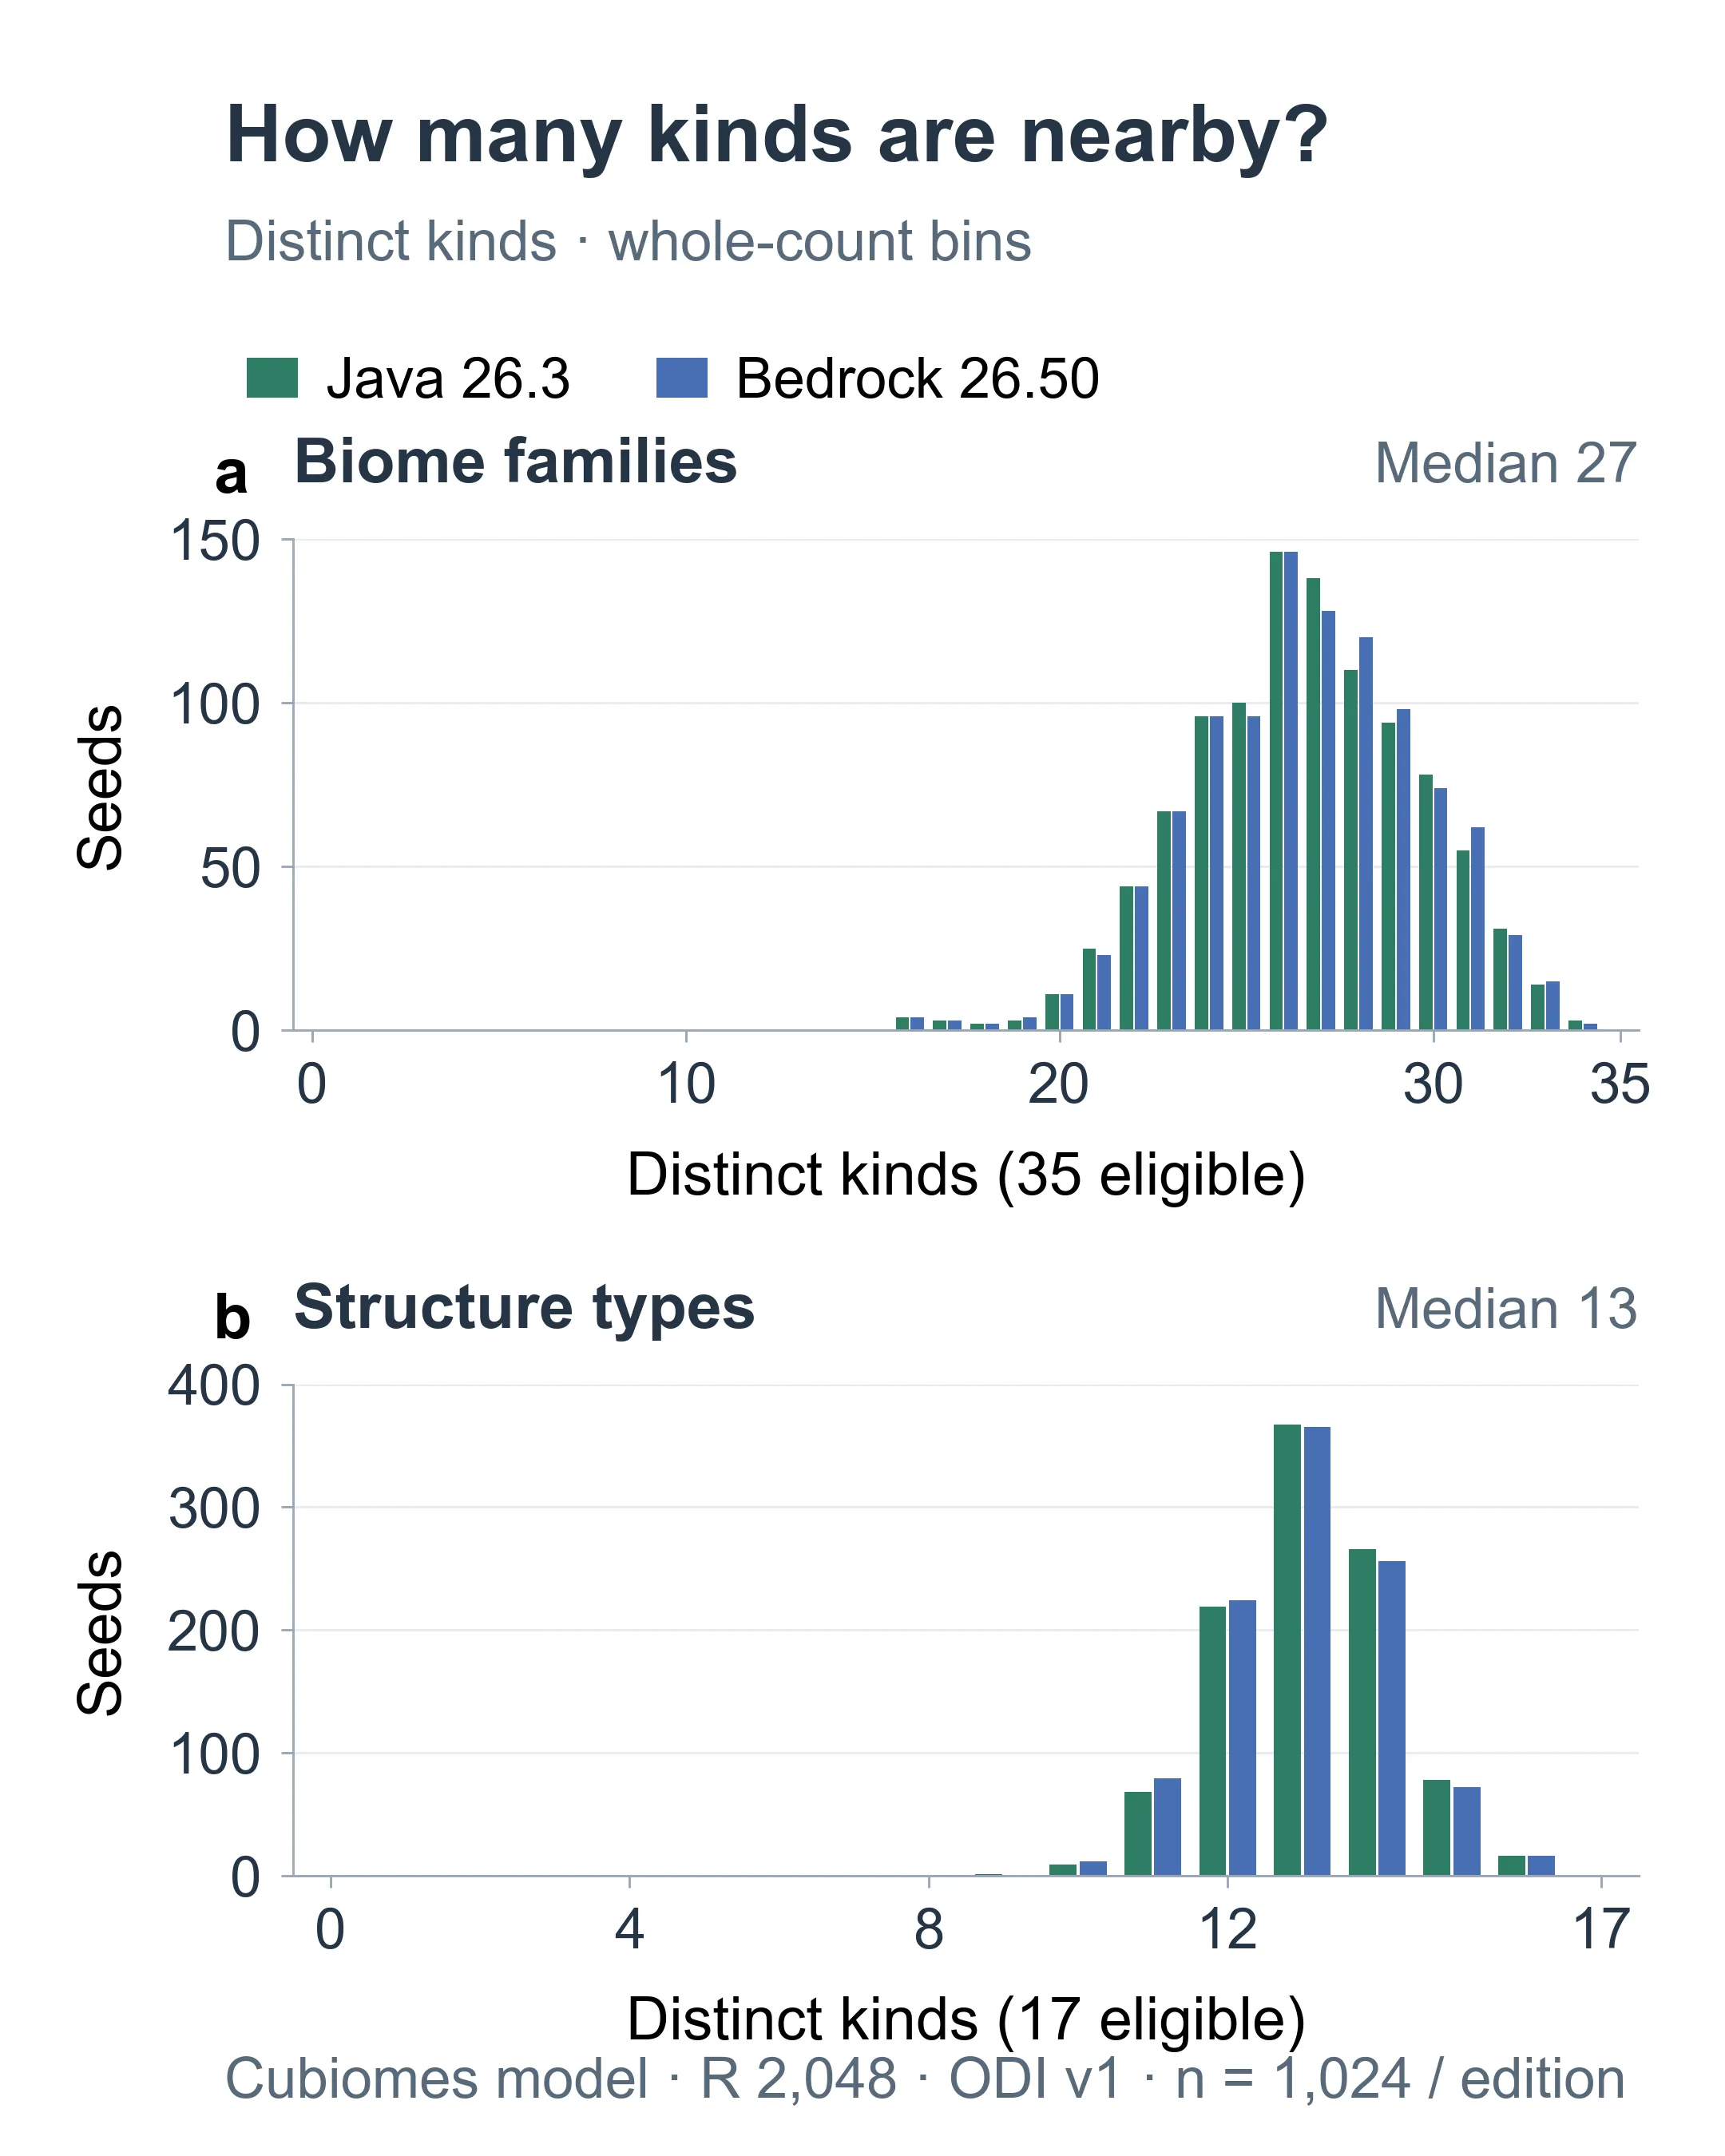
Chaque barre compte les graines du modèle présentant un nombre donné de familles ou de types de structures. Les familles de surface et de grottes sont incluses. Ces décomptes n’ont aucune pondération de distance.
Le panneau supérieur indique combien de familles de biomes différentes ont été échantillonnées dans le cercle. Le panneau inférieur indique combien de types de structures différents y avaient une prédiction. Lisez séparément les barres vertes et bleues dans chaque groupe de nombres entiers ; les additionner réunirait deux éditions dont les réglages de référence doivent rester distincts.
Les deux éditions ont une médiane de 27 familles échantillonnées et de 13 types prédits. Les décomptes de familles vont de 16 à 34 dans chaque cohorte. Ceux des types prédits vont de 9 à 16 dans Java et de 10 à 16 dans Bedrock. Aucun monde échantillonné ne représentait les 35 familles ou les 17 types avec ces réglages du modèle.
L’étendue de la diversité indique combien de types sont représentés, quelle que soit la distance de leurs échantillons ou prédictions les plus proches. Le score final récompense aussi la proximité. Un décompte de 27 familles ou de 13 structures ne doit donc pas être lu comme un score de composante de 27 ou 13 sur 100.
Examinez la moitié biomes
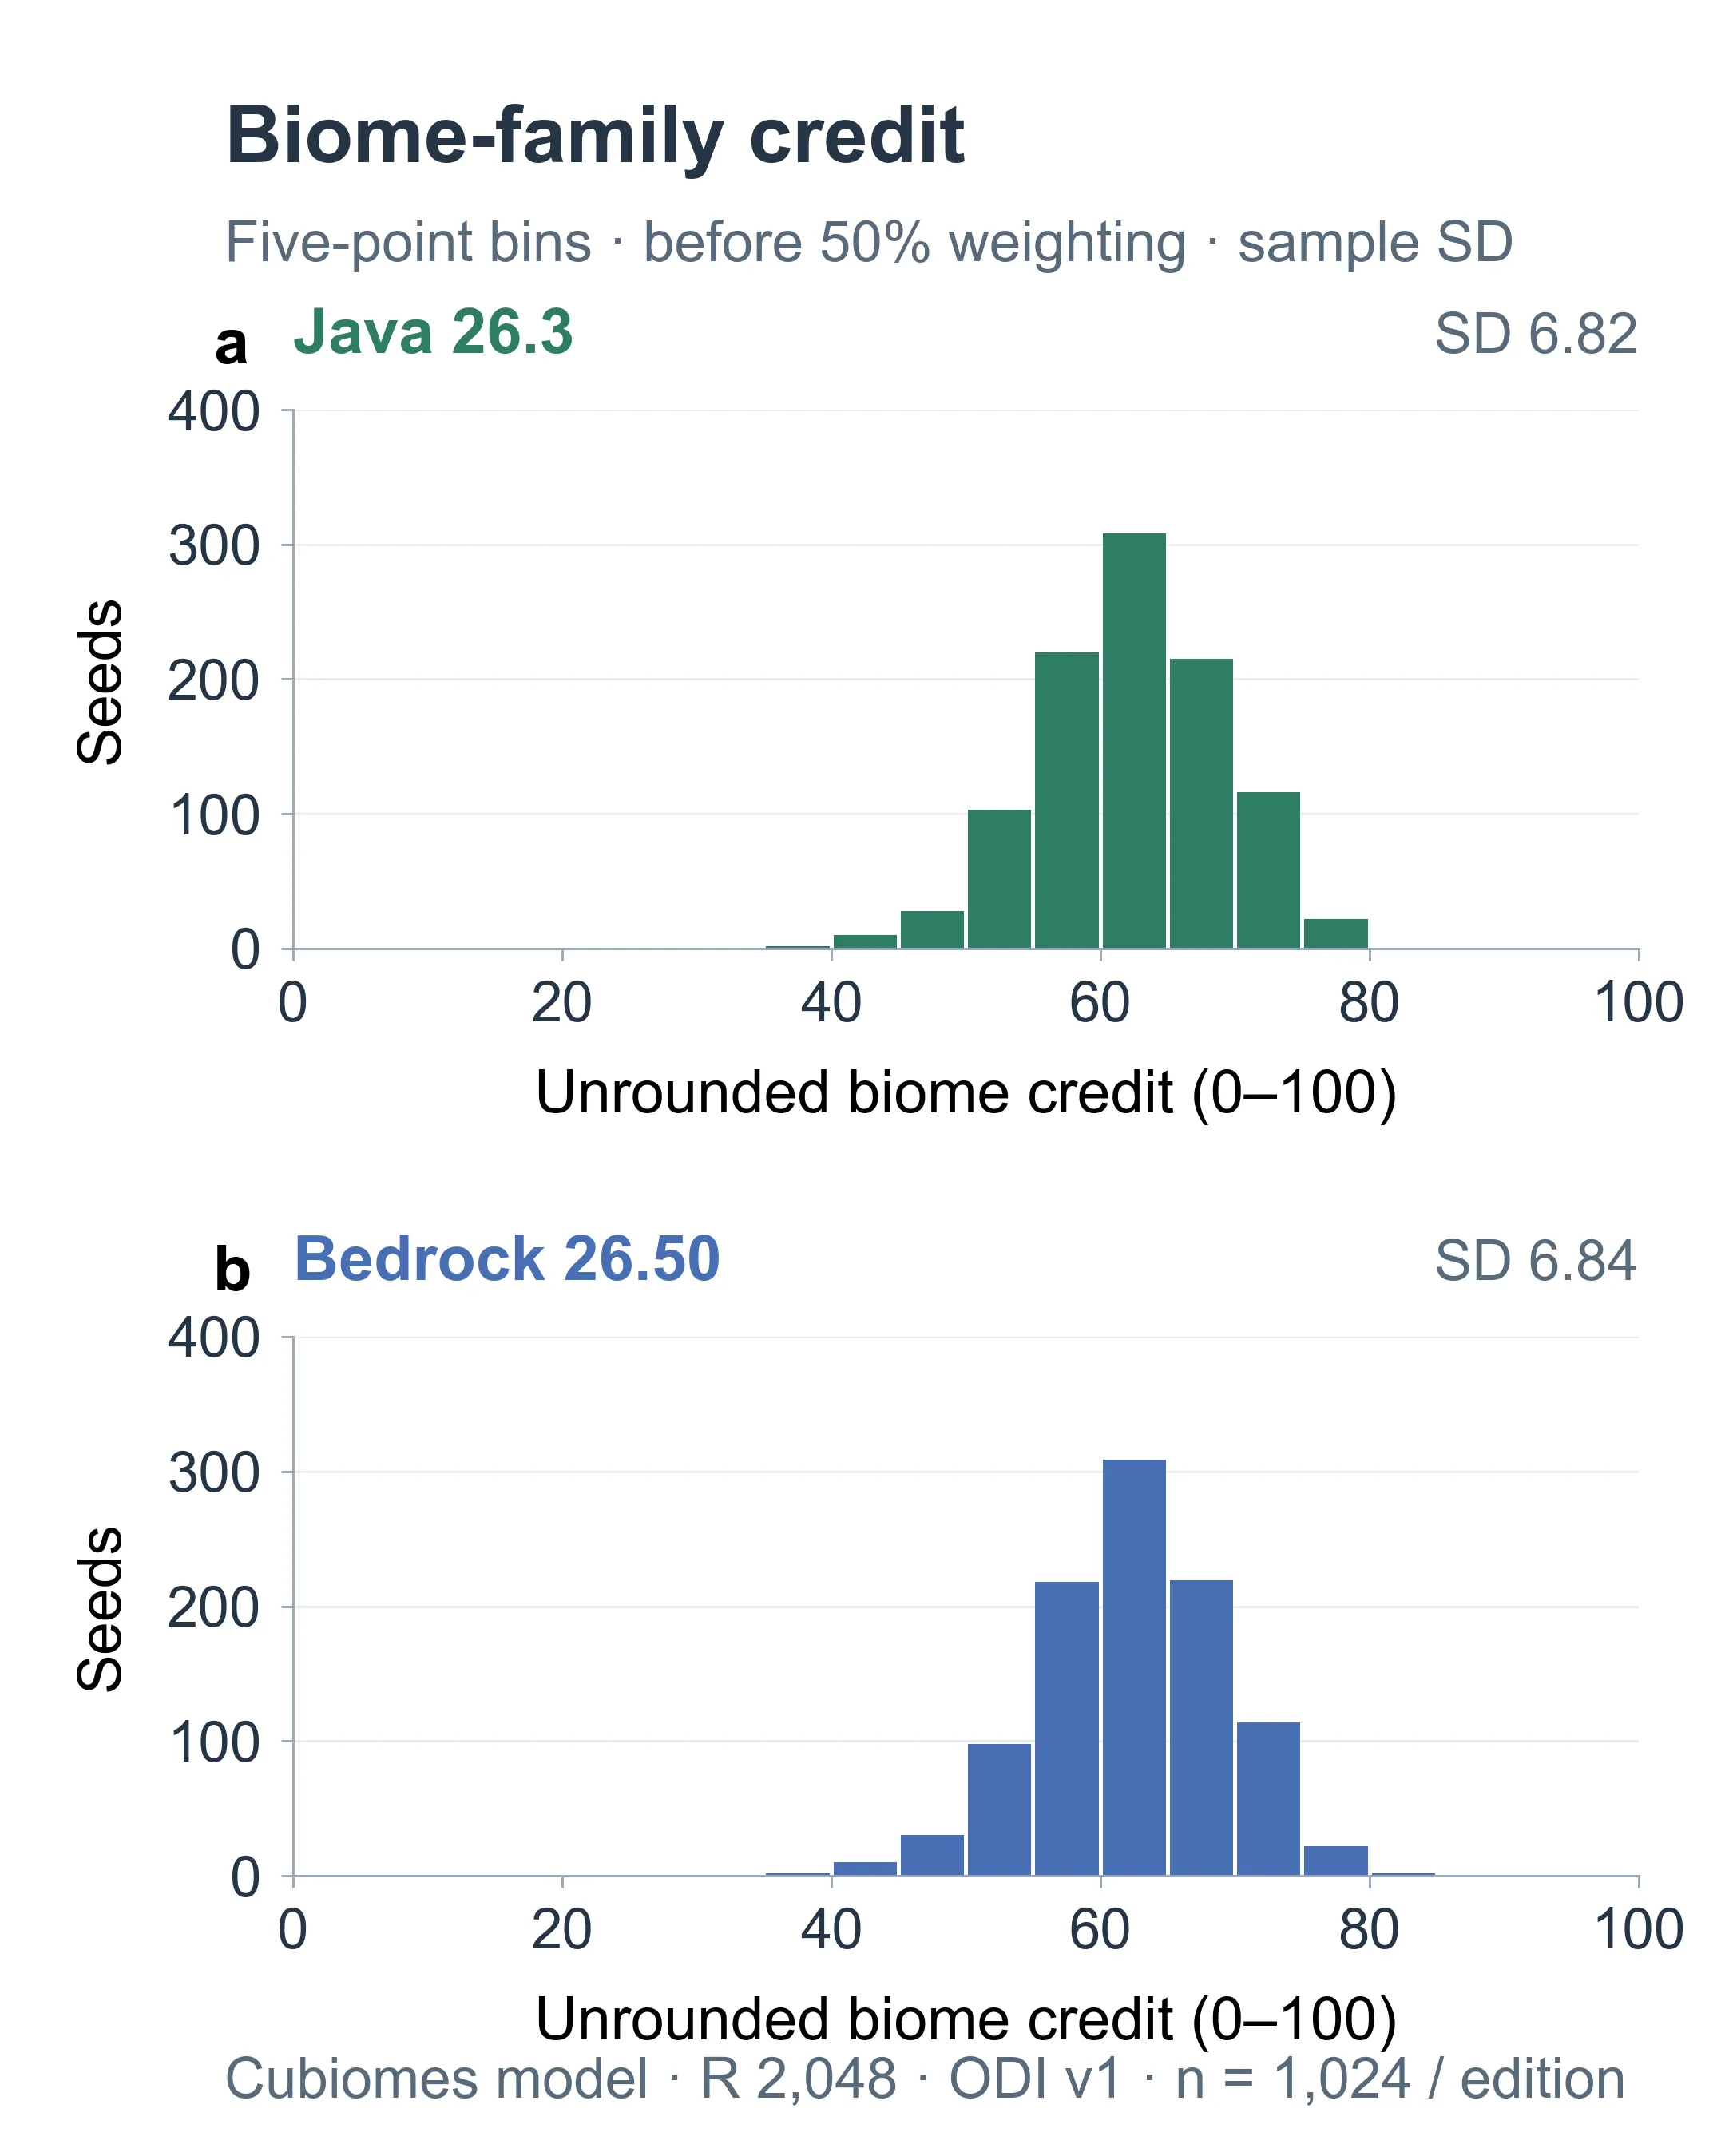
Prédictions du modèle provenant du même échantillon de graines apparié. Ces valeurs de l’axe horizontal sont les scores de biomes avant leur demi-pondération dans l’indice global.
Chaque barre couvre un intervalle de cinq points, contrairement aux barres d’un seul entier de l’histogramme du score global. Une composante biomes de 70 contribuerait 35 points à l’indice avant l’arrondi final. Cela signifie que le crédit moyen des familles admissibles est de 0,70 ; pas que 70 familles ou 70% du cercle ont été explorés.
Les distributions des biomes varient davantage dans ces échantillons que celles des structures ci-dessous. Leurs écarts-types d’échantillon sont d’environ 6,82 points dans Java et 6,84 dans Bedrock. Le NIST décrit l’écart-type comme une mesure de dispersion autour de la moyenne d’échantillon, exprimée dans les unités d’origine. Ici, ces unités sont des points de score de composante. Cela décrit la variation entre les scores des graines, pas une marge d’erreur de la moyenne. Les deux distributions de biomes présentent aussi un écart à une forme normale détectable statistiquement dans notre test diagnostique, après correction pour les tests multiples.
Le décompte de familles et les distances produisent conjointement cette dispersion. L’histogramme n’identifie pas la famille absente d’une graine particulière ; les icônes et les détails de coordonnées du calculateur répondent à cette question.
Examinez la moitié structures
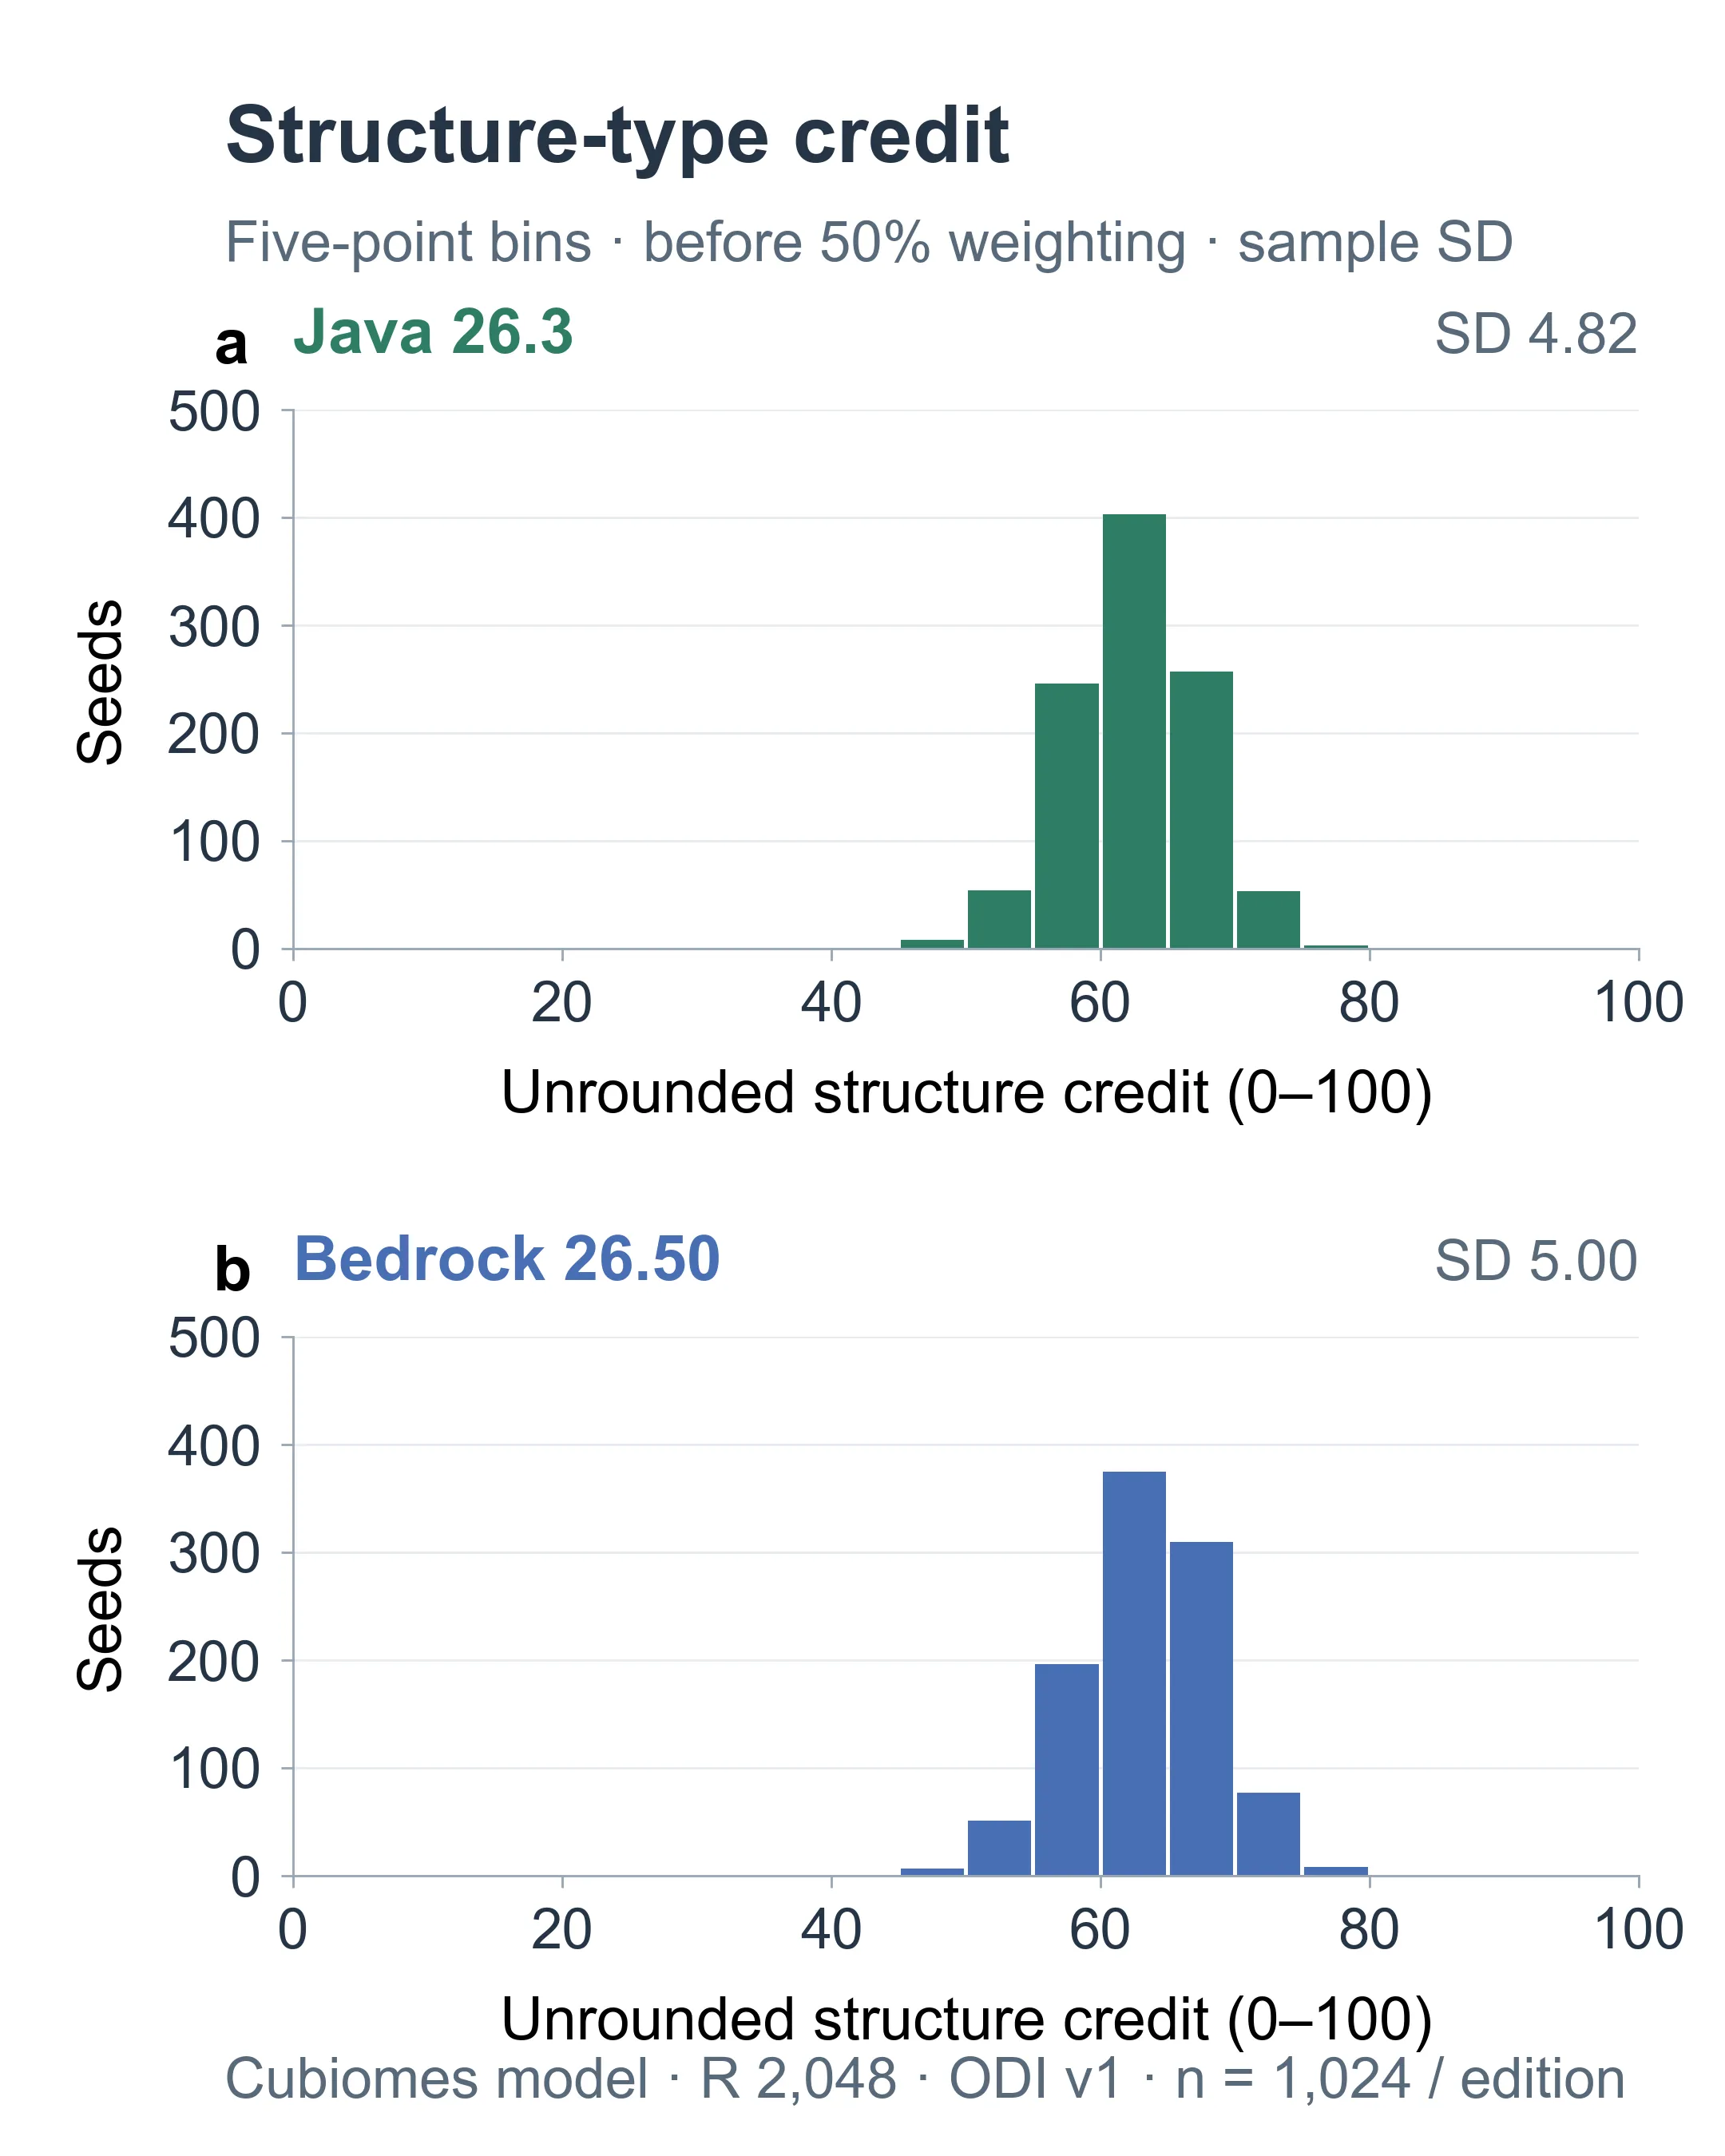
Chaque type de structure modélisé contribue une seule fois, par sa prédiction la plus proche. Le graphique ne compte pas toutes les structures d’un monde.
Les axes et les classes de cinq points ont le même sens que dans le graphique de la composante biomes ; leurs dispersions horizontales sont donc comparables. Chaque graphique possède ses propres graduations verticales de nombre de graines. Les écarts-types d’échantillon sont d’environ 4,82 points pour Java et de 5,00 pour Bedrock, inférieurs à la dispersion de la composante biomes. Notre test de normalité corrigé n’a rejeté aucune des deux distributions de la composante structures.
La moitié structures combine les décomptes de types représentés avec leur proximité horizontale. Des villages supplémentaires du même type n’ajoutent pas de points de diversité, et un fort prédit proche ne reçoit aucune compensation supplémentaire pour l’effort nécessaire pour l’atteindre sous terre. Ce sont des propriétés de cette grille, pas des conclusions sur la difficulté de ces mondes.
L’indice global fait la moyenne de ces deux scores de composante différents avant l’arrondi. Sa distribution peut différer de chaque moitié. Dans ces cohortes, l’ensemble semble approximativement en forme de cloche, même si la composante biomes s’écarte de la normalité. Nous évaluons directement cet ensemble ; combiner deux scores n’établit pas de règle générale pour toutes les versions ou tous les rayons.
Examinez les extrémités avec un diagramme Q-Q normal
Un histogramme aide à voir où se trouvent la plupart des scores, mais ses classes peuvent masquer de petites différences de forme. Le diagramme Q-Q normal compare les scores non arrondis ordonnés aux scores attendus d’une distribution normale, en utilisant la moyenne observée et l’écart-type d’échantillon de chaque cohorte. L’explication du NIST sur les diagrammes de probabilité normale décrit comment les écarts à une droite de référence révèlent des différences par rapport à une forme normale.
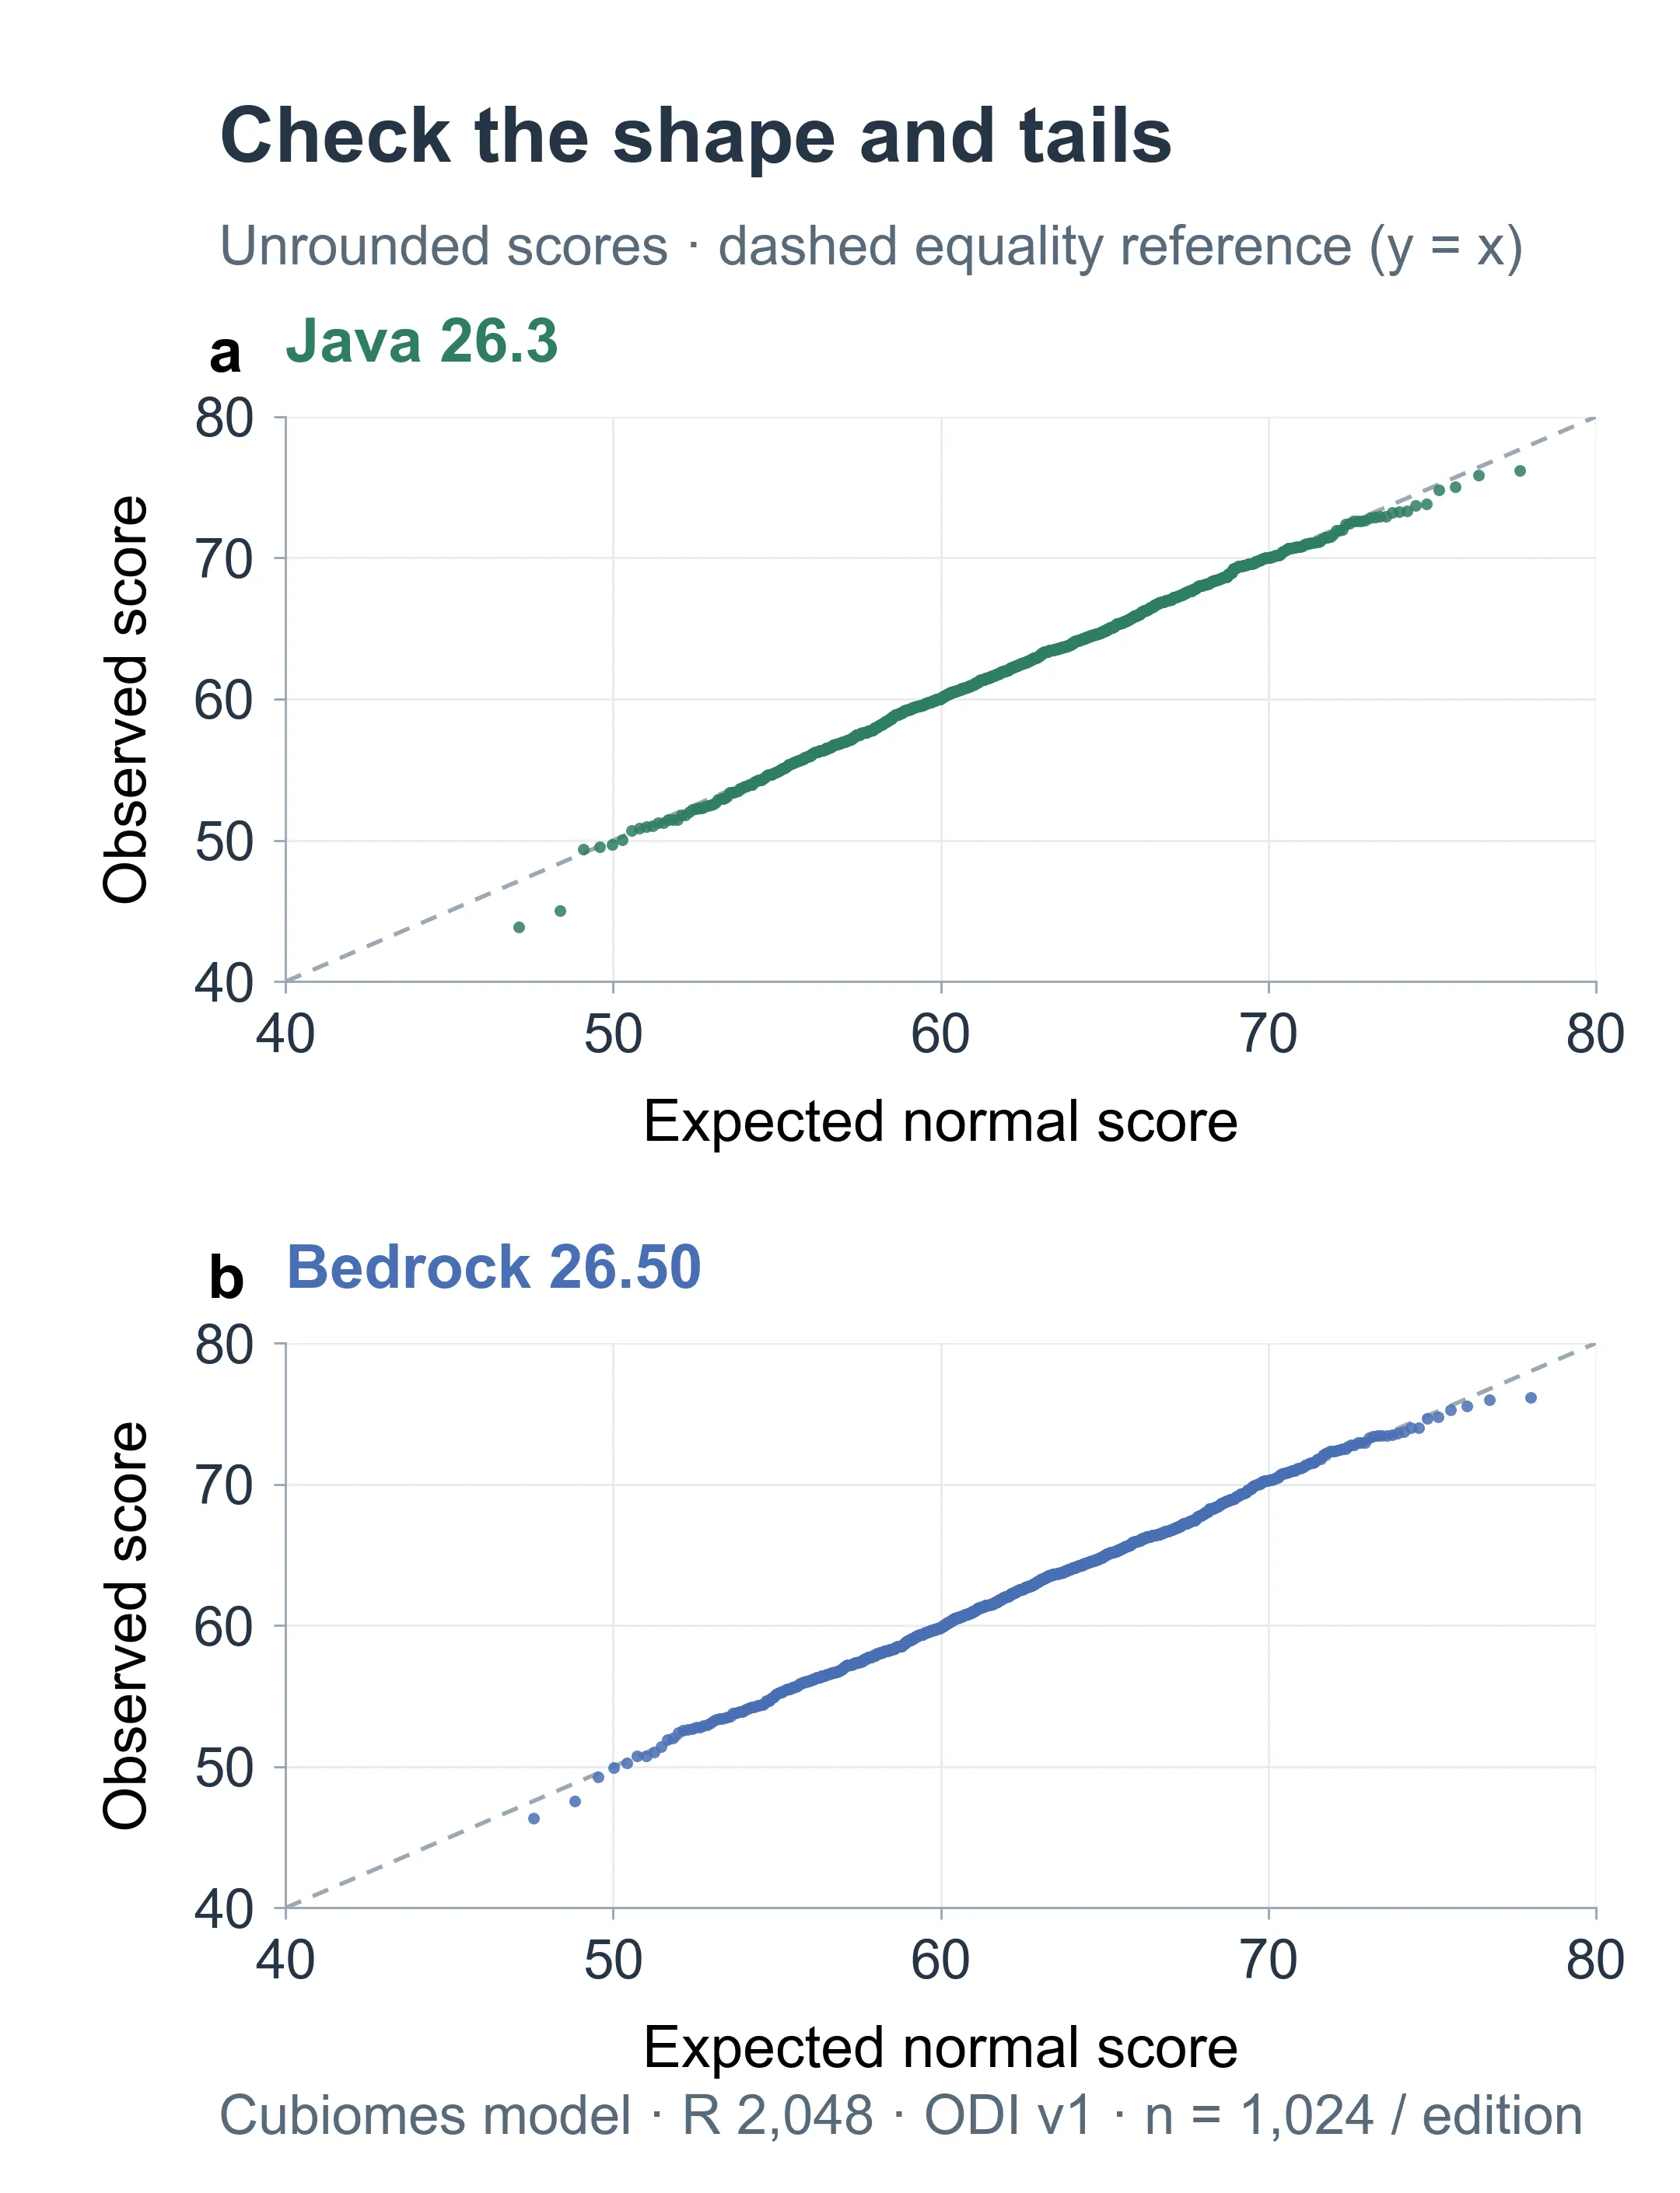
Chaque panneau contient les 1 024 scores globaux non arrondis. Les scores normaux attendus utilisent la moyenne et l’écart-type de l’échantillon ; la diagonale grise indique l’égalité des valeurs attendues et observées. Ce n’est pas une bande de confiance.
Les deux axes utilisent des points d’indice. Un point sur la diagonale possède le score observé attendu à cette position dans la comparaison normale. Les points au-dessus ont des scores observés supérieurs ; ceux en dessous des scores inférieurs. Les points les plus à gauche et à droite représentent les extrémités basse et haute de l’échantillon.
La plupart des points suivent la diagonale de près, avec des écarts aux extrémités. Ces points extrêmes comptent lorsque la question porte sur des scores inhabituellement bas ou élevés. Un bon ajustement au centre n’établit pas une estimation fiable par courbe normale pour un score très rare hors de la plage observée.
Ce que la vérification de normalité établit
Nous avons appliqué le test de Shapiro-Wilk documenté par SciPy au score global non arrondi et aux deux composantes non arrondies de chaque édition. Utiliser les valeurs non arrondies évite de traiter les égalités entre entiers affichés comme des mesures continues. Nous avons utilisé un seuil de 0,05 et une correction de Holm sur ces six tests.
| Distribution testée | Valeur p ajustée Java 26.3 | Valeur p ajustée Bedrock 26.50 | Résultat à 0,05 |
|---|---|---|---|
| Indice global | 0,667 | 0,667 | Écart non détecté |
| Composante biomes | 0,0059 | 0,0059 | Écart détecté |
| Composante structures | 0,231 | 0,472 | Écart non détecté |
Les valeurs p non ajustées des tests globaux étaient de 0,334 pour Java et de 0,660 pour Bedrock. Leur absence de rejet est cohérente avec les formes approximativement en cloche de ces échantillons précis. Elle ne prouve pas la normalité, ne certifie pas les modèles de génération et ne donne pas la probabilité qu’un monde soit plaisant à jouer.
Les scores restent bornés de 0 à 100. Nous utilisons les fréquences réellement observées pour comparer les graines, sans convertir un score par une courbe normale ajustée. Les tests et les graphiques décrivent ces deux cohortes ; d’autres éditions, versions, rayons ou futures révisions de la grille nécessitent leur propre évaluation.
Le résumé statistique complet et tous les résultats échantillonnés du modèle conservent les mesures à l’origine de ces figures. Les cinq figures de distribution utilisent le même échantillon apparié ; la figure du crédit de distance illustre la formule.
Situez un score individuel
Pour la graine d’exemple Java 26.3 12345, le calculateur prédit un score de 69, avec 30 familles échantillonnées sur 35 et 14 types de structures prédits sur 17. Ces décomptes de couverture représentent environ 84 points possibles avant les déductions de distance : 50 × 30 / 35 + 50 × 14 / 17 ≈ 84. Les distances les plus proches réduisent ce total au 69 affiché. Dans l’échantillon de référence correspondant, 922 scores étaient inférieurs, 27 identiques et 75 supérieurs.
Les égalités de score comptent. Chaque 69 affiché représente un résultat arrondi, que différentes combinaisons de crédit de biomes et de structures peuvent produire. Les décomptes exacts des scores affichés inférieurs, égaux et supérieurs conservent ces égalités. Ils expliquent aussi la comparaison plus directement que l’attribution silencieuse du même percentile normal estimé à chaque graine ex æquo.
Le calculateur montre l’histogramme observé, la médiane d’échantillon, la plage P10 à P90 et les décomptes inférieurs, égaux et supérieurs à votre score lorsque l’édition, la version, le rayon, la grille et le modèle de génération correspondent exactement. Les autres réglages reçoivent toujours le détail de leurs découvertes ; ils n’ont actuellement aucun échantillon de référence correspondant.
La fréquence de rencontre nécessite aussi son propre dénominateur. Dans la cohorte Java 26.3 à ce rayon, le modèle a échantillonné une famille de Champs de champignons dans 294 graines sur 1 024 (28,7%) et prédit un Manoir des bois dans 158 (15,4%). Ce sont des occurrences quelque part dans le cercle du point d’apparition estimé, pas la probabilité d’apparaître dans ce biome ni une mesure de sa superficie globale.
Un histogramme du score global indique la fréquence à laquelle le calculateur a produit des totaux donnés dans cet échantillon. Un critère pondéré par la rareté poserait une autre question sur la fréquence de rencontre de familles ou de types de structures particuliers. La révision 1 conserve des poids égaux dans chaque catégorie ; ces mesures n’ont pas été transformées en bonus de rareté. Un tel changement nécessiterait des références de rencontre correspondant à l’édition, à la version de génération, au rayon et aux règles d’échantillonnage, ainsi qu’une nouvelle révision de grille examinée.
Il s’agit d’un échantillon de référence de prédictions du modèle, pas d’un percentile de rareté de la population, d’un échantillon de mondes joués ou d’une mesure des distances parcourues par les joueurs. Un score de 80 ne signifie pas qu’une graine est plus variée que 80% de toutes les graines. Utilisez le calculateur pour comparer les découvertes modélisées dans la zone que vous comptez explorer, puis examinez les lieux qui vous importent sur la carte des graines.