seedlookout
Minecraft 種子體驗指數能協助回答一個實際問題:在我想探索的範圍內,這個種子提供多少不同地形,以及多少種目的地?
我們的種子體驗計算器將這項評分稱為「主世界探索指數」。它結合取樣得到的生態域類群與預測結構類型,算出 0 到 100 的分數;越靠近估算出生點的發現,保留的得分越多。你可以選擇版本種類、生成版本與半徑。分數描述的是模型中的多樣性,是否想在那裡遊玩,仍由你的喜好決定。
我們在兩個生成模型中,各檢查 1,024 個偽隨機種子。半徑 2,048 個方塊時,顯示指數的中位數為 Java 26.3 的 62 和 Bedrock 26.50 的 63。評分規則在數學上的最高值 100,與該樣本的中心位置是不同概念。以下圖表說明如何理解分數的背景,而不把它當成遊玩樂趣評分。
選擇探索半徑
計算器提供 512、1,024、2,048 和 4,096 個方塊的半徑。每個範圍都是以估算世界出生點為中心、按水平距離計算的圓。半徑 2,048 個方塊代表每個方向都延伸那麼遠,不表示走 2,048 個方塊就能造訪圈內所有地方。
預設使用 2,048 個方塊,是因為工具需要一個起始範圍;我們並未用具代表性的 Minecraft 玩家探索距離資料校準這項選擇。Mojang 的探索指南介紹短程出遊與較大型冒險,但沒有提供平均半徑。
請選擇符合你想要世界的半徑。小圓圈關注附近的多樣性;大圓圈涵蓋更多可能目的地,也讓同一個附近發現得到較多距離得分。比較兩個種子時請使用相同半徑,才能維持一致的問題。
因此,半徑會改變兩件事:搜尋範圍,以及特定距離的得分。距離出生點 1,024 個方塊的預測,在半徑 2,048 時得到 0.75,半徑 4,096 時則得到 0.875。即使尚未找到另一種類型,較大半徑的分數也可能上升。這回答的是更廣範圍的探索問題,不能證明種子本身變好了。
計算不同體驗的種類
直接計算生態域數量,可能讓幾種非常相近的地形各得一分。計算器仍顯示原始 ID,但評分時會將相關變體分組。平原與向日葵平原共用一個類群,海洋與深海共用另一個。花森林有自己的類群,各洞穴類群也分開計算。
這些類群是我們自行編訂的定義。工具不評估進度完成度,每個符合條件的類群在生態域部分都有相同權重。只有所選生成模型版本的目錄包含該類群的成員,它才會納入計算。
地表地形以 32 個方塊間距的網格,在近似地表高度取樣。如果該高度回傳洞穴生態域,計算器就不把那個樣本納入地表數量。狹窄區域可能落在網格點之間,因此原始數量是取樣到的生態域 ID 數,並非完整清單。
洞穴取樣使用 64 個方塊間距的網格,在 Y -48, -32, -16, 0, 16, 32 and 48 取樣,只保留位於近似地表下至少八個方塊的點。這些樣本辨識的是洞穴生態域區域;取樣點可能位於實心地形內,並不能證明該座標有可進入的洞穴。這版初始評分規則沒有對垂直移動或挖掘耗力扣除距離分數。
結構依類型計分:不論圈內有多少個村莊預測,村莊都只計一次。村莊與沉船則增加兩個不同類型。計算器會搜尋每個符合條件類型的最近預測位置;只要版本計算條件支援,也包含地下目的地。
由於現有的最近位置搜尋工具無法確認所有可選半徑的涵蓋情況,所有設定都排除礦坑/礦洞。因此,分數衡量的是所列條件,不是主世界所有可能的目的地。
讓附近發現保留更多得分
每個已找到的類群或結構類型,其得分由水平距離決定:
credit = 1 − 0.5 × distance / radius
位於出生點的發現得到 1;在半徑一半處得到 0.75,邊界得到 0.5;未找到的項目得到 0。各類別平均值的分母都包含所有符合條件項目,包括未找到的項目。
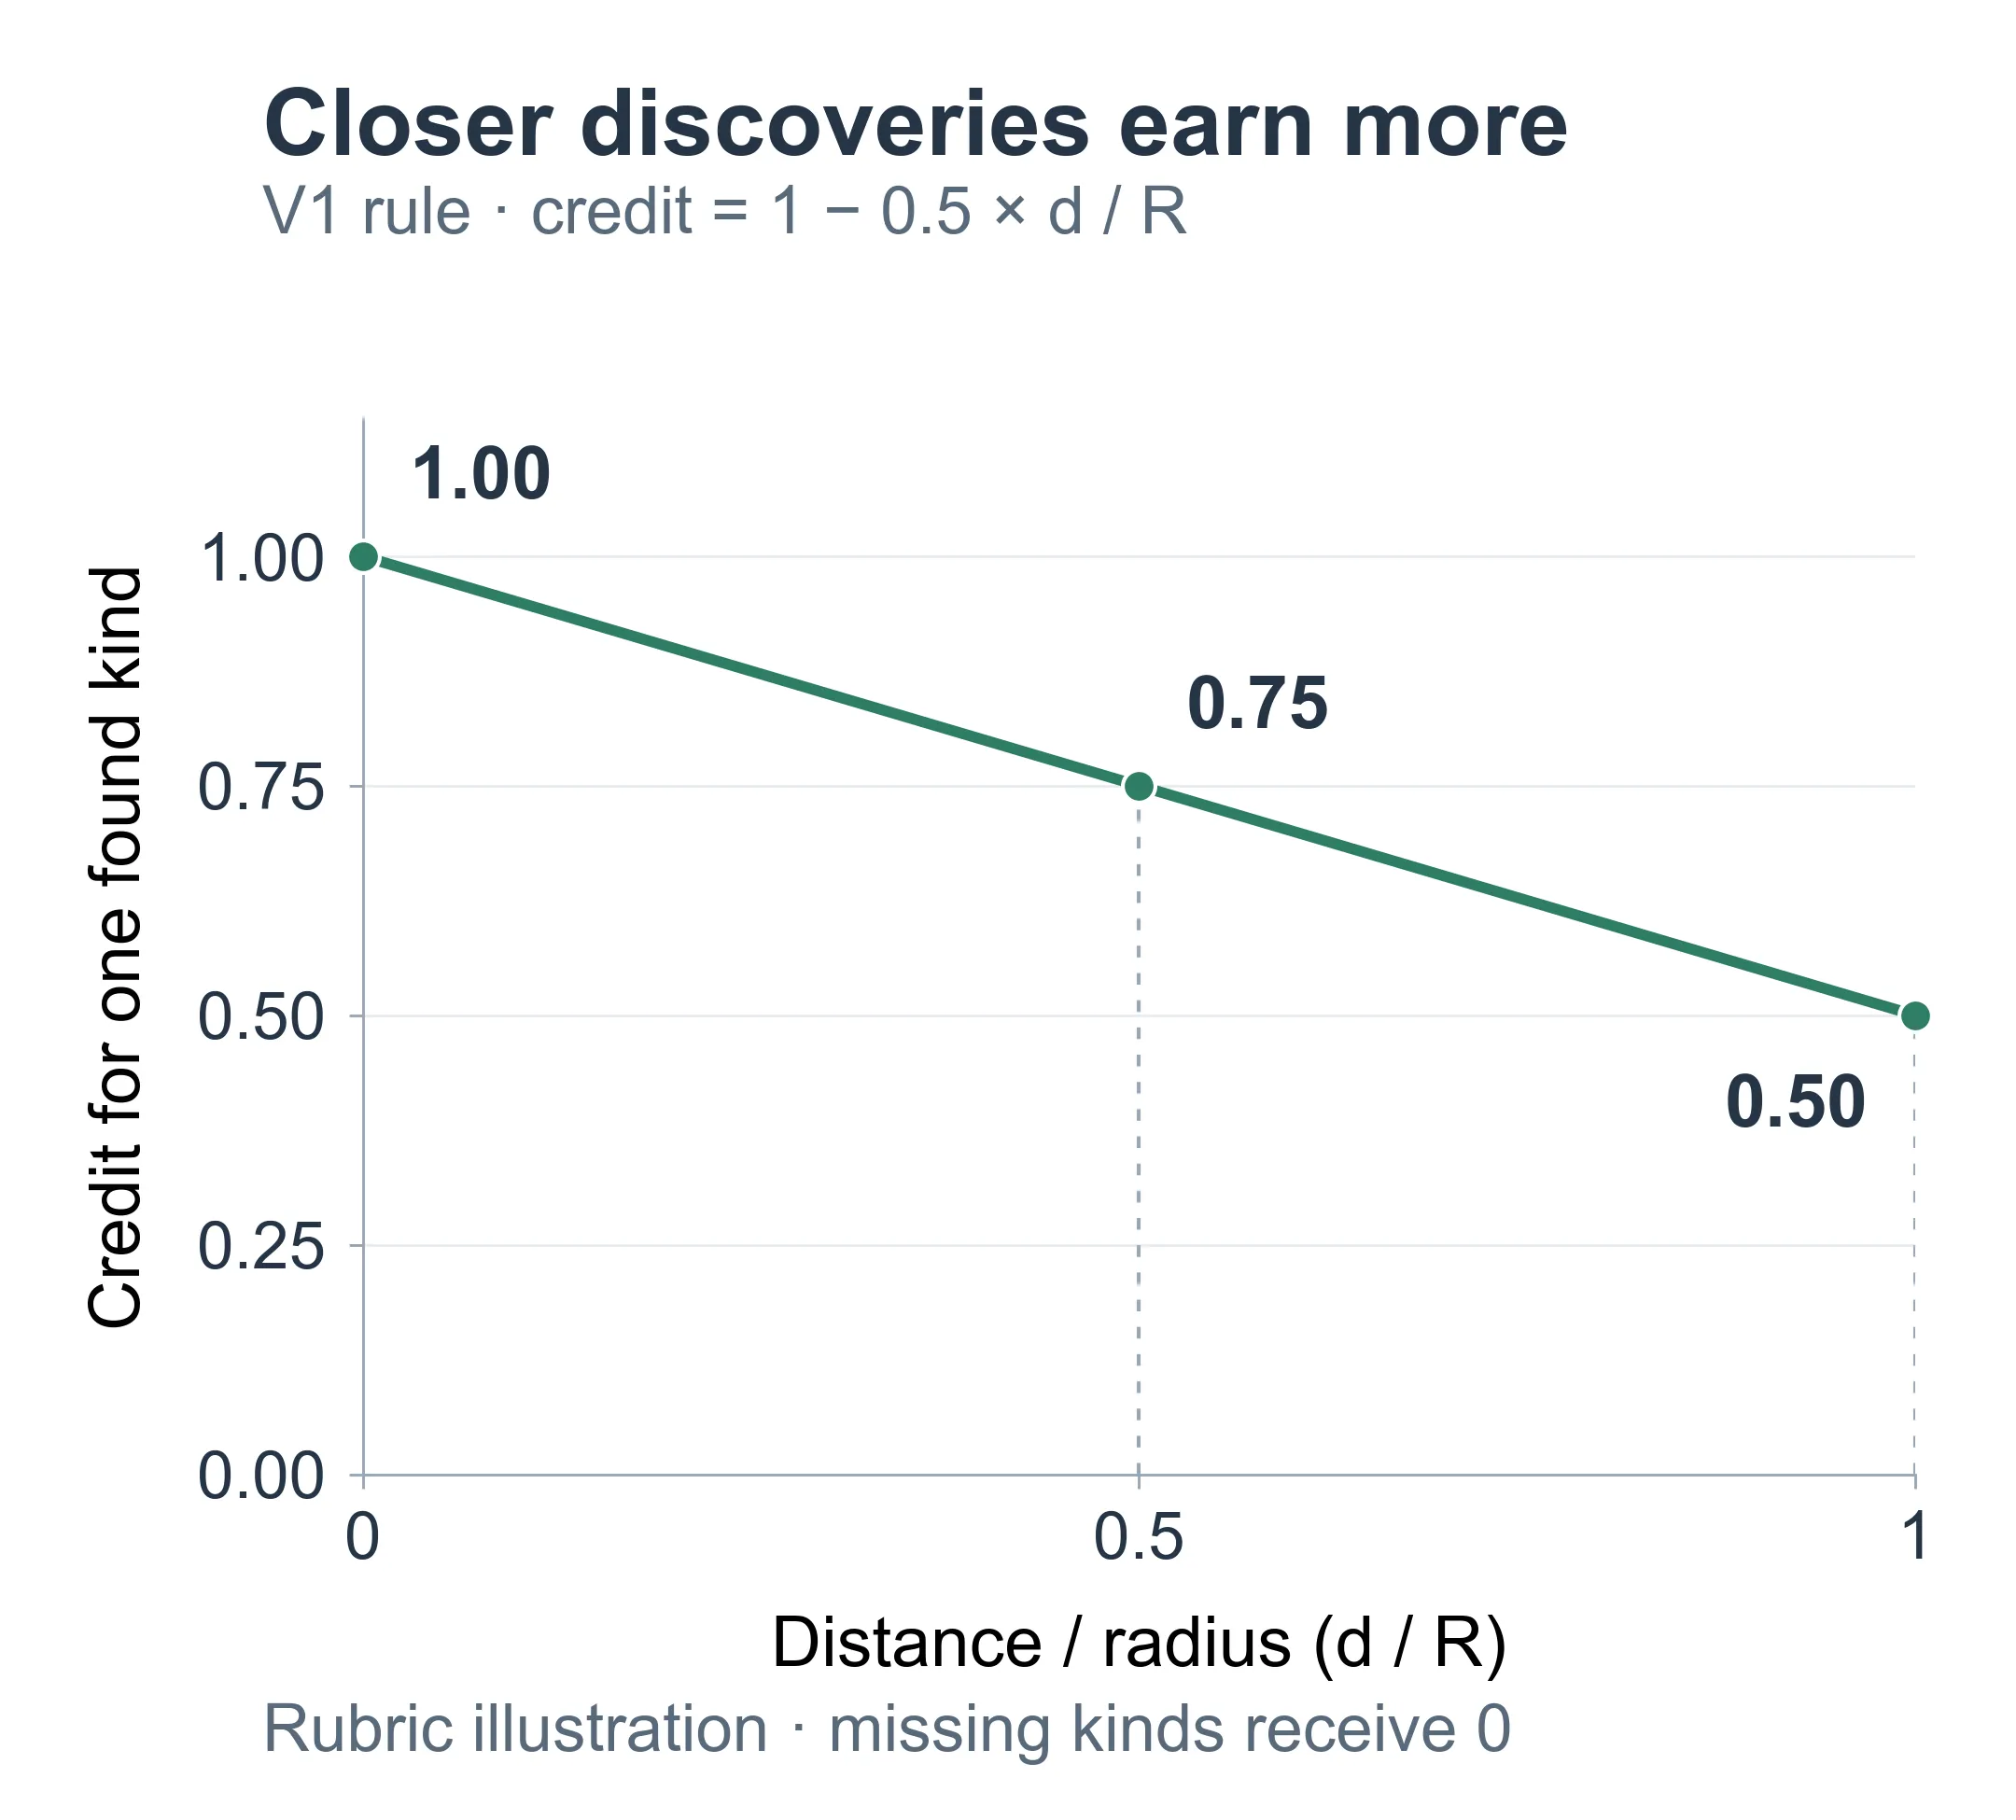
評分規則示意,並非世界樣本。橫軸將距離除以所選半徑;縱軸顯示一個已找到項目的得分。
最終計算讓兩個類別具有相同權重:
index = round(100 × (0.5 × biome average + 0.5 × structure average))
在 Java 26.3 與 Bedrock 26.50 設定中,35 個生態域類群最多可得 50 分,17 個結構類型也最多可得 50 分。四捨五入前,一個類群約可貢獻 50 / 35 = 1.43 個指數分數;一個結構類型約為 50 / 17 = 2.94。兩者都會隨距離增加而減少。如果將全部 52 項合成一份等權重清單,生態域的影響會較大;分成兩半,則維持兩類別的總權重相同。
以下是假設例子,用來說明計算,並非特定種子的結果:
| 類別 | 符合條件項目的各項得分 | 平均值 |
|---|---|---|
| 四個生態域類群 | 1, 0.75, 0.5, 0 | 0.5625 |
| 三個結構類型 | 0.75, 0, 0 | 0.25 |
指數為 round(100 × (0.5 × 0.5625 + 0.5 × 0.25)) = 41。
分組方式、類別等權重,以及邊界保留一半得分,都是修訂版 1 的選擇。我們沒有依玩家喜好調查調整這些選擇。類群或結構類型在參考樣本中較少出現,不會自動得到額外分數。
工具也會區分「已完成搜尋但沒有預測」與「搜尋尚未完整」。如果有限範圍的結構涵蓋情況讓某類型仍未知,就不顯示總分。涵蓋情況未知,既不算成功發現,也不算缺少該類型。
共用計算程式,依版本審查條件
Minecraft 版本支援需要分開決定兩件事:使用哪一個生成模型,以及適用哪些計算條件。
計算器共用一套取樣與評分核心,Java 與 Bedrock 則使用網站現有、各自版本種類的生成模型。明確登錄的資料會將每個支援生成版本連到它的計算條件。規則相同時,各版本可以共用一組條件,不必複製整套計算引擎。
計算條件控制可納入的結構類型、取樣間距、洞穴深度、類別權重與距離得分。生態域目錄來自所選模型版本,再與已審查的類群定義比對。生態域名稱未知或版本不支援時,計算會停止,直到相關條件完成審查。
例如,目前 Java 1.18.2 設定有 29 個可納入的生態域類群和 13 個結構類型;Java 26.3 有 35 個類群與 17 個類型。這些是計算器的分母,不是某個種子的數量。較舊設定不會因其版本模型與條件之外的類別而被扣分。
每個結果都標明版本種類、生成版本與計算修訂版。若分組或權重改變,評分規則就需要新的修訂版,相應參考樣本也必須依新規則評估。這能讓計算容易維護,並保留已儲存結果的含義。
將結果視為一組預測
結果會顯示大字分數、距離得分長條,以及每個符合條件生態域類群和結構類型的圖示。暗色生態域圖示表示「未取樣到」,暗色結構圖示表示「未找到預測」。涵蓋情況未知另有自己的狀態;被排除或版本不適用的類型,則放在評分清單之外。
圖示回答的是哪些種類已出現,貢獻長條則說明扣除距離後,保留了多少可能得分。兩個種子即使類群與類型數相同,只要最近發現的距離不同,分數也可能不同。比較時,請將數量與兩個類別的得分貢獻,連同總分一起看。
結果保留取樣到的地表與洞穴生態域數量、兩個分母,以及最近座標。種子地圖連結可讓你查看那些位置。生態域座標是最近取樣點,不是精確邊界;出生點與地表高度都是估計值。
結構預測使用目前提供的放置與生態域檢查,後續生成仍可能阻止結構出現。Bedrock 使用相容模型,準確度尚未透過獨立遊戲內檢查確認。關於頁面說明網站的證據標籤。
設定只涵蓋預設生成。自訂資料包、大型生態域、超平坦世界,以及世界升級前已生成的區塊,都不在範圍內。請使用你要評估區域當初生成時的版本。
高指數不能證明景色好看、生存容易或戰利品有價值,也不能告訴你實際會走訪圈內多少比例。多樣性分數低的島嶼世界,可能比附近種類很多的種子更適合你。
計算你關心的種子
開啟計算器,輸入種子碼並選擇版本種類與生成版本。Java 也接受文字種子,並將它轉成數字種子;Bedrock 使用數字種子。選好半徑後,再開始計算。
比較總分之前,請先查看各類別。如果某個生態域或結構對你最重要,可用種子搜尋工具搜尋該條件,再用計算器評估周圍多樣性。計算器網址會保留輸入設定,方便回到相同問題。
隨機種子能告訴我們什麼
我們選擇 1,024 個帶正負號的 64 位元偽隨機數字種子,並在 Java 26.3 和 Bedrock 26.50 中評估每個種子。兩組都使用預設主世界生成、2,048 個方塊半徑與計算修訂版 1,包含 35 個可納入生態域類群和 17 個結構類型。相同種子碼構成配對研究,各版本種類的分布分別彙整。全部 2,048 次模型評估都完成,沒有略過或替換失敗、不完整的結果。
我們選擇數字種子時,沒有從已發布目錄刻意挑選。這項研究描述的是計算器在那些設定下的結果,不是玩家選擇留下的世界。
閱讀整體分布
下表描述顯示時已四捨五入的指數。P10 到 P90 是樣本的第 10 與第 90 百分位數;整數同分可能讓兩值之間的比例超過 80%。這個範圍不是信賴區間。
| 生成模型 | 平均指數 | 指數中位數 | P10 到 P90 | 取樣類群數中位數 | 預測類型數中位數 |
|---|---|---|---|---|---|
| Java 26.3 | 62.4 | 62 | 56 到 68 | 35 中的 27 個 | 17 中的 13 個 |
| Bedrock 26.50 | 62.8 | 63 | 57 到 69 | 35 中的 27 個 | 17 中的 13 個 |
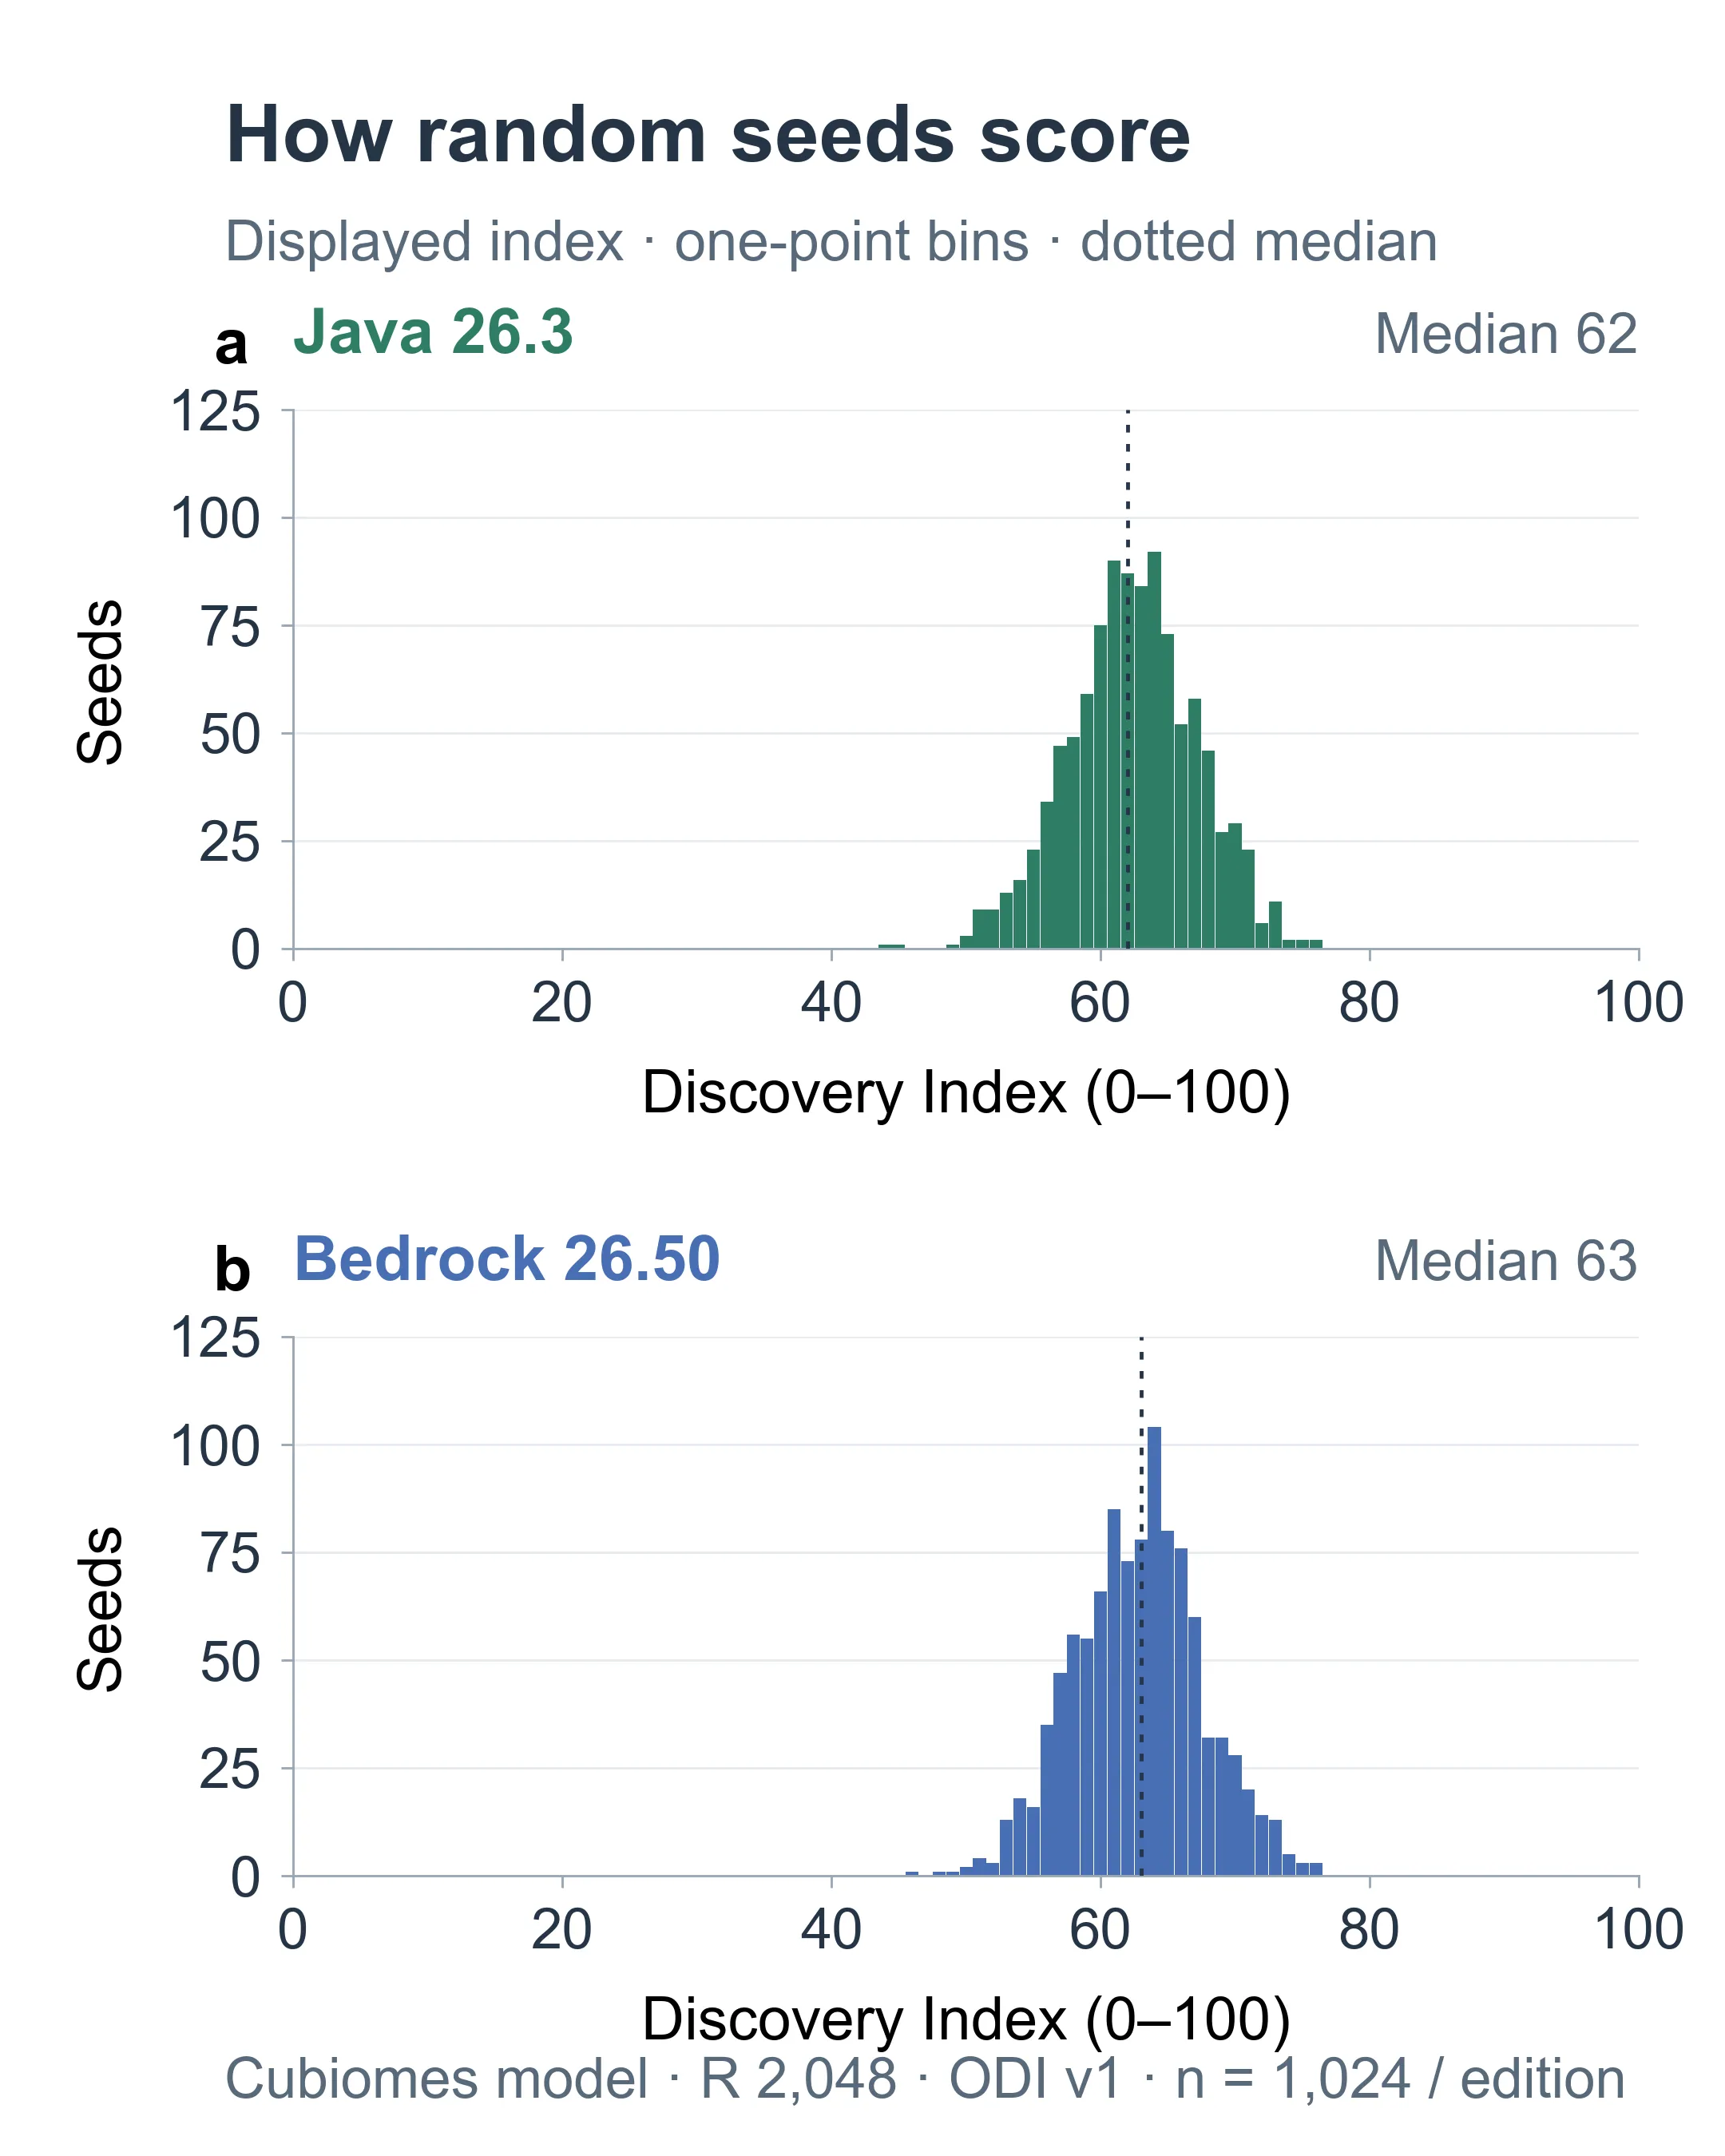
計算器的模型預測。每個窄長條計算一個顯示指數值的種子數。兩張圖都使用完整的 0 到 100 分尺度,以及相同的種子數尺度。
橫軸是顯示指數,縱軸是得到該分數的樣本種子數。長條越高,代表該組樣本中越常出現該分數。Java 分數範圍為 44 到 76,Bedrock 為 46 到 76;各自中位數接近這些觀察分布的中央,遠低於理論最高值 100。
因此,69 分高於這兩組相符參考樣本的中位數。生態域與結構明細能說明哪些發現提供了這些分數。
區分種類廣度與距離得分
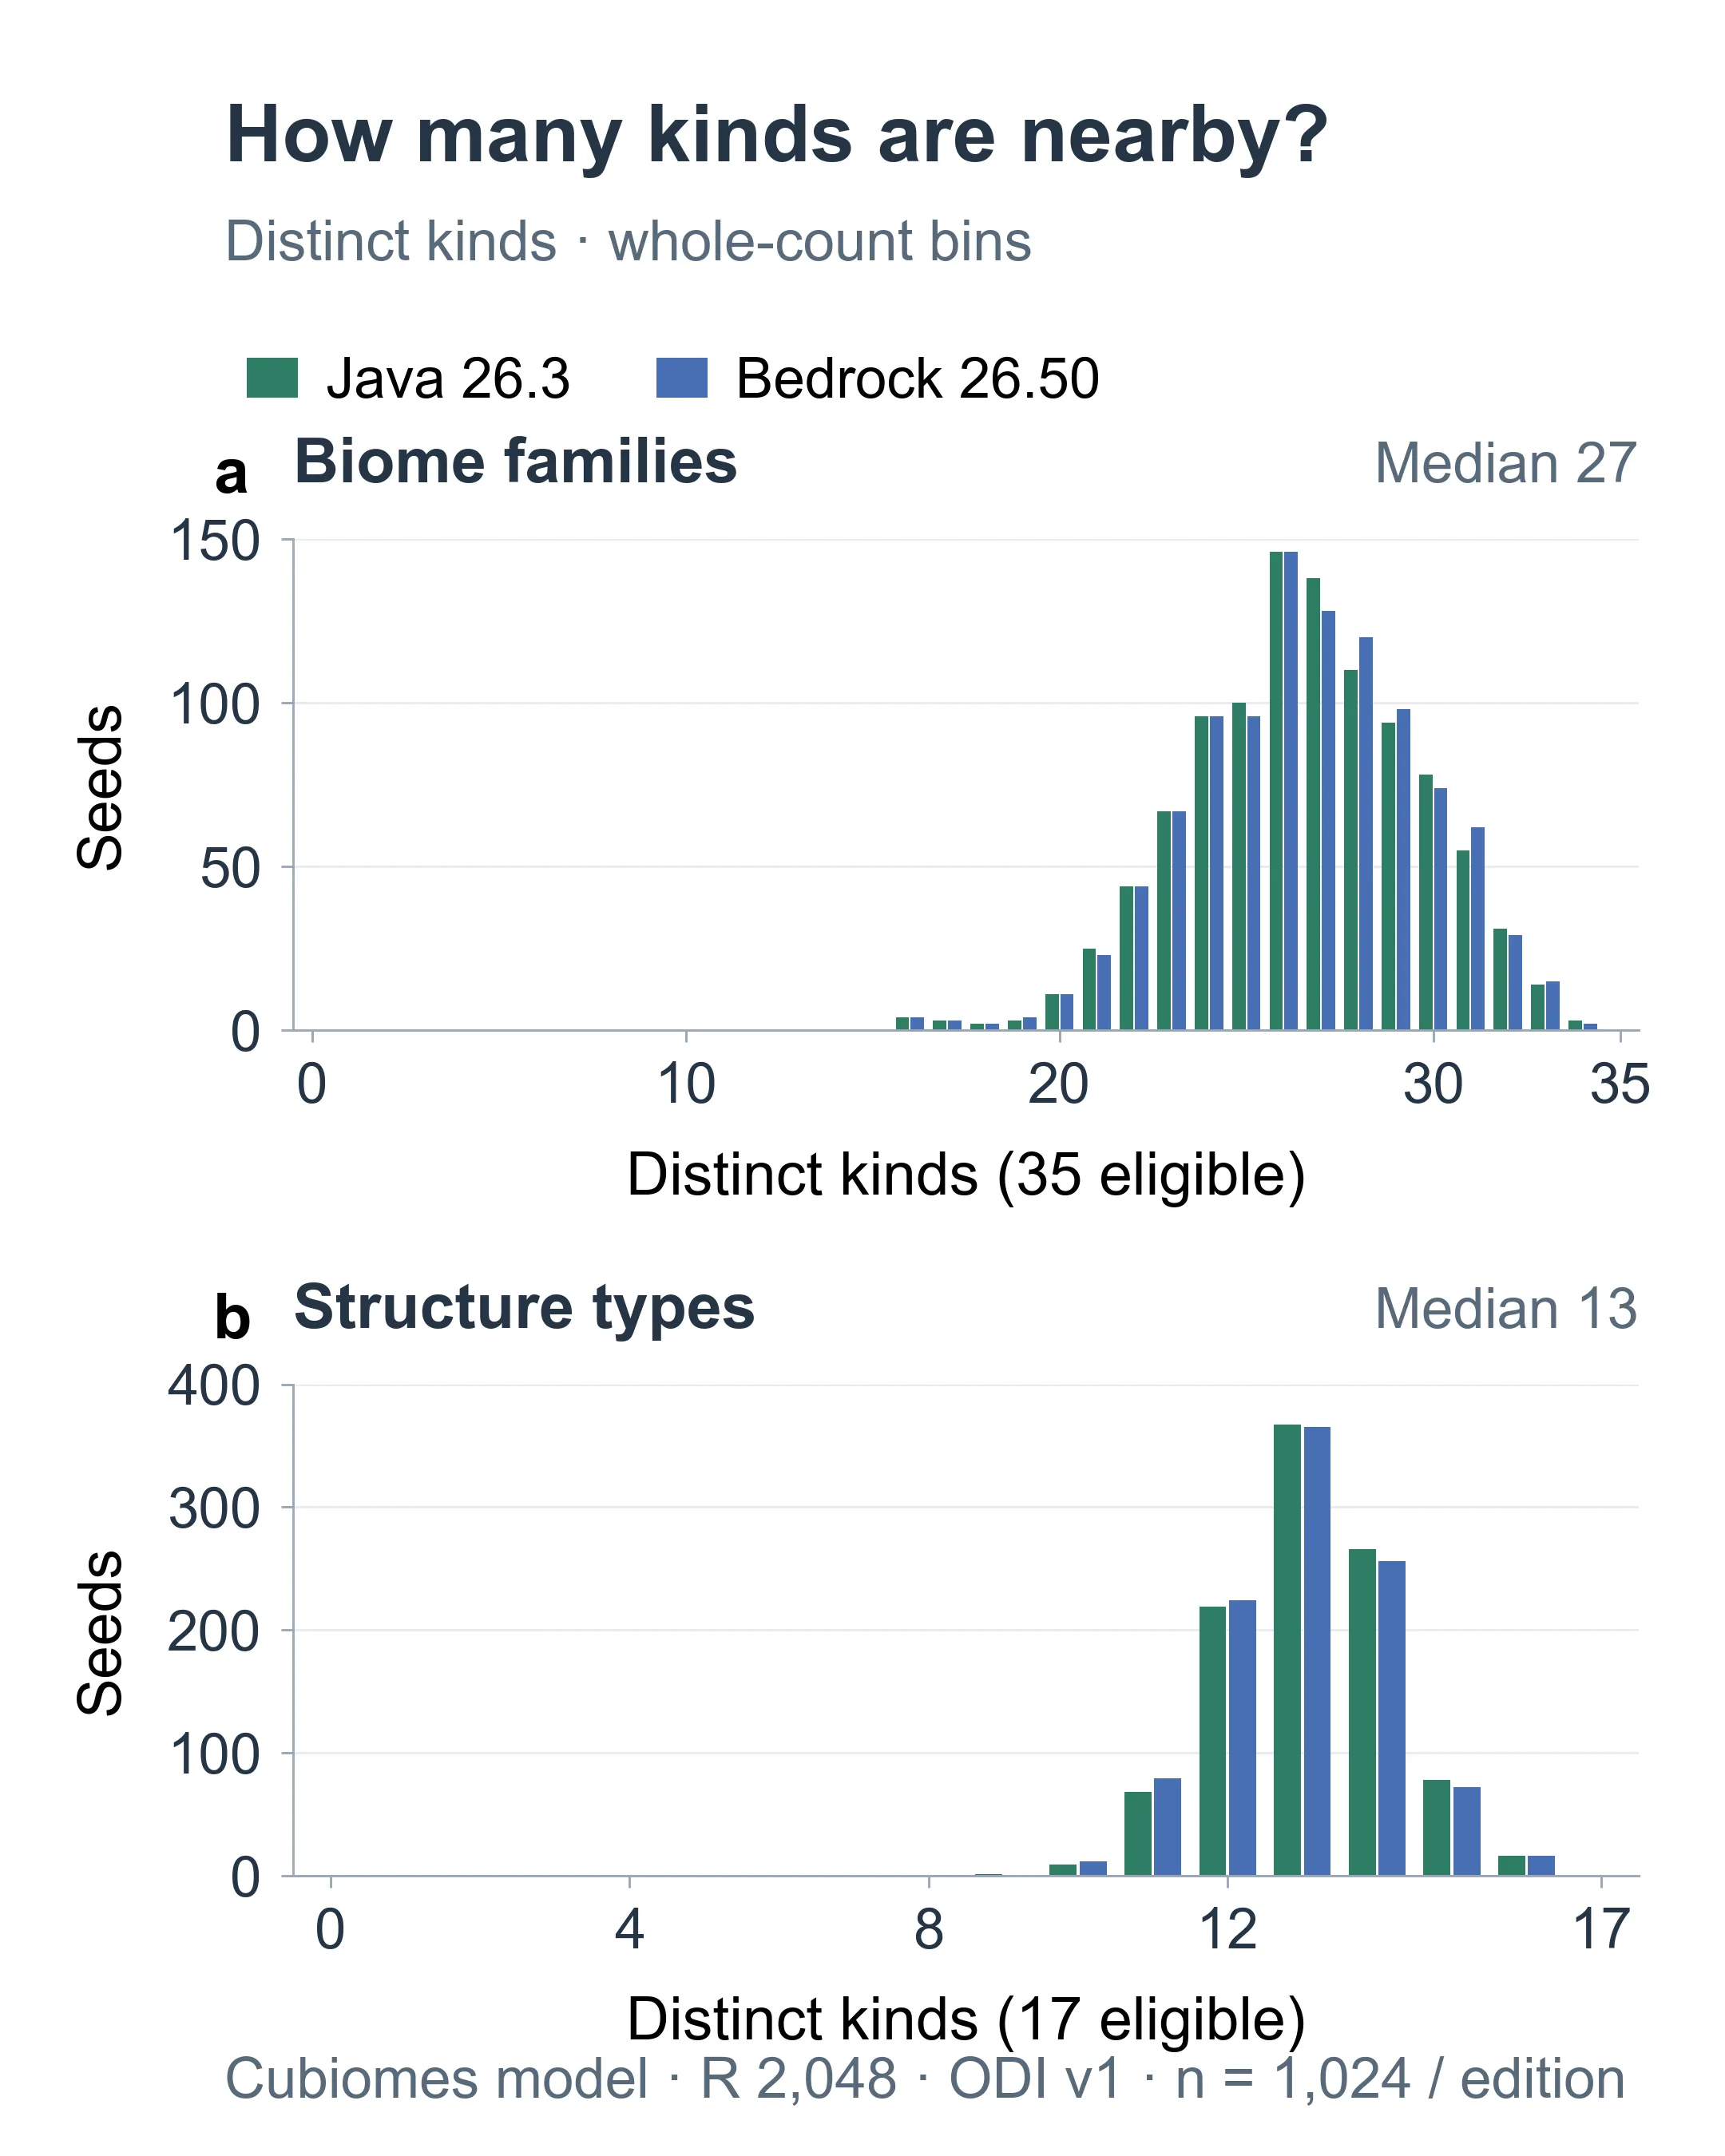
每根長條計算具有某一個類群或結構類型數量的模型種子數,包括地表與洞穴類群。這些數量沒有距離權重。
上圖問的是圈內取樣到多少不同生態域類群;下圖問的是圈內多少不同結構類型有預測。每個整數組內,請分開閱讀綠色與藍色長條;相加會合併兩種版本種類,而它們的參考設定必須維持分開。
兩種版本種類的中位數都是取樣到 27 個類群、預測到 13 個類型。兩組類群數範圍都是 16 到 34;預測類型數在 Java 為 9 到 16,Bedrock 為 10 到 16。在這些模型設定下,沒有樣本世界包含全部 35 個類群或全部 17 個類型。
廣度回答的是出現多少種類,不考慮各種最近取樣點或預測位置有多遠。最終分數也獎勵接近程度,因此不能把 27 個類群或 13 個結構類型,讀成滿分 100 中的類別得分 27 或 13。
查看生態域這一半
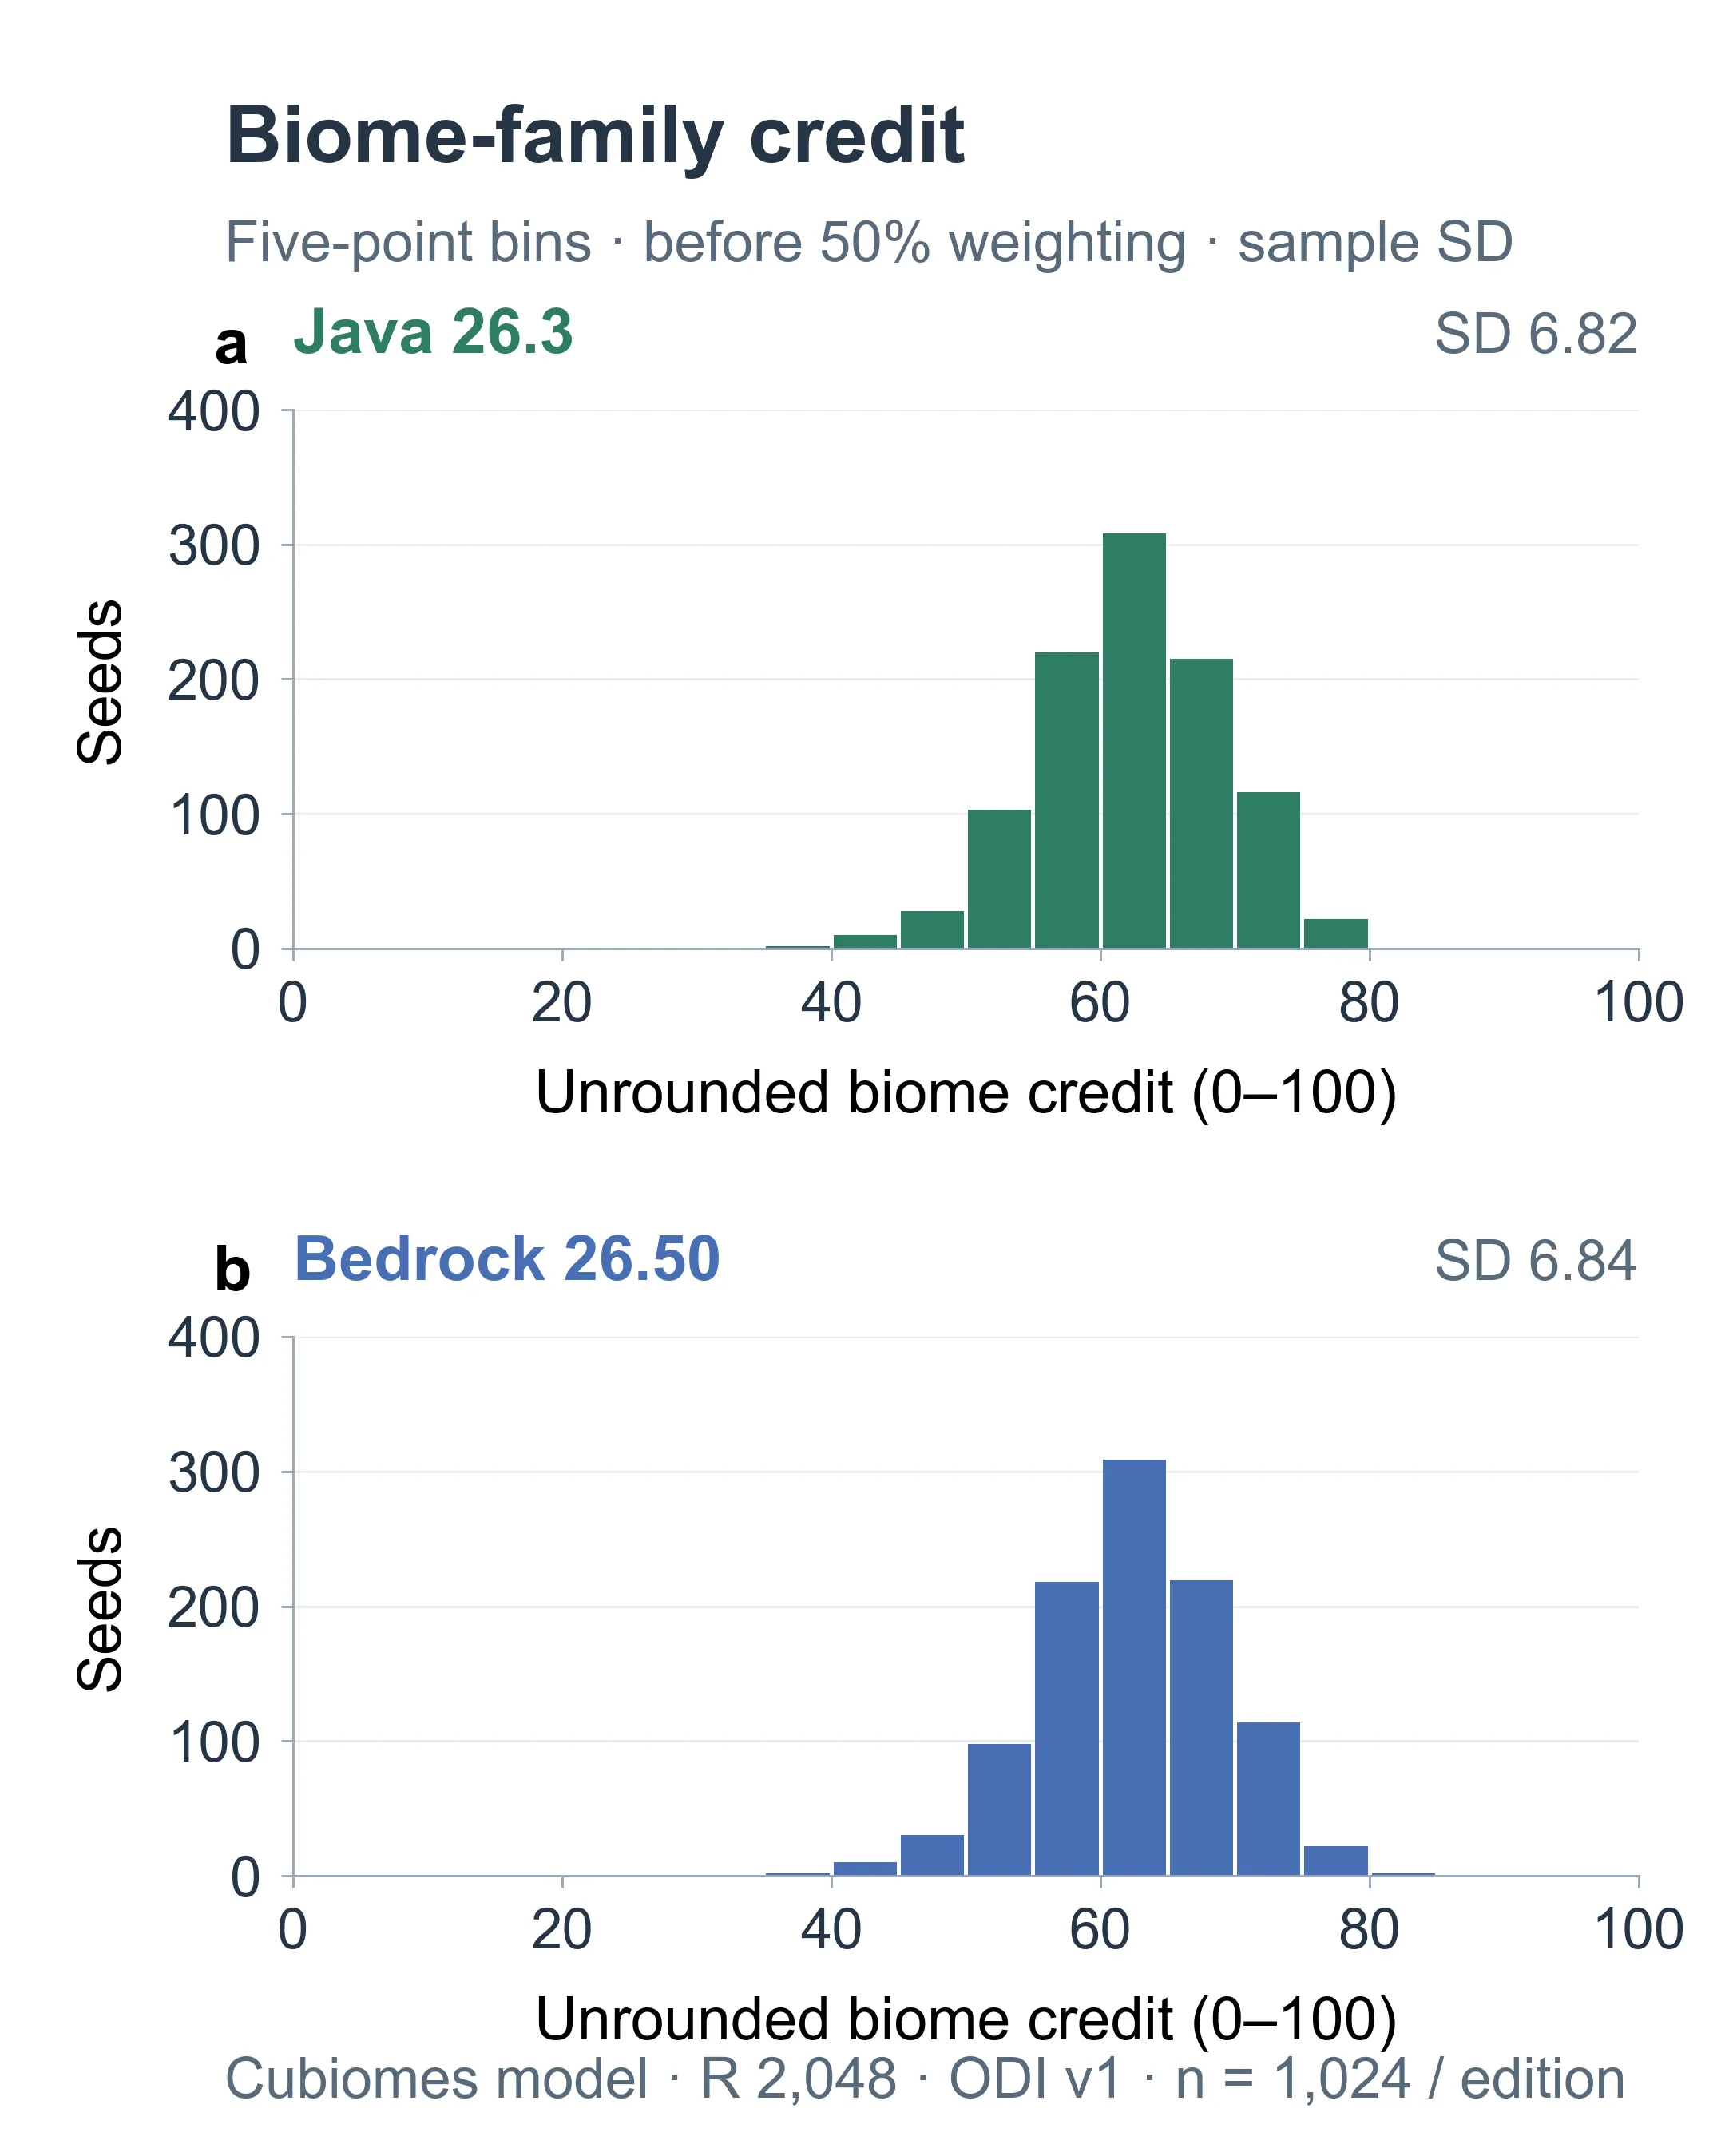
來自同一配對種子樣本的模型預測。這些橫軸值是套用總指數中一半權重之前的生態域分數。
每根長條涵蓋五分區間,不同於總分直方圖的每一整數一根。生態域部分得分 70,會在最終四捨五入前貢獻 35 個指數分數,表示所有可納入類群的平均得分為 0.70,並不表示有 70 個類群或已探索圈內 70%。
這些樣本的生態域分布比下方結構分布更分散。樣本標準差約為 Java 的 6.82 分與 Bedrock 的 6.84 分。NIST 將標準差說明為樣本平均值周圍的分散程度,使用原始單位表示;此處單位是部分分數的分數。它描述種子分數之間的變動,不是平均值的誤差範圍。我們的診斷檢定在多重檢定校正後,也偵測到兩個生態域分布在統計上偏離常態形狀。
類群數量與距離共同造成這種分散。直方圖無法辨識特定種子少了哪個類群;計算器的圖示與座標明細才能回答。
查看結構這一半
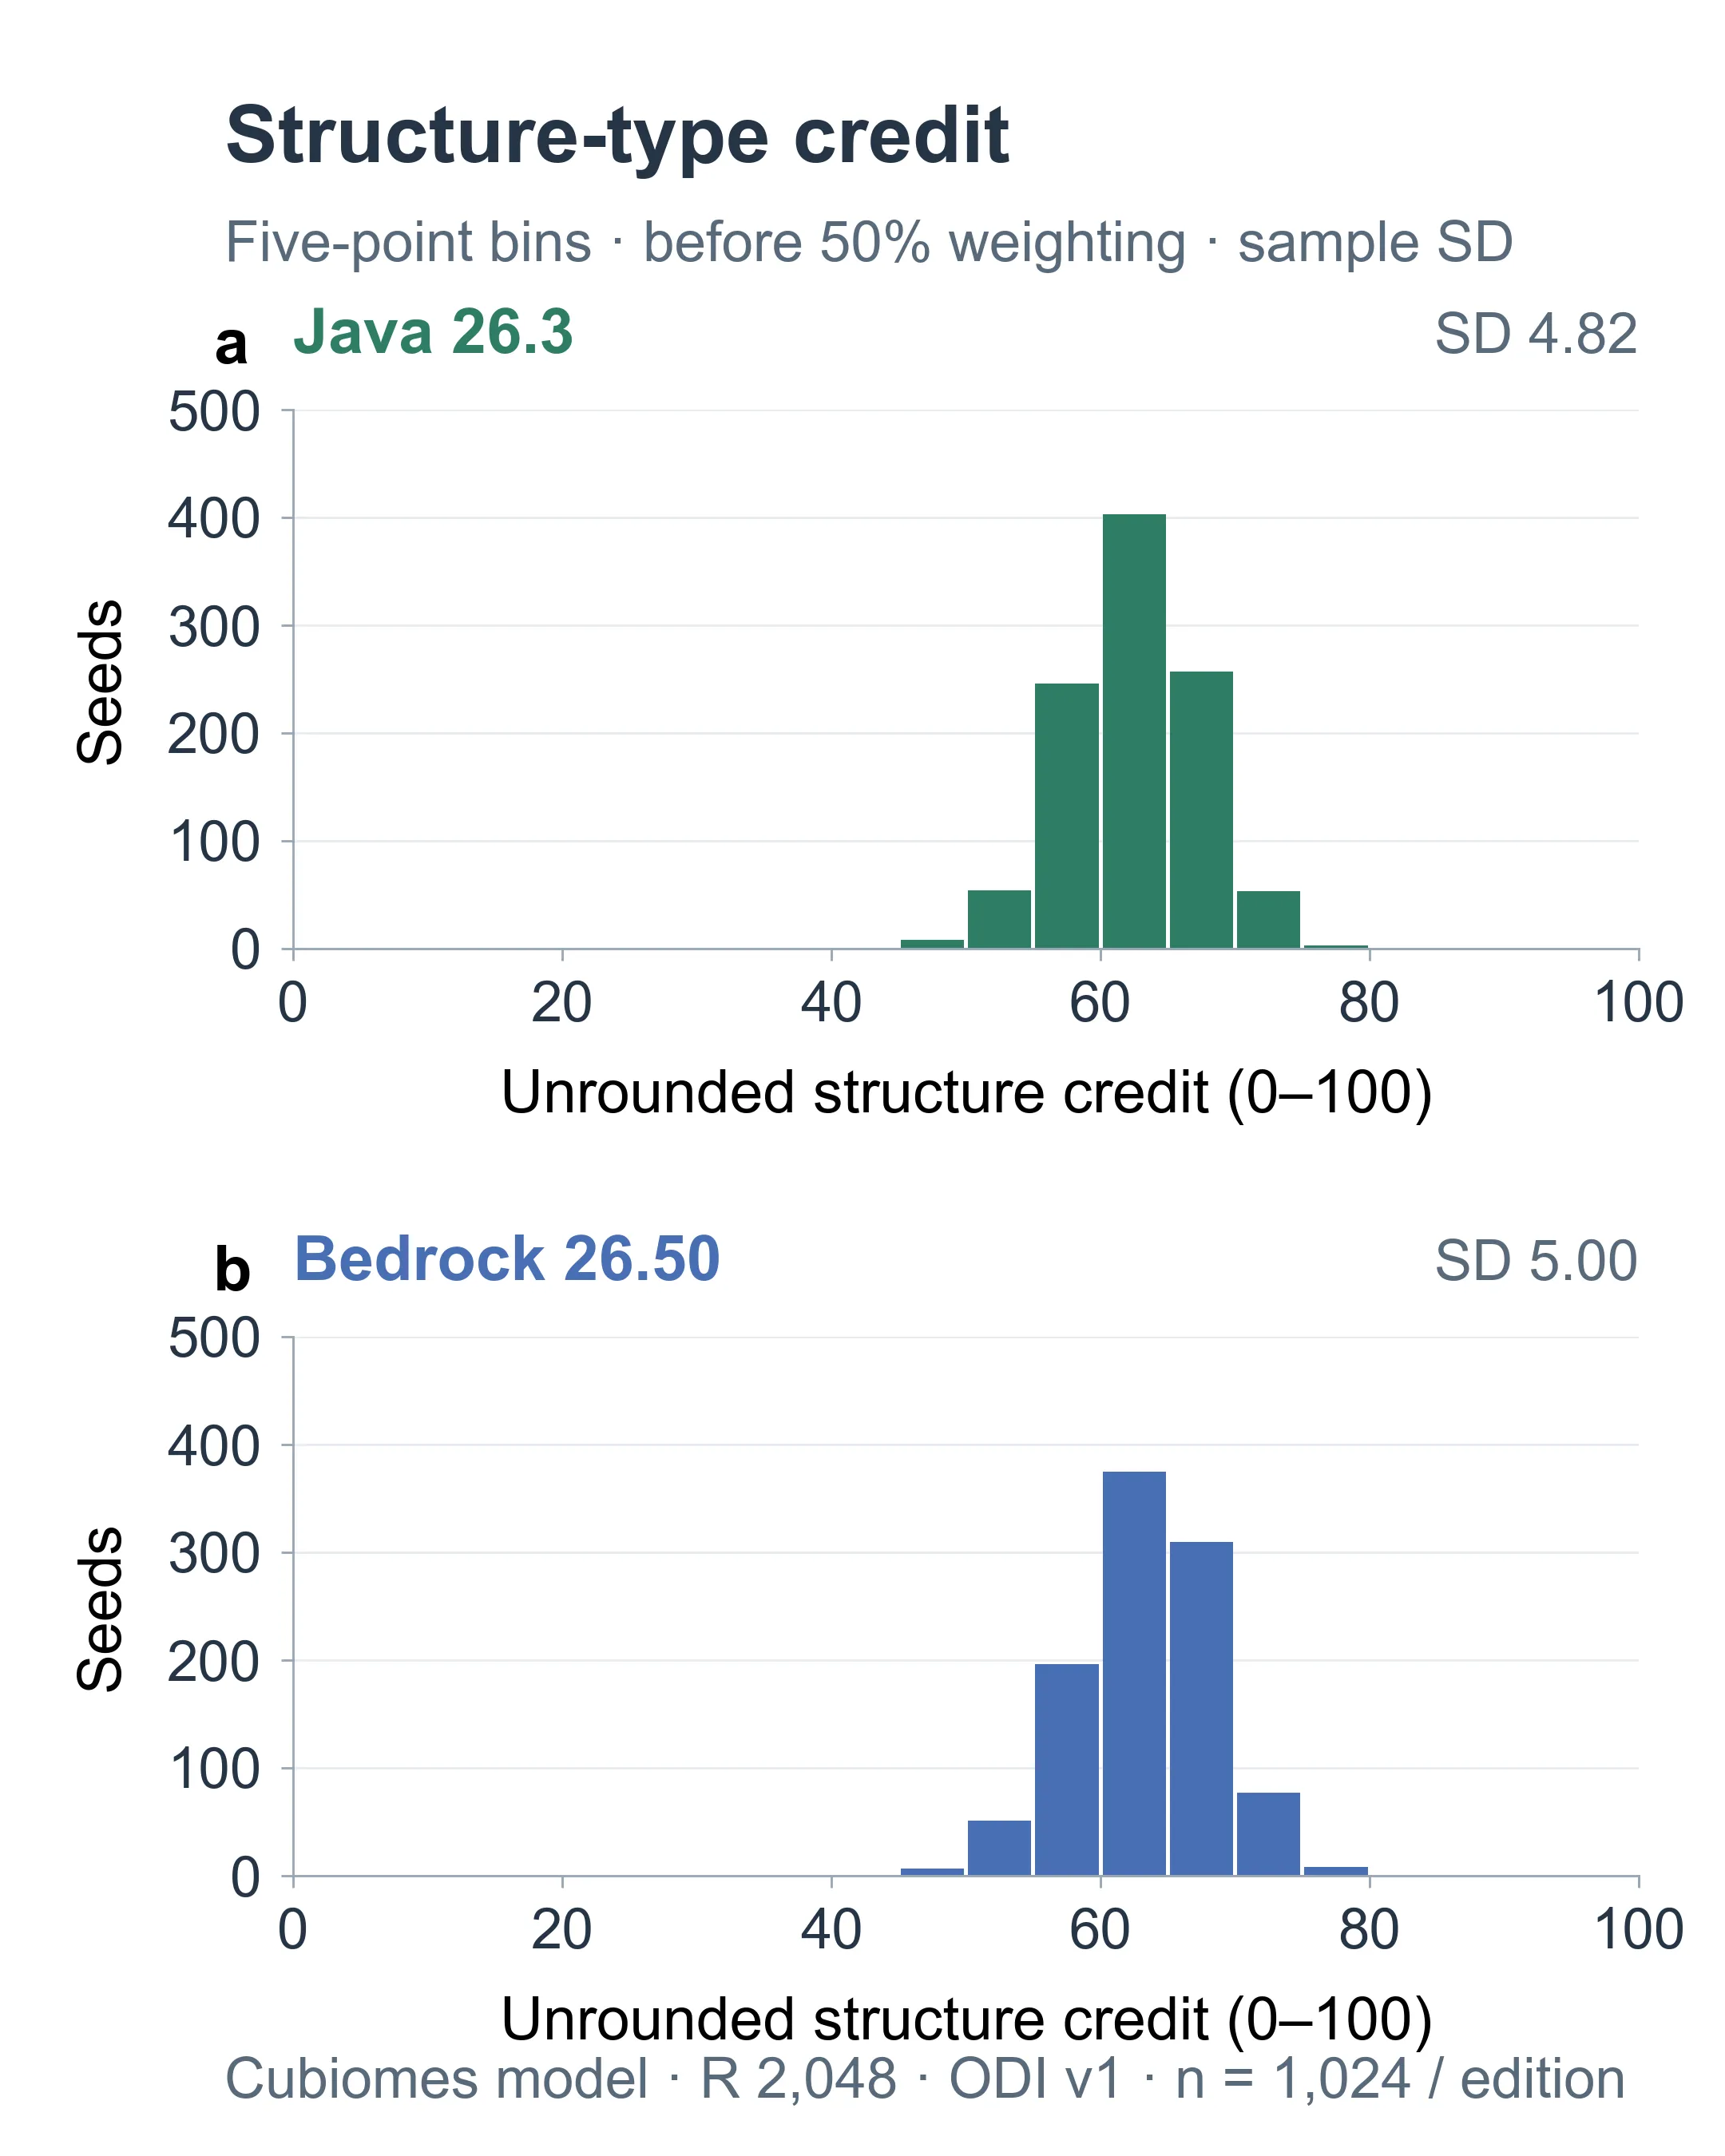
每個模型結構類型只透過最近預測貢獻一次。圖中並不是計算世界內的全部結構。
座標軸與五分組距的意義和生態域部分圖相同,因此可比較橫向分散程度;每張圖則各有自己的縱軸種子數刻度。樣本標準差約為 Java 的 4.82 分與 Bedrock 的 5.00 分,比生態域部分更集中。校正後的常態性檢定沒有拒絕任一結構部分分布的常態假設。
結構這一半結合了出現的類型數與水平接近程度。同類型的額外村莊不會增加多樣性分數;即使預測要塞很近,也沒有為深入地下抵達它所需的耗力額外調整。這些是評分規則的特性,不是對那些世界難易度的研究發現。
總指數會先平均這兩個不同的部分分數,再四捨五入;它的分布可能與任一半不同。在這些樣本組中,即使生態域部分偏離常態,合併結果仍看起來大致呈鐘形。我們直接評估合併結果;結合兩項分數不能建立適用每個版本或半徑的一般規則。
用常態 Q-Q 圖檢查兩端
直方圖適合查看多數分數落在哪裡,但組距可能遮蔽較小的形狀差異。常態 Q-Q 圖將排序後未四捨五入的觀察分數,與依各組樣本觀察平均值和樣本標準差得到的常態分布預期分數比較。NIST 的常態機率圖說明介紹如何從偏離直線參考線的情況,看出與常態形狀的差異。
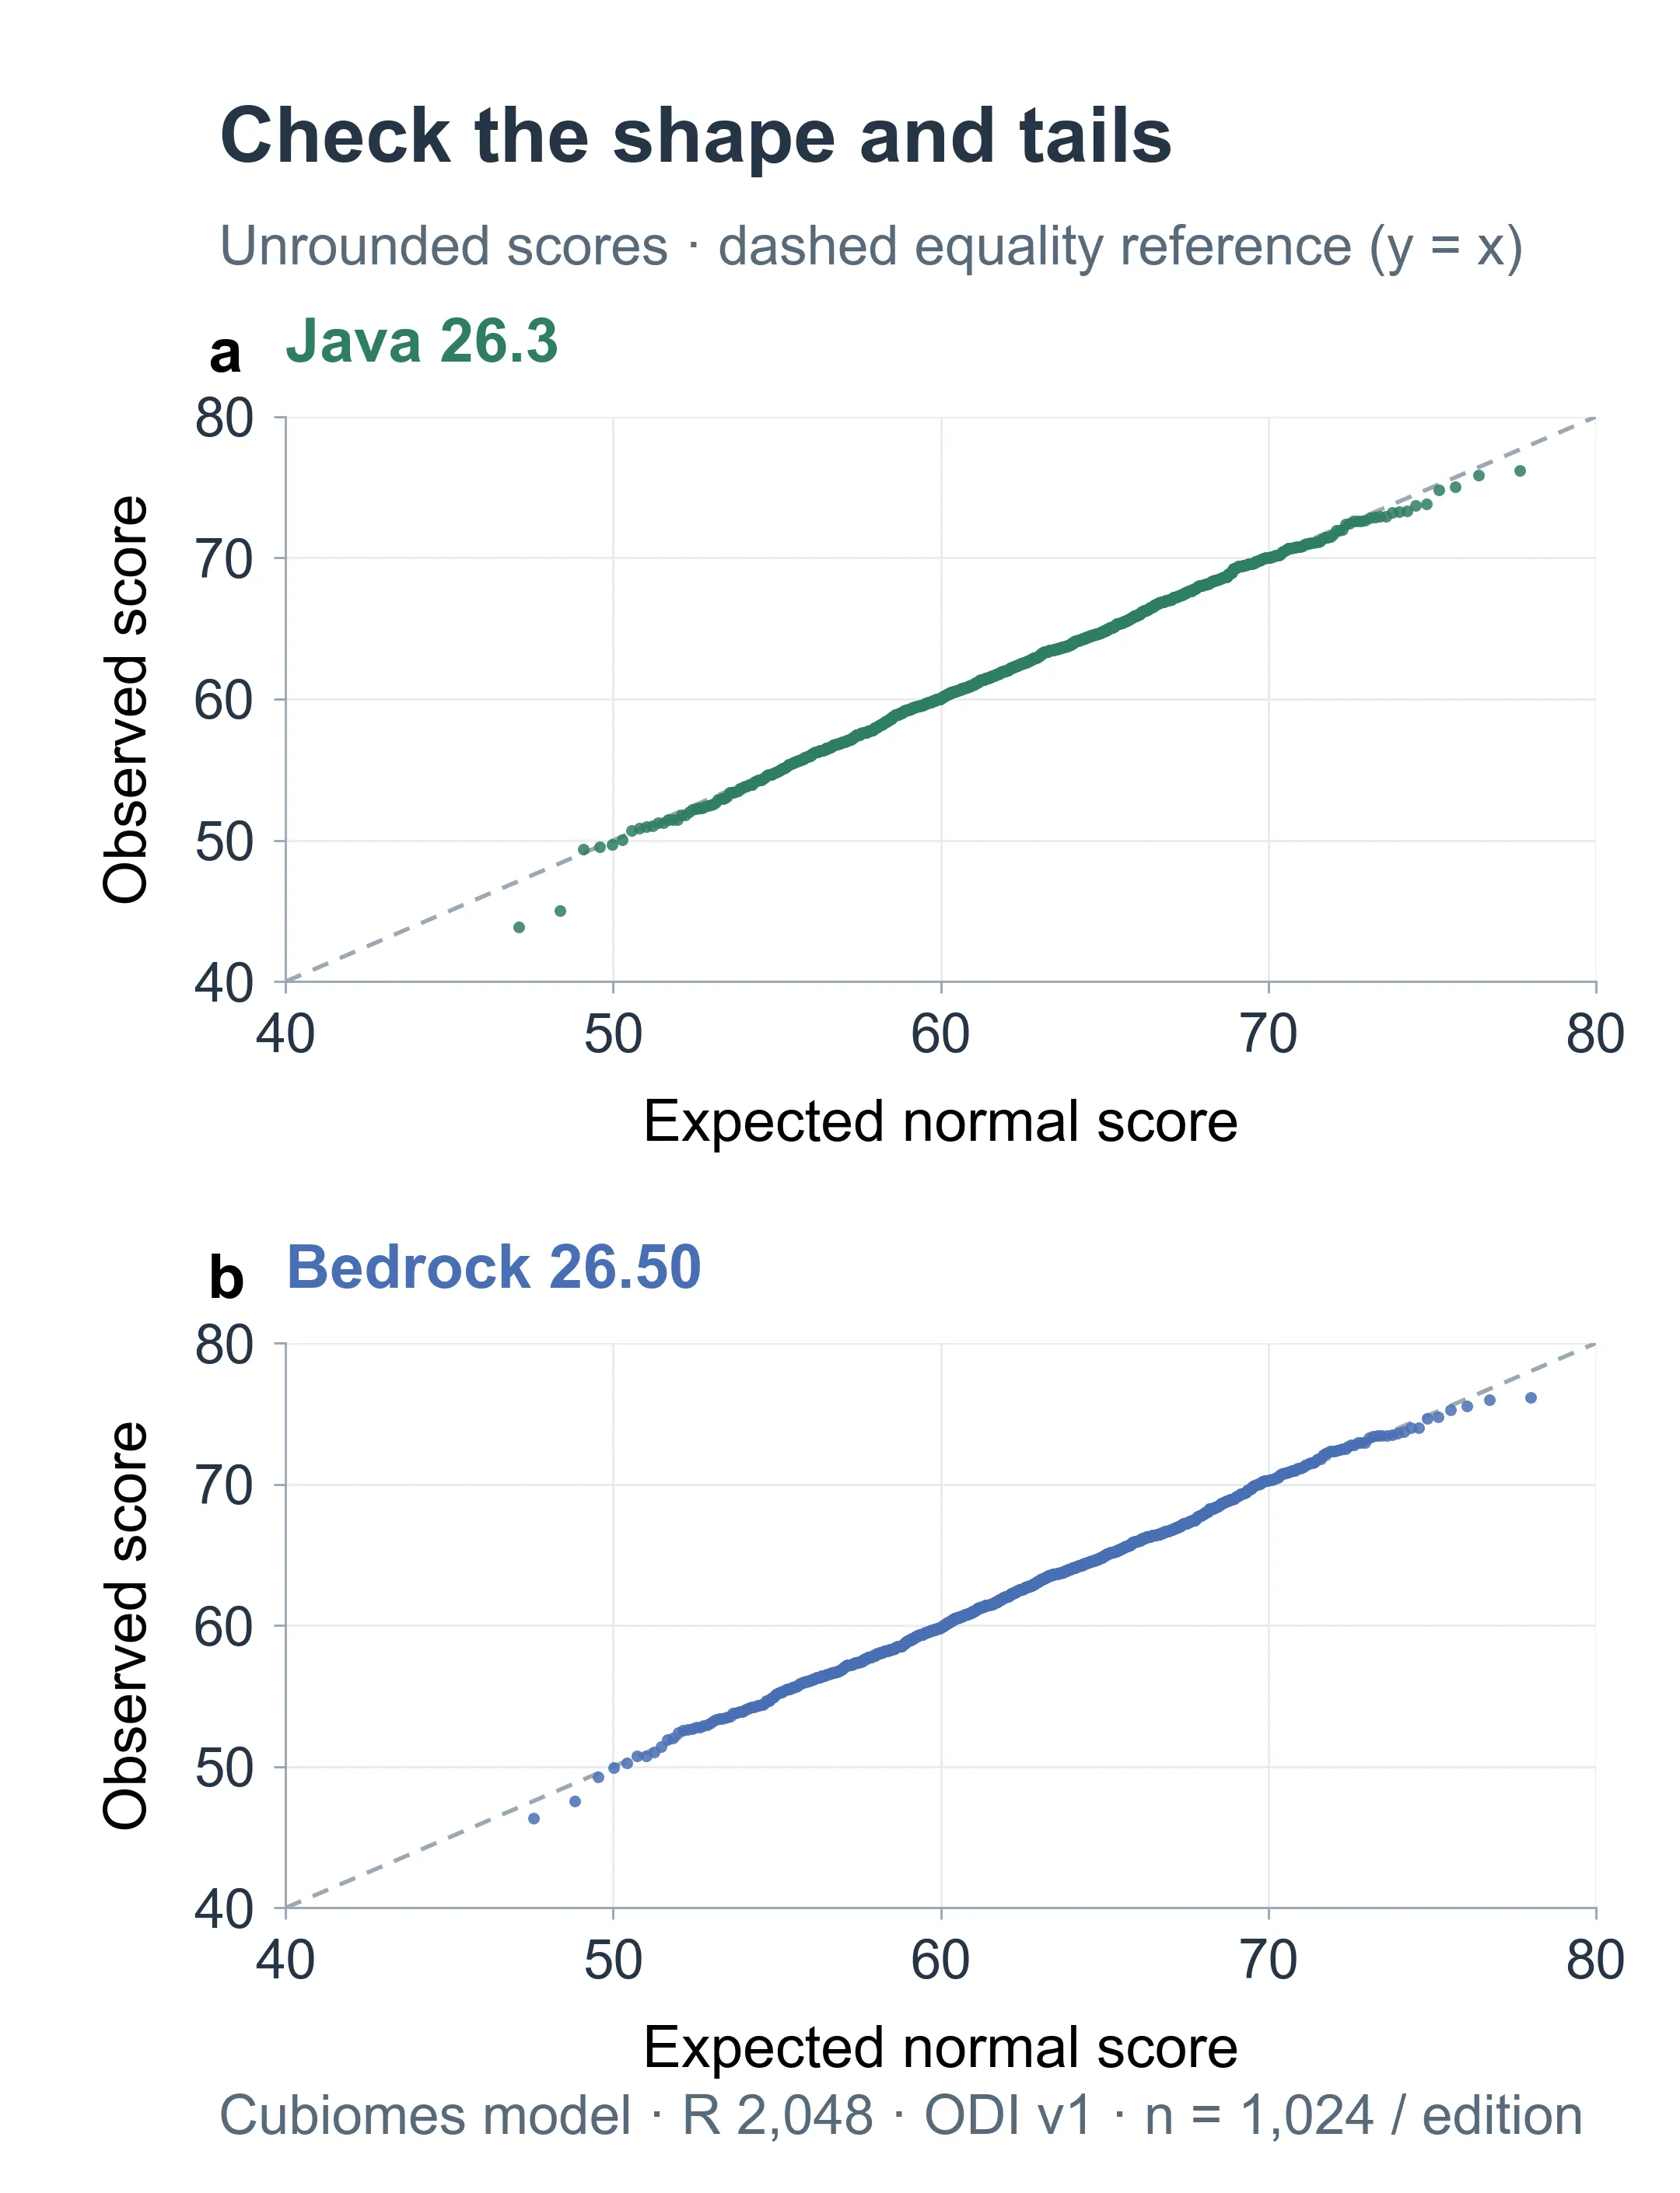
每張圖都包含全部 1,024 個未四捨五入總分。預期常態分數使用樣本平均值與標準差;灰色對角線表示預期值和觀察值相等,不是信賴帶。
兩軸都以指數分數為單位。對角線上的點,其觀察分數就是常態比較在該排序位置預期的分數;線上方的觀察分數較高,線下方較低。最左側與最右側的點代表樣本的低分端與高分端。
大部分點都緊貼對角線,但在極端位置出現偏離。研究異常低分或高分時,這些端點很重要。中央部分貼合,不能建立對觀察範圍之外極罕見分數的可靠常態曲線估計。
常態性檢查能說明什麼
我們對每個版本種類的未四捨五入總分,以及兩個未四捨五入部分分數,使用 SciPy 文件中的 Shapiro-Wilk 檢定。使用未四捨五入值,可以避免把顯示時的整數同分當成連續測量。我們使用 0.05 門檻,並對六項檢定進行 Holm 校正。
| 檢定分布 | Java 26.3 校正後 p 值 | Bedrock 26.50 校正後 p 值 | 0.05 門檻的結果 |
|---|---|---|---|
| 總指數 | 0.667 | 0.667 | 未偵測到偏離 |
| 生態域部分 | 0.0059 | 0.0059 | 偵測到偏離 |
| 結構部分 | 0.231 | 0.472 | 未偵測到偏離 |
總分檢定未校正的 p 值為 Java 的 0.334 與 Bedrock 的 0.660。未拒絕常態假設,與這些特定樣本大致呈鐘形的情況一致;這不能證明常態性、認證生成模型,也不能告訴我們世界好玩的機率。
分數仍受限於 0 到 100。我們使用實際觀察頻率比較種子,不將分數透過擬合的常態曲線轉換。檢定與圖表描述的是這兩組樣本;其他版本種類、版本、半徑或未來評分規則修訂版,都需要自行評估。
完整統計摘要與全部模型樣本結果保留圖表背後的測量。五張分布圖使用相同配對樣本;距離得分圖則用來示範公式。
理解單一分數的背景
範例 Java 26.3 種子 12345,計算器預測為 69 分,取樣到 35 個類群中的 30 個,並預測到 17 個結構類型中的 14 個。扣除距離前,這些涵蓋數量約有 84 分:50 × 30 / 35 + 50 × 14 / 17 ≈ 84。最近距離將它減少到顯示的 69 分。相符參考樣本中,922 個分數較低、27 個相同、75 個較高。
同分很重要。每個顯示的 69 都代表四捨五入後的結果,不同生態域與結構得分組合都可能得到它。低於、等於、高於該顯示分數的確切數量,保留了這些同分情況,也比默默將所有同分種子指定相同的估計常態百分位,更直接說明比較。
版本種類、版本、半徑、評分規則與生成模型完全相符時,計算器會顯示觀察直方圖、樣本中位數、P10 到 P90 範圍,以及低於、等於、高於你分數的數量。其他設定仍會提供發現明細,但目前沒有相符參考樣本。
出現頻率也需要自己的分母。在此半徑的 Java 26.3 樣本組中,模型在 1,024 個種子的 294 個(28.7%)取樣到蘑菇地類群,並在 158 個(15.4%)預測到綠林府邸。這些是估算出生點圓圈內某處的出現情況,不是在該生態域出生的機率,也不是它占全球面積的測量。
總分直方圖回答計算器在此樣本中多常產生特定總分。依稀有程度加權的條件,則是在問特定類群或結構類型出現頻率的另一個問題。修訂版 1 維持各類別內的相同權重,沒有將這些測量轉成稀有加分。這類變更需要符合版本種類、生成版本、半徑與取樣規則的出現頻率基準,以及新的已審查評分規則修訂版。
這是模型預測的參考樣本,不是整體稀有程度百分位、實際遊玩世界的樣本,也不是玩家探索距離的測量。80 分不代表種子的多樣性高於全部種子的 80%。請用計算器比較你打算探索區域內的模型發現,再於種子地圖查看你在意的位置。