seedlookout
Um índice de experiência de sementes de Minecraft pode ajudar a responder uma pergunta prática: quanto terreno diferente e quantos tipos de destino esta semente oferece dentro da área que quero explorar?
Nossa calculadora de experiência de sementes chama esse valor de Índice de descobertas da Superfície. Ele combina famílias de biomas amostradas e tipos de estrutura previstos em uma pontuação de 0 a 100, dando mais crédito às descobertas mais próximas do surgimento estimado. Você escolhe a edição, a versão de geração e o raio. A pontuação descreve a variedade modelada; suas preferências ainda determinam se você quer jogar ali.
Examinamos 1.024 sementes pseudoaleatórias em cada um de dois modelos de geração. Com um raio de 2.048 blocos, a mediana do índice exibido foi 62 em Java 26.3 e 63 em Bedrock 26.50. O teto matemático de 100 da regra de avaliação é uma quantidade diferente do centro dessa amostra. Os gráficos abaixo mostram como contextualizar uma pontuação sem transformá-la em uma avaliação de diversão.
Escolha um raio de exploração
A calculadora oferece raios de 512, 1.024, 2.048 e 4.096 blocos. Cada um é um círculo medido horizontalmente a partir do ponto de surgimento estimado do mundo. Um raio de 2.048 blocos alcança essa distância em todas as direções; isso não significa que uma caminhada de 2.048 blocos passe por tudo dentro dele.
Usamos 2.048 blocos como padrão porque a ferramenta precisa de uma área inicial. Não calibramos essa escolha com uma medida representativa de quanto os jogadores de Minecraft exploram. O guia de exploração da Mojang descreve viagens curtas e aventuras maiores, sem fornecer um raio médio.
Escolha o raio adequado ao mundo que você procura. Um círculo pequeno pergunta sobre a variedade próxima. Um círculo maior inclui mais destinos possíveis e dá à mesma descoberta próxima mais crédito de distância. Compare duas sementes com o mesmo raio para manter a pergunta consistente.
Portanto, o raio muda duas coisas: a área pesquisada e o crédito de uma distância específica. Uma previsão a 1.024 blocos do surgimento recebe 0,75 de crédito com um raio de 2.048, mas 0,875 com um raio de 4.096. A pontuação pode subir no raio maior mesmo antes de encontrar outro tipo. Esse aumento responde a uma pergunta de exploração mais abrangente; não comprova que a própria semente melhorou.
Conte experiências diferentes
Contagens brutas de biomas podem dar vários pontos a terrenos muito semelhantes. A calculadora mantém esses IDs brutos visíveis, mas agrupa variantes relacionadas para a pontuação. Planície e planície de girassóis compartilham uma família. Oceano e oceano profundo compartilham outra. Floresta de flores tem sua própria família; as famílias de cavernas também contam separadamente.
Essas famílias são nossas definições editoriais. A ferramenta não pontua a conclusão de progressos. Cada família elegível tem o mesmo peso na parte de biomas da pontuação. Uma família só é elegível quando o catálogo da versão do modelo de geração selecionado contém um dos seus membros.
Para o terreno da superfície, a calculadora amostra uma grade de 32 blocos na altura aproximada da superfície. Se essa altura retornar um bioma de caverna, ele exclui a amostra da contagem da superfície. Áreas estreitas podem ficar entre os pontos da grade, portanto a contagem bruta é o número de IDs de bioma amostrados, não um inventário exaustivo.
A amostragem de cavernas usa uma grade de 64 blocos em Y -48, -32, -16, 0, 16, 32 and 48, mantendo pontos pelo menos oito blocos abaixo da superfície aproximada. Essas amostras identificam regiões de biomas de caverna. Uma amostra pode estar dentro de terreno sólido, portanto não comprova que haja uma caverna acessível nessas coordenadas. Deslocamento vertical e esforço de escavação não recebem penalidade de distância nesta primeira regra de avaliação.
As estruturas contribuem por tipo: vilas contam uma vez, independentemente de quantas previsões de vila estejam no círculo. Uma vila e um naufrágio acrescentam dois tipos diferentes. A calculadora pesquisa a previsão mais próxima de cada tipo elegível, incluindo destinos subterrâneos quando os critérios da versão os contemplam.
Minas abandonadas são excluídas de todos os perfis porque o buscador disponível de posições mais próximas não consegue estabelecer a cobertura em todos os raios oferecidos. Portanto, a pontuação mede os critérios listados, não todos os possíveis destinos da Superfície.
Dê mais crédito a descobertas próximas
Para cada família ou tipo de estrutura encontrado, a distância horizontal determina seu crédito:
credit = 1 − 0.5 × distance / radius
Uma descoberta no surgimento recebe 1. Na metade do raio, recebe 0,75 e, no limite, 0,5. Um critério não encontrado recebe 0. A média de cada categoria inclui todos os critérios elegíveis no denominador, inclusive os não encontrados.
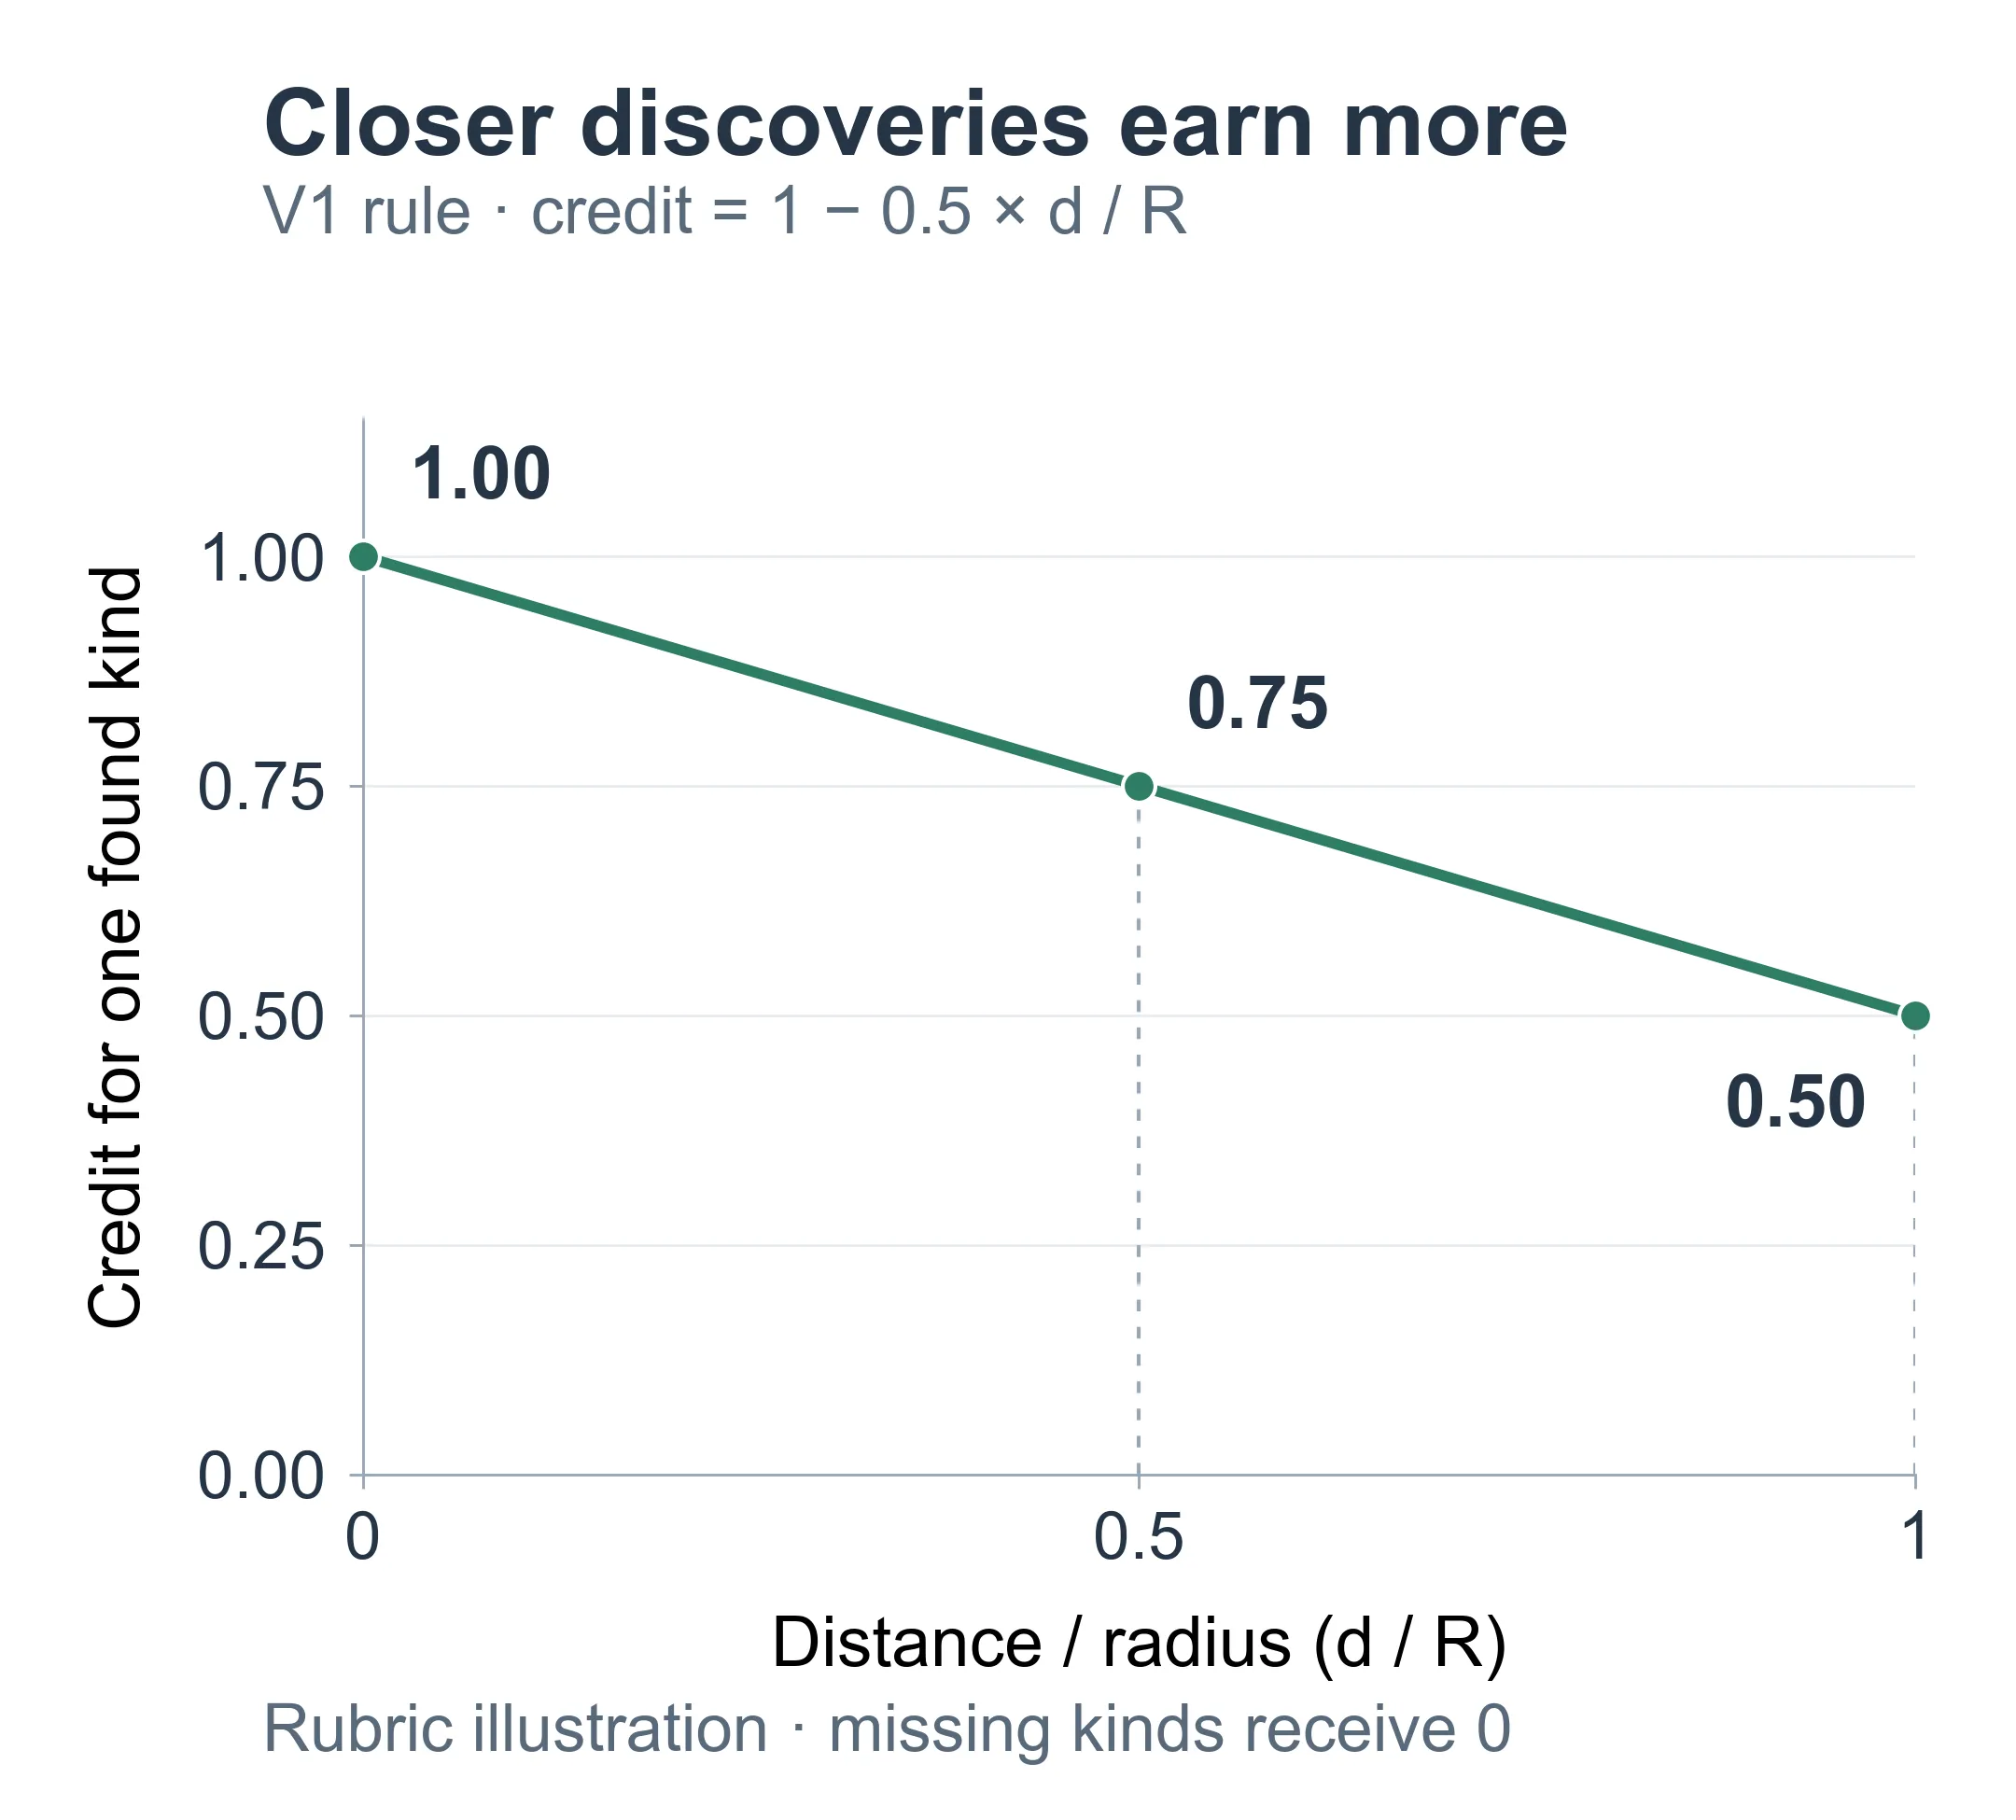
Ilustração da regra de avaliação, não uma amostra de mundos. O eixo horizontal divide a distância pelo raio escolhido; o eixo vertical mostra o crédito de um critério encontrado.
O cálculo final dá o mesmo peso às duas categorias:
index = round(100 × (0.5 × biome average + 0.5 × structure average))
Nos perfis de Java 26.3 e Bedrock 26.50, biomas podem render até 50 pontos em 35 famílias, enquanto estruturas podem render até 50 em 17 tipos. Uma família pode contribuir com cerca de 50 / 35 = 1.43 pontos no índice antes do arredondamento; um tipo de estrutura pode contribuir com cerca de 50 / 17 = 2.94. As duas contribuições diminuem com a distância. Combinar os 52 critérios em uma única lista com pesos iguais daria mais influência aos biomas; as duas metades mantêm os pesos totais iguais.
Este exemplo hipotético mostra a aritmética, não um resultado de uma semente específica:
| Categoria | Créditos entre os critérios elegíveis | Média |
|---|---|---|
| Quatro famílias de biomas | 1; 0,75; 0,5; 0 | 0,5625 |
| Três tipos de estrutura | 0,75; 0; 0 | 0,25 |
O índice é round(100 × (0.5 × 0.5625 + 0.5 × 0.25)) = 41.
O agrupamento, os pesos iguais das categorias e o meio crédito no limite são escolhas da revisão 1. Não ajustamos essas escolhas a uma pesquisa sobre o que os jogadores gostam. Uma família ou tipo de estrutura não recebe crédito extra automaticamente por aparecer com menor frequência na amostra de referência.
A ferramenta também distingue uma busca concluída sem previsão de uma busca incompleta. Quando uma cobertura limitada de estruturas deixa um tipo como desconhecido, a pontuação geral não é exibida. Cobertura desconhecida não contribui como uma descoberta bem-sucedida nem como um tipo ausente.
Compartilhe o código de cálculo e revise os critérios por versão
O suporte às versões de Minecraft exige duas decisões separadas: qual modelo de geração usar e quais critérios de cálculo se aplicam.
A calculadora compartilha um único núcleo de amostragem e pontuação. Java e Bedrock usam os modelos de geração específicos de cada edição já existentes no site. Um registro explícito conecta cada versão de geração compatível aos seus critérios de cálculo. Versões podem compartilhar uma configuração de critérios quando as regras são iguais; não precisam de cópias separadas do motor da calculadora.
Os critérios controlam tipos de estrutura elegíveis, espaçamento da amostragem, profundidades de caverna, pesos das categorias e crédito de distância. O catálogo de biomas vem da versão do modelo selecionado e é comparado às definições revisadas de famílias. Um nome de bioma desconhecido ou uma versão sem suporte interrompe o cálculo até que seus critérios sejam revisados.
Por exemplo, o perfil atual de Java 1.18.2 tem 29 famílias elegíveis de biomas e 13 tipos de estrutura. Java 26.3 tem 35 famílias e 17 tipos. Esses são denominadores da calculadora, não contagens de uma semente individual. O perfil antigo nunca é penalizado por categorias fora do modelo e dos critérios da sua versão.
Cada resultado identifica a edição, a versão de geração e a revisão do cálculo. Se o agrupamento ou os pesos mudarem, a regra de avaliação precisa de uma nova revisão. A amostra de referência correspondente também deve ser avaliada com essas regras. Isso facilita a manutenção do cálculo e preserva o significado de um resultado salvo.
Leia o resultado como um conjunto de previsões
O resultado apresenta uma pontuação em destaque, barras de crédito de distância e ícones de todas as famílias elegíveis de biomas e tipos de estrutura. Ícones de bioma esmaecidos significam “Sem amostra”; ícones de estrutura esmaecidos significam “Nenhuma previsão encontrada”. Cobertura desconhecida tem seu próprio estado, e tipos excluídos ou inelegíveis para a versão ficam fora das listas pontuadas.
Os conjuntos de ícones mostram quais tipos foram representados. As barras de contribuição explicam quanto do crédito possível restou depois do desconto por distância. Duas sementes podem ter as mesmas contagens de famílias e tipos, mas pontuações diferentes se suas descobertas mais próximas estiverem a distâncias diferentes. Mantenha as contagens e as duas contribuições de categoria junto do número geral ao compará-las.
O resultado conserva as contagens de biomas amostrados da superfície e de cavernas, os dois denominadores e as coordenadas mais próximas. Os links do mapa de sementes permitem examinar esses locais. Uma coordenada de bioma é o ponto amostrado mais próximo, não o limite exato do bioma. Surgimento e altura da superfície são estimativas.
As previsões de estruturas usam as verificações disponíveis de posicionamento e bioma; a geração posterior ainda pode impedir uma estrutura. Bedrock usa um modelo de compatibilidade cuja precisão não foi verificada de forma independente no jogo. A página Sobre explica os rótulos de evidência do site.
O perfil abrange a geração padrão. Pacotes de dados personalizados, Biomas grandes, mundos superplanos e chunks existentes gerados antes da atualização de um mundo ficam fora do seu escopo. Use a versão que gerou a área que você está avaliando.
Um índice alto não comprova paisagens atraentes, sobrevivência fácil ou itens valiosos. Também não informa qual parte do círculo você realmente visitará. Um mundo de ilhas com uma pontuação baixa de variedade pode agradar mais a você do que uma semente com muitas categorias próximas.
Calcule uma semente que interessa a você
Abra a calculadora, digite uma semente e escolha a edição e a versão de geração. Java também aceita texto de semente e o converte em uma semente numérica; Bedrock aceita uma semente numérica. Escolha um raio e calcule.
Examine a divisão por categorias antes de comparar os números finais. Se um bioma ou estrutura específico for sua prioridade, use o buscador de sementes para pesquisar essa condição e depois avalie a variedade ao redor com a calculadora. A URL da calculadora conserva suas configurações de entrada para que você possa voltar à mesma pergunta.
O que sementes aleatórias mostram
Selecionamos 1.024 sementes numéricas pseudoaleatórias de 64 bits com sinal e avaliamos cada semente em Java 26.3 e Bedrock 26.50. As duas coortes usam a geração padrão da Superfície, um raio de 2.048 blocos e a revisão 1 do cálculo, com 35 famílias elegíveis de biomas e 17 tipos de estrutura. Os mesmos números de semente formam um estudo pareado; a distribuição de cada edição é resumida separadamente. Todas as 2.048 avaliações do modelo foram concluídas, sem omitir ou substituir resultados com falha ou incompletos.
Selecionamos sementes numéricas sem fazer uma seleção a partir do catálogo publicado. Este estudo descreve a calculadora nessas configurações; não mede mundos que jogadores escolheram manter.
Leia a distribuição geral
A tabela descreve o índice exibido e arredondado. P10 a P90 mostra os valores dos percentis 10 e 90 da amostra. Empates entre números inteiros fazem a proporção entre esses valores poder superar 80%; o intervalo não é um intervalo de confiança.
| Modelo de geração | Índice médio | Mediana do índice | P10 a P90 | Mediana de famílias amostradas | Mediana de tipos previstos |
|---|---|---|---|---|---|
| Java 26.3 | 62,4 | 62 | 56 a 68 | 27 de 35 | 13 de 17 |
| Bedrock 26.50 | 62,8 | 63 | 57 a 69 | 27 de 35 | 13 de 17 |
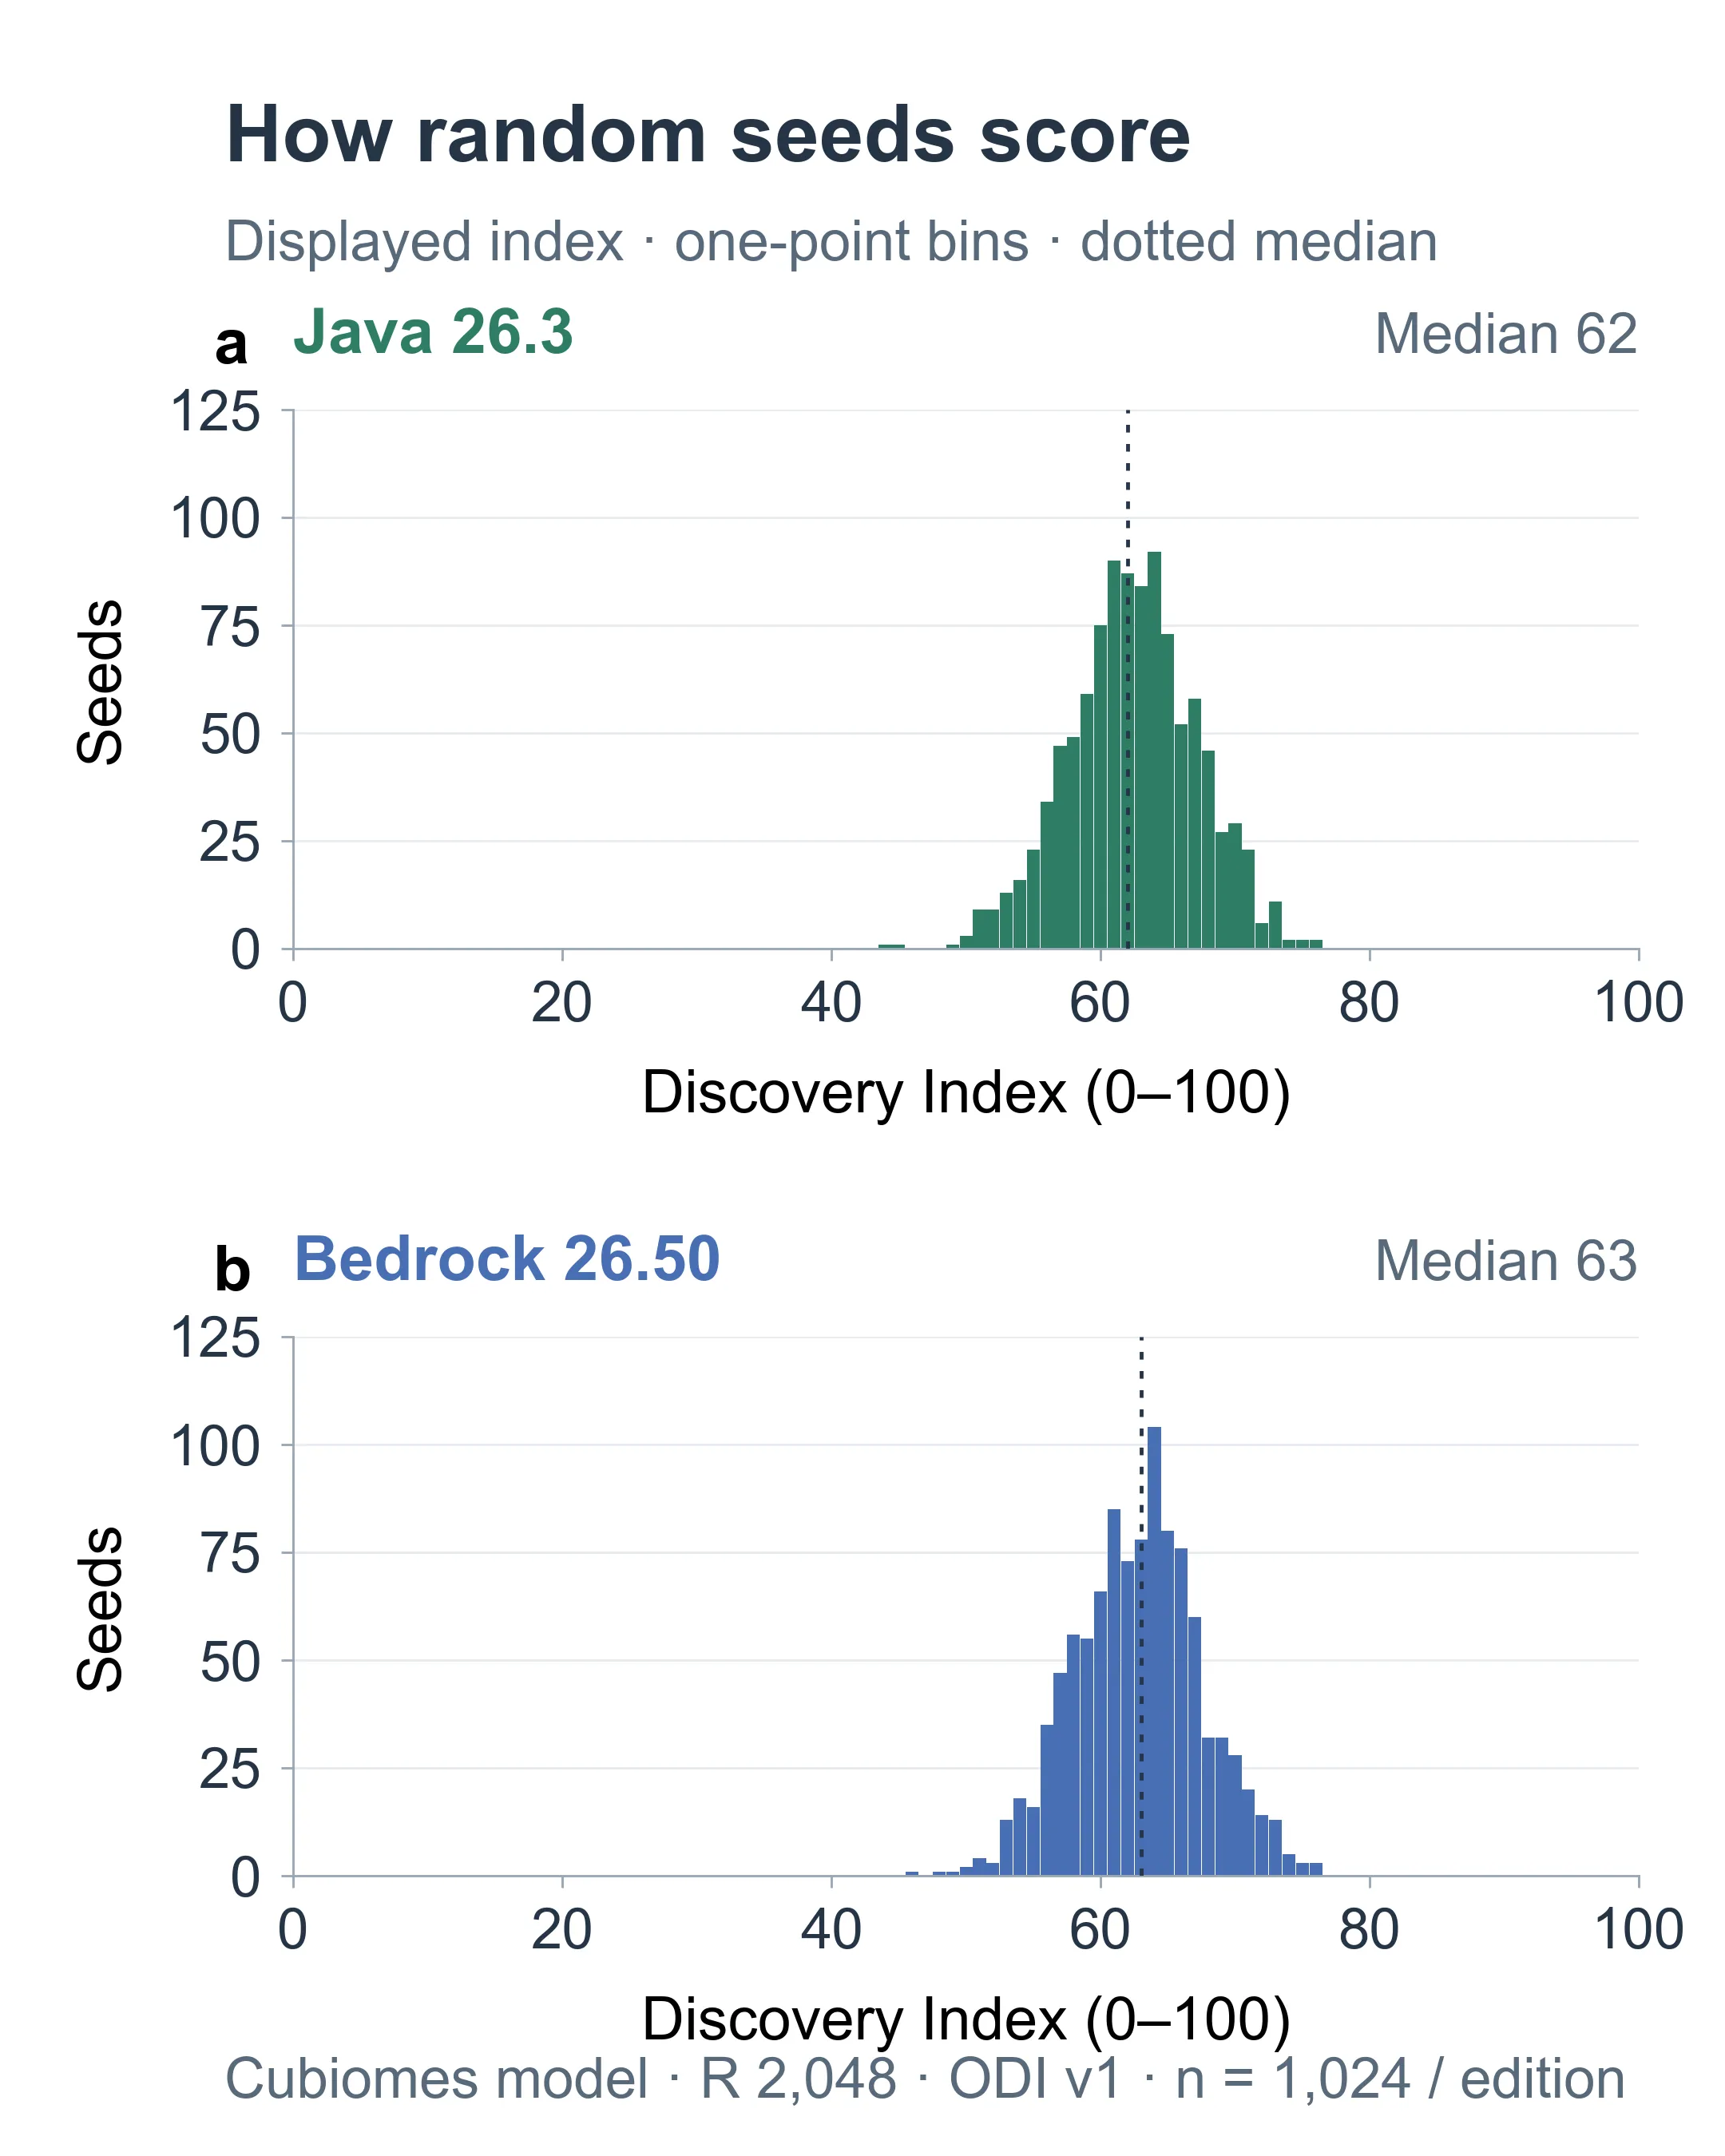
Previsões do modelo da calculadora. Cada barra estreita conta sementes em um valor exibido do índice. Os dois painéis usam a escala completa de pontuação de 0 a 100 e a mesma escala de contagem de sementes.
O eixo horizontal é o índice exibido; o eixo vertical é o número de sementes amostradas que recebem esse valor. Barras mais altas indicam pontuações mais frequentes na coorte. As pontuações de Java vão de 44 a 76 e as de Bedrock vão de 46 a 76. Suas medianas ficam perto do centro dessas distribuições observadas, bem abaixo do teto teórico de 100.
Portanto, uma pontuação de 69 fica acima da mediana de qualquer uma dessas amostras de referência correspondentes. A divisão por biomas e estruturas explica quais descobertas forneceram esses pontos.
Separe a diversidade do crédito de distância
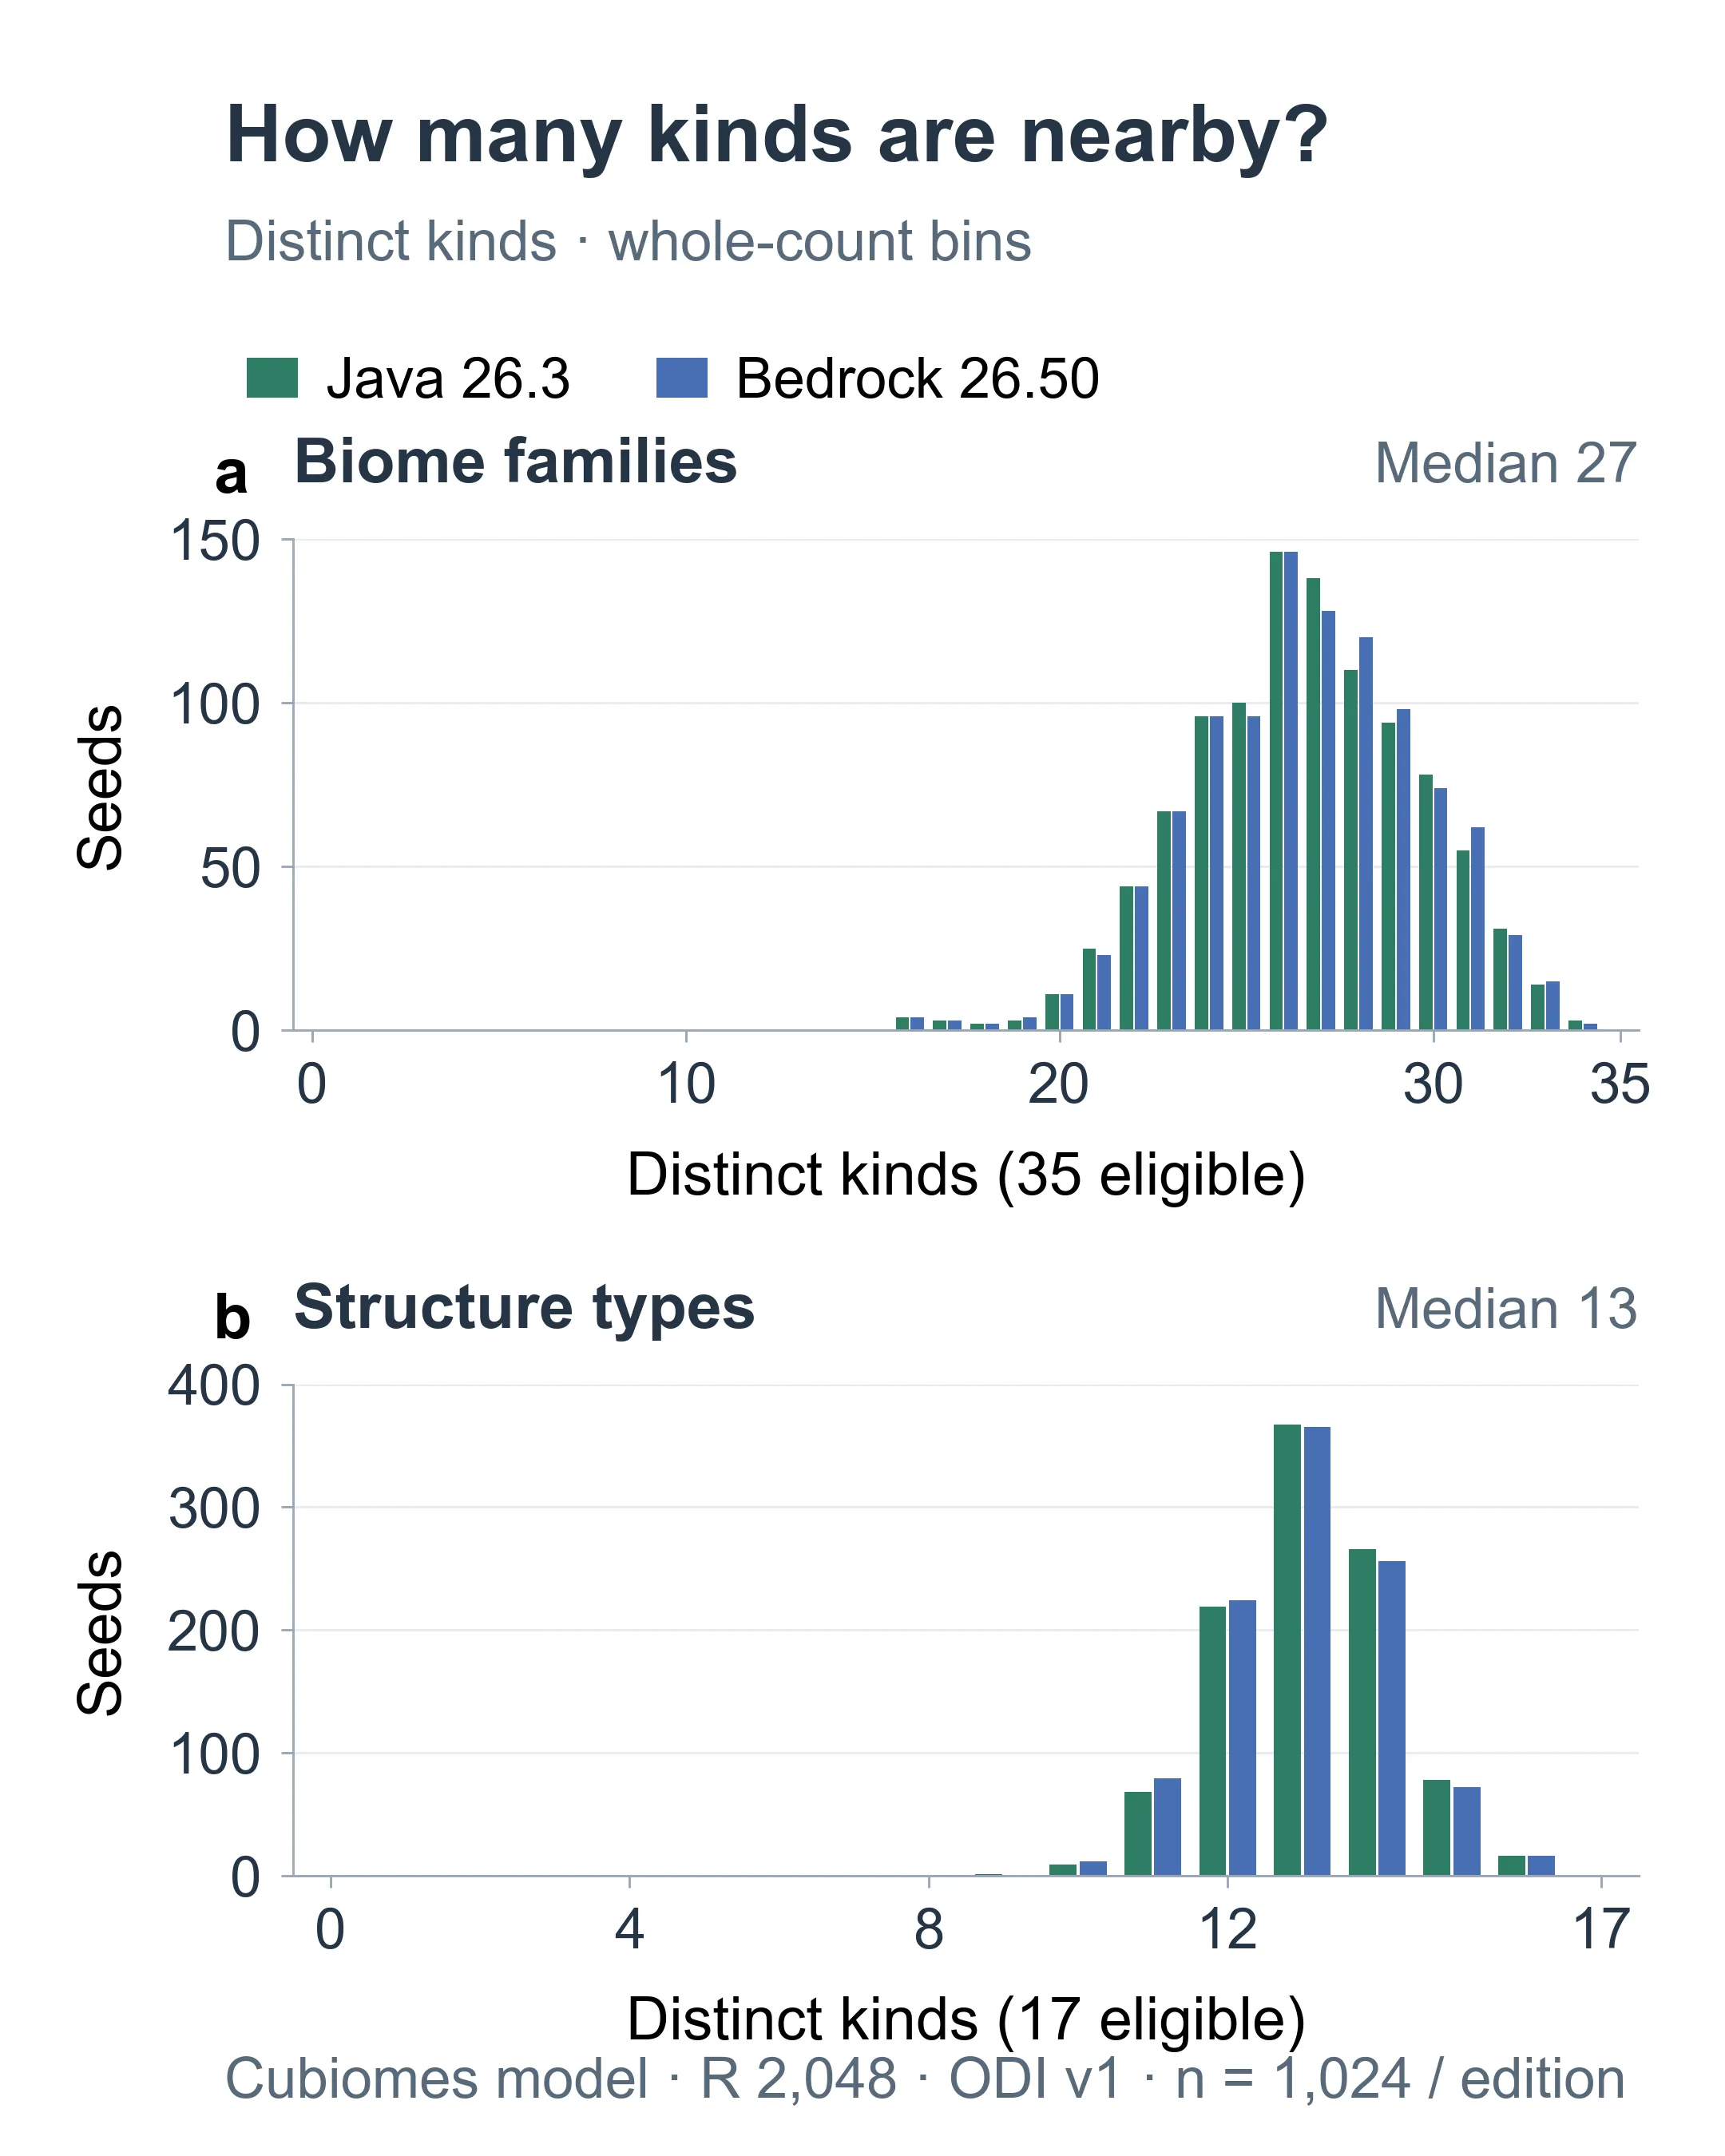
Cada barra conta sementes do modelo com um número específico de famílias ou tipos de estrutura representados. Famílias da superfície e de cavernas estão incluídas. Essas contagens não têm ponderação por distância.
O painel superior pergunta quantas famílias diferentes de biomas foram amostradas dentro do círculo. O painel inferior pergunta quantos tipos diferentes de estrutura tiveram uma previsão dentro dele. Leia separadamente as barras verdes e azuis em cada grupo de números inteiros; somá-las combinaria duas edições cujas configurações de referência precisam permanecer distintas.
As duas edições têm uma mediana de 27 famílias amostradas e 13 tipos previstos. As contagens de famílias vão de 16 a 34 em cada coorte. As contagens de tipos previstos vão de 9 a 16 em Java e de 10 a 16 em Bedrock. Nenhum mundo amostrado representou todas as 35 famílias ou todos os 17 tipos nessas configurações do modelo.
A diversidade responde quantos tipos estão representados, independentemente da distância das suas amostras ou previsões mais próximas. A pontuação final também recompensa a proximidade. Por isso, uma contagem de 27 famílias ou 13 estruturas não deve ser lida como uma pontuação de componente de 27 ou 13 em 100.
Examine a metade de biomas
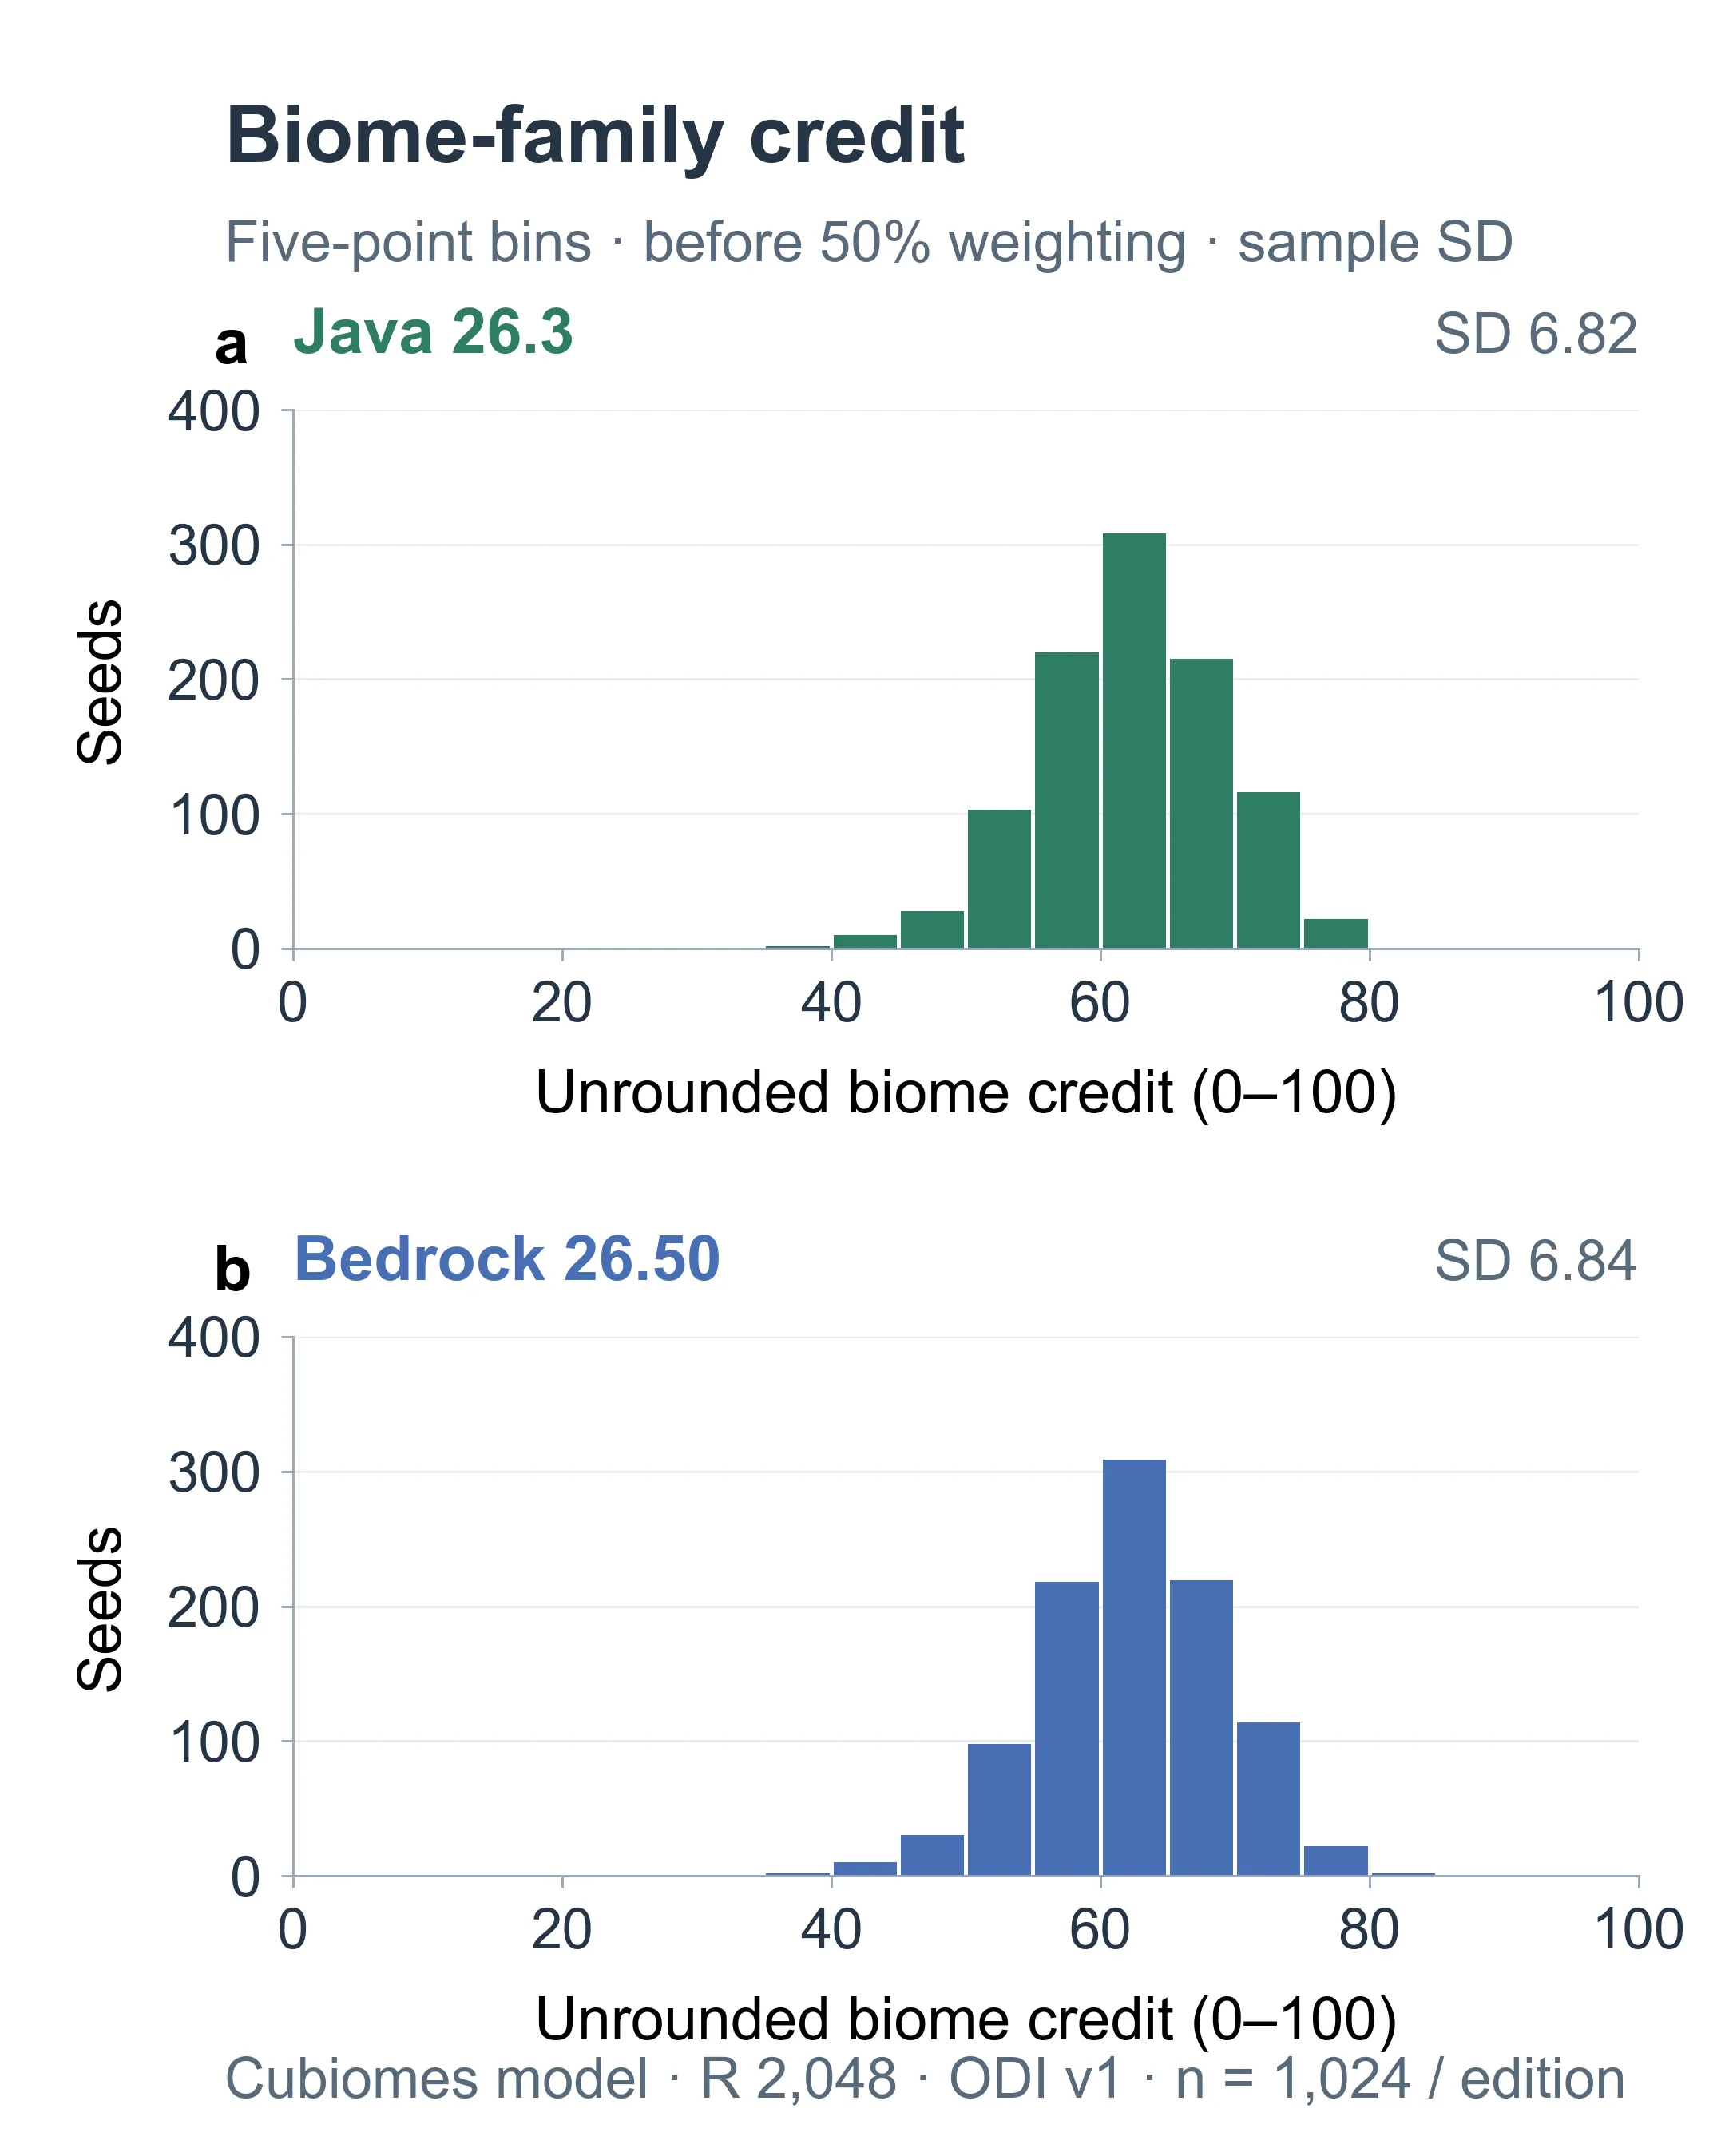
Previsões do modelo da mesma amostra pareada de sementes. Estes valores do eixo horizontal são pontuações de bioma antes da aplicação do seu meio peso no índice geral.
Cada barra abrange um intervalo de cinco pontos, diferente das barras de um inteiro do histograma da pontuação geral. Um componente de bioma de 70 contribuiria com 35 pontos no índice antes do arredondamento final. Isso significa que o crédito médio entre famílias elegíveis é 0,70; não significa 70 famílias ou que 70% do círculo foi explorado.
As distribuições de biomas variam mais amplamente entre essas amostras do que as distribuições de estruturas abaixo. Seus desvios-padrão amostrais são de cerca de 6,82 pontos em Java e 6,84 em Bedrock. O NIST descreve o desvio-padrão como uma medida de dispersão em torno da média amostral, expressa nas unidades originais. Aqui, as unidades são pontos de pontuação do componente. Ele descreve a variação entre pontuações de sementes, não uma margem de erro da média. As duas distribuições de biomas também mostram um desvio estatisticamente detectável de uma forma normal no nosso teste diagnóstico após correção para múltiplos testes.
A contagem de famílias e as distâncias produzem juntas essa dispersão. O histograma não identifica qual família falta em uma semente específica; os ícones e detalhes de coordenadas da calculadora respondem a essa pergunta.
Examine a metade de estruturas
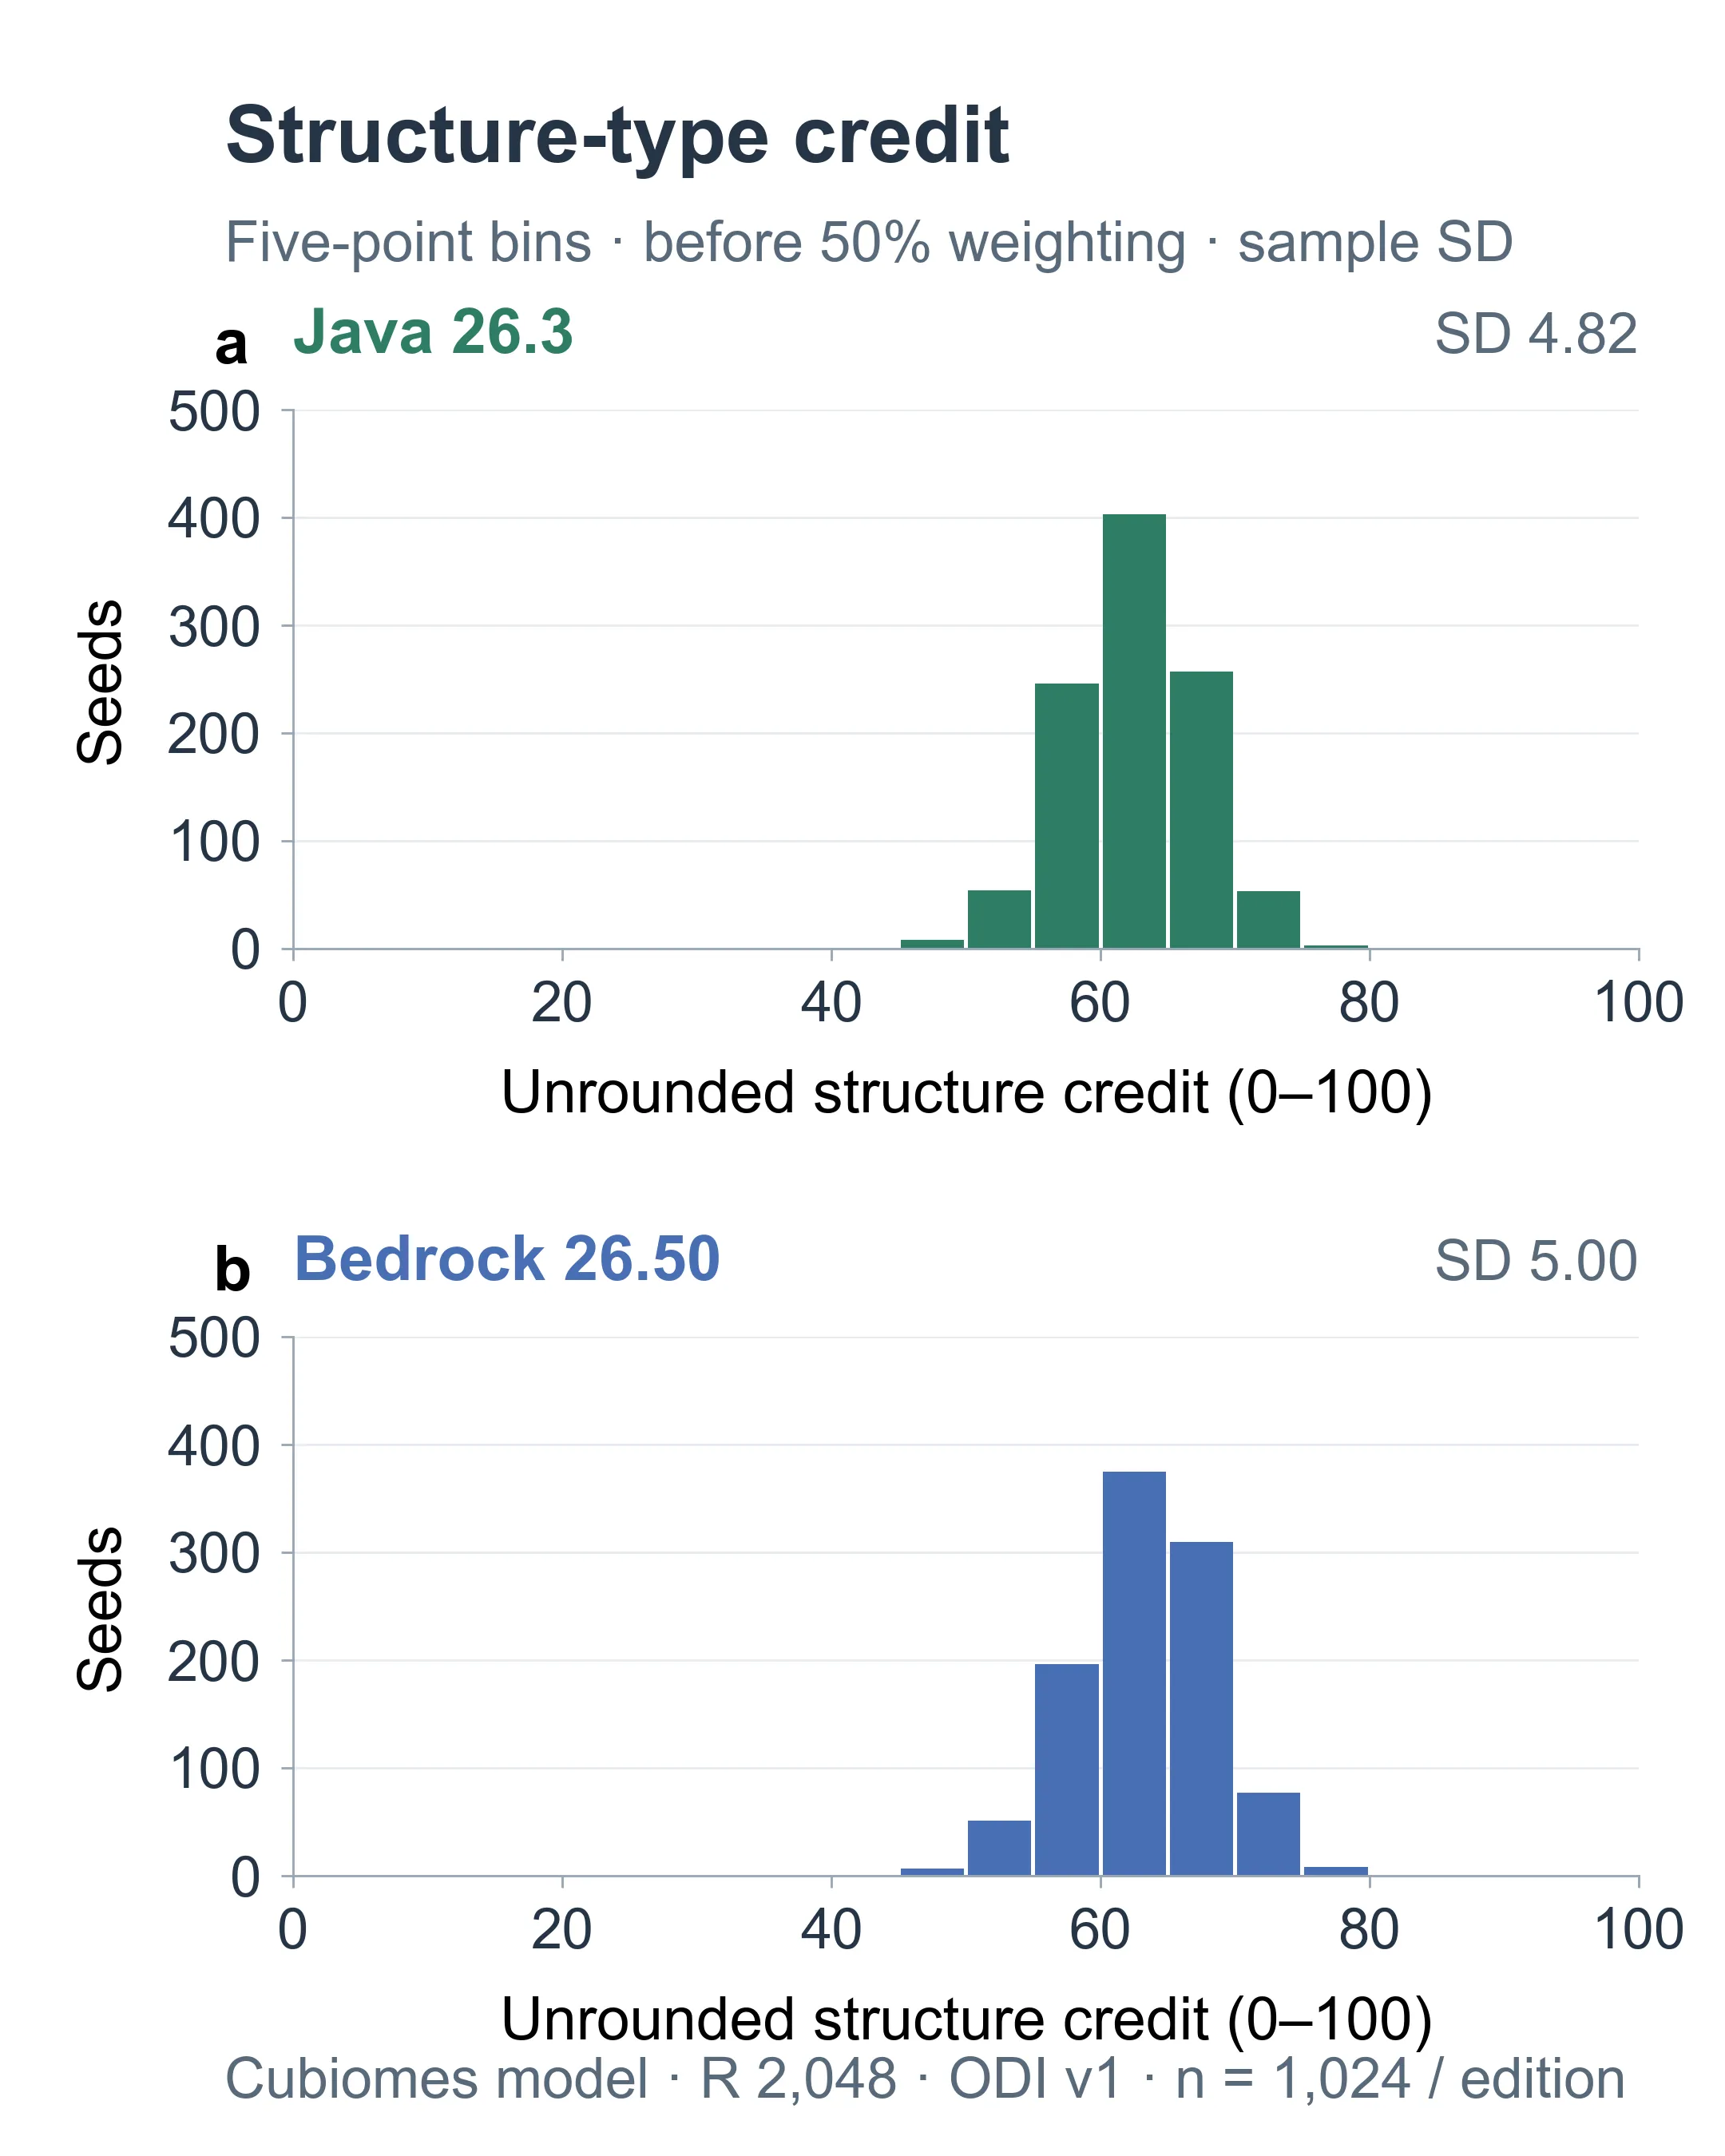
Cada tipo modelado de estrutura contribui uma vez por meio da sua previsão mais próxima. O gráfico não conta todas as estruturas de um mundo.
Os eixos e as faixas de cinco pontos têm os mesmos significados do gráfico do componente de biomas, portanto suas dispersões horizontais são comparáveis. Cada gráfico tem suas próprias marcas verticais de contagem de sementes. Os desvios-padrão amostrais são de cerca de 4,82 pontos para Java e 5,00 para Bedrock, menores que a dispersão do componente de biomas. Nosso teste de normalidade corrigido não rejeitou nenhuma das duas distribuições do componente de estruturas.
A metade de estruturas combina contagens de tipos representados com proximidade horizontal. Vilas adicionais do mesmo tipo não acrescentam pontos de variedade, e uma fortaleza prevista próxima não recebe compensação adicional pelo esforço de alcançá-la no subsolo. Essas são propriedades da regra de avaliação, não conclusões sobre a dificuldade desses mundos.
O índice geral calcula a média das duas pontuações diferentes de componentes antes do arredondamento. Sua distribuição pode diferir de qualquer uma das metades. Nessas coortes, o resultado agregado tem uma forma aproximadamente de sino, embora o componente de biomas se afaste da normalidade. Avaliamos diretamente esse resultado agregado; combinar duas pontuações não estabelece uma regra geral para toda versão ou raio.
Confira as caudas com um gráfico Q-Q normal
Um histograma ajuda a ver onde a maioria das pontuações fica, mas suas faixas podem esconder diferenças menores de forma. O gráfico Q-Q normal compara as pontuações ordenadas e não arredondadas com as pontuações esperadas de uma distribuição normal, usando a média observada e o desvio-padrão amostral de cada coorte. A explicação do NIST sobre gráficos de probabilidade normal descreve como desvios de uma linha reta de referência revelam diferenças em relação a uma forma normal.
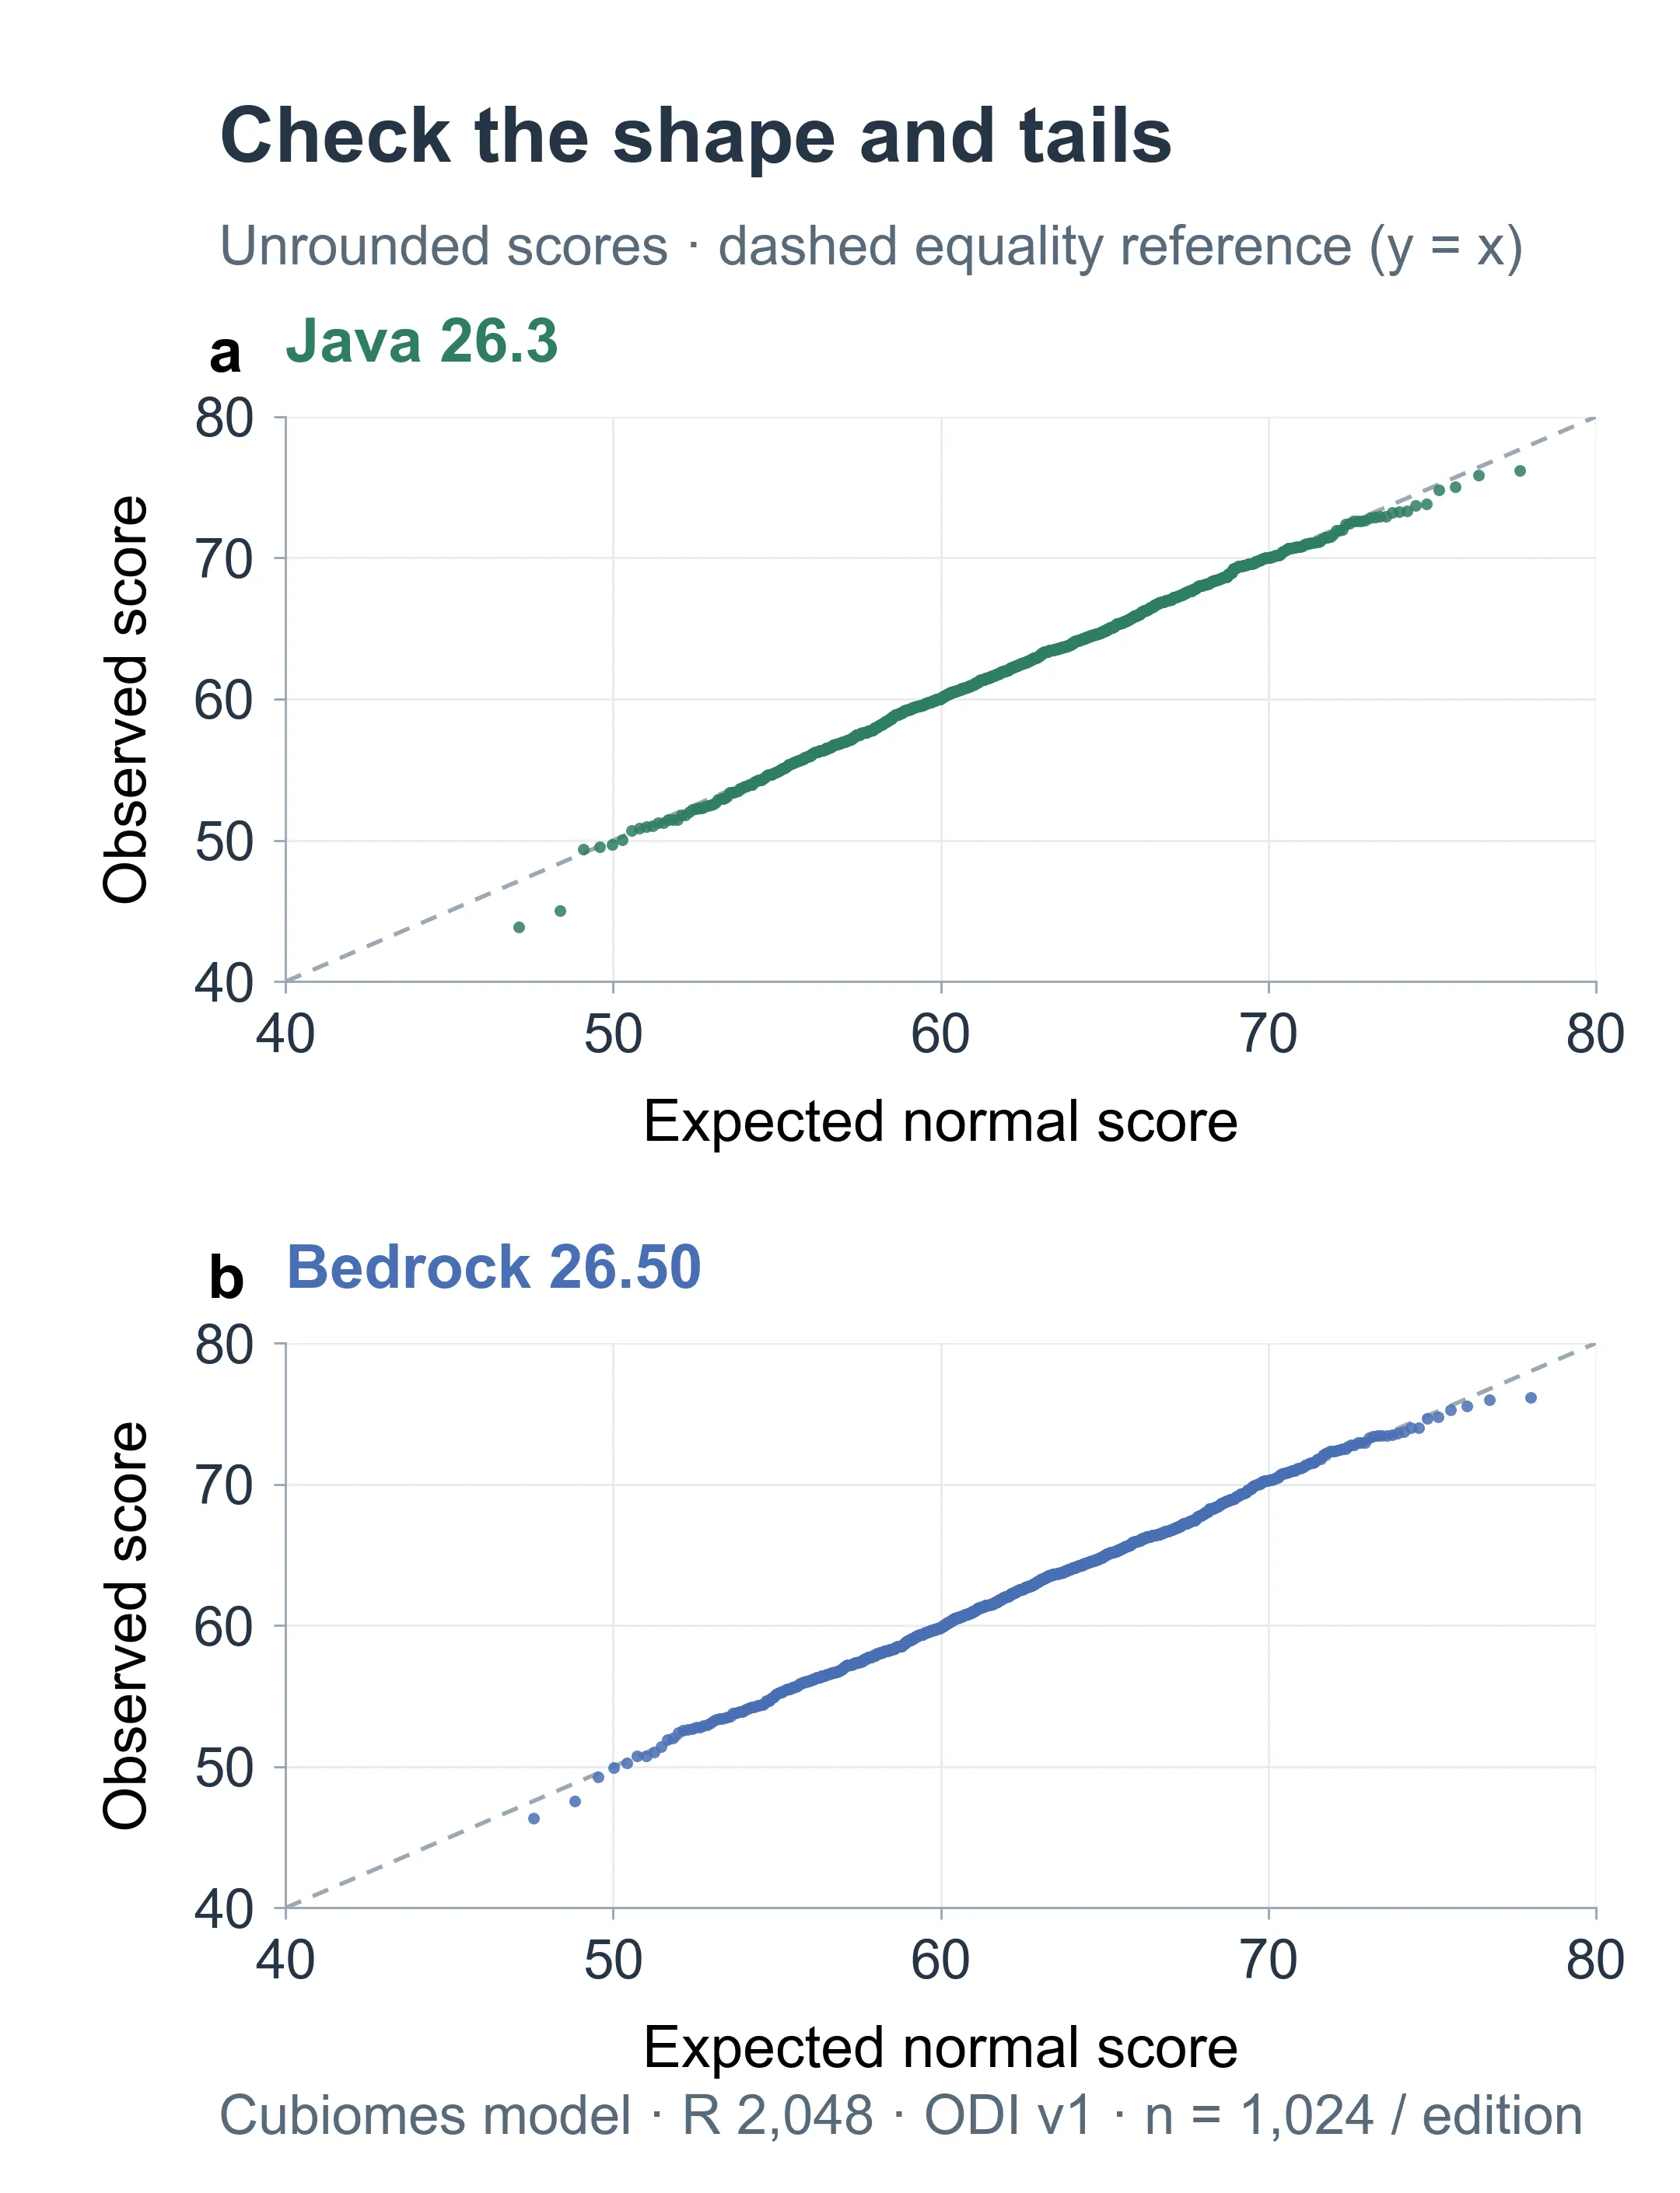
Cada painel contém todas as 1.024 pontuações gerais não arredondadas. As pontuações normais esperadas usam a média e o desvio-padrão da amostra; a diagonal cinza marca valores esperados e observados iguais. Ela não é uma faixa de confiança.
Os dois eixos usam pontos do índice. Um ponto na diagonal tem a pontuação observada esperada naquela posição da comparação normal. Pontos acima dela têm pontuações observadas maiores; pontos abaixo têm menores. Os pontos mais à esquerda e à direita representam as caudas baixa e alta da amostra.
A maioria dos pontos acompanha a diagonal de perto, com desvios nos extremos. Esses pontos finais importam quando a pergunta envolve pontuações excepcionalmente baixas ou altas. Um bom ajuste no centro não estabelece uma estimativa confiável da curva normal para uma pontuação muito rara fora do intervalo observado.
O que a verificação de normalidade estabelece
Aplicamos o teste de Shapiro-Wilk documentado pelo SciPy à pontuação geral não arredondada e aos dois componentes não arredondados de cada edição. Usar valores não arredondados evita tratar os empates entre inteiros da exibição como medições contínuas. Usamos um limiar de 0,05 e a correção de Holm nesses seis testes.
| Distribuição testada | Valor p ajustado de Java 26.3 | Valor p ajustado de Bedrock 26.50 | Resultado a 0,05 |
|---|---|---|---|
| Índice geral | 0,667 | 0,667 | Desvio não detectado |
| Componente de biomas | 0,0059 | 0,0059 | Desvio detectado |
| Componente de estruturas | 0,231 | 0,472 | Desvio não detectado |
Os valores p não ajustados dos testes gerais foram 0,334 para Java e 0,660 para Bedrock. A não rejeição é consistente com as formas aproximadamente de sino nessas amostras específicas. Ela não prova normalidade, não certifica os modelos de geração nem informa a probabilidade de um mundo ser divertido.
As pontuações continuam limitadas de 0 a 100. Usamos as frequências realmente observadas para comparar sementes, sem converter uma pontuação por uma curva normal ajustada. Os testes e gráficos descrevem essas duas coortes; outras edições, versões, raios ou futuras revisões da regra de avaliação precisam da sua própria avaliação.
O resumo estatístico completo e todos os resultados amostrados do modelo conservam as medições usadas nessas figuras. As cinco figuras de distribuição usam a mesma amostra pareada; a figura de crédito de distância ilustra a fórmula.
Contextualize uma pontuação individual
Para a semente de exemplo semente 12345 de Java 26.3, a calculadora prevê uma pontuação de 69, com 30 de 35 famílias amostradas e 14 de 17 tipos de estrutura previstos. Essas contagens de cobertura equivalem a cerca de 84 pontos possíveis antes dos descontos por distância: 50 × 30 / 35 + 50 × 14 / 17 ≈ 84. As distâncias mais próximas reduzem esse valor aos 69 exibidos. Na amostra de referência correspondente, 922 pontuações foram menores, 27 foram iguais e 75 foram maiores.
Os empates importam. Cada 69 exibido representa um resultado arredondado, e combinações diferentes de crédito de biomas e estruturas podem produzi-lo. As contagens exatas de pontuações exibidas menores, iguais e maiores preservam esses empates. Elas também explicam a comparação mais diretamente do que atribuir silenciosamente o mesmo percentil normal estimado a cada semente empatada.
A calculadora mostra o histograma observado, a mediana amostral, o intervalo P10 a P90 e as contagens abaixo, iguais e acima da sua pontuação quando edição, versão, raio, regra de avaliação e modelo de geração correspondem exatamente. Outras configurações ainda recebem sua divisão de descobertas; no momento, não têm uma amostra de referência correspondente.
A frequência de ocorrência também precisa do seu próprio denominador. Na coorte de Java 26.3 com esse raio, o modelo amostrou uma família de campos de cogumelos em 294 de 1.024 sementes (28,7%) e previu uma mansão da floresta em 158 (15,4%). Essas são ocorrências em algum lugar dentro do círculo do surgimento estimado, não a probabilidade de surgir nesse bioma ou uma medida da sua área global.
Um histograma da pontuação geral responde com que frequência a calculadora produziu totais específicos nesta amostra. Um critério ponderado por raridade faria outra pergunta sobre a frequência de ocorrência de famílias ou tipos de estrutura específicos. A revisão 1 mantém pesos iguais dentro de cada categoria; essas medições não foram transformadas em bônus de raridade. Uma mudança assim exigiria linhas de base de ocorrência compatíveis com edição, versão de geração, raio e regras de amostragem, além de uma nova revisão da regra de avaliação submetida à revisão.
Esta é uma amostra de referência de previsões do modelo, não um percentil populacional de raridade, uma amostra de mundos jogados ou uma medição de quanto os jogadores viajam. Uma pontuação de 80 não significa que uma semente seja mais variada do que 80% de todas as sementes. Use a calculadora para comparar as descobertas modeladas na área que pretende explorar e depois examine no mapa de sementes os locais que importam para você.