seedlookout
Un índice de experiencia para semillas de Minecraft puede ayudar a responder una pregunta práctica: ¿cuántos terrenos distintos y tipos de destinos ofrece esta semilla en el área que quiero explorar?
Nuestra calculadora de experiencia de semillas lo llama Índice de descubrimiento de la superficie. Combina familias de biomas muestreadas y tipos de estructuras previstos en una puntuación de 0 a 100, dando más valor a los descubrimientos cercanos al punto de aparición estimado. Tú eliges la edición, la versión de generación y el radio. La puntuación describe la variedad modelada; tus preferencias siguen determinando si quieres jugar allí.
Examinamos 1,024 semillas pseudoaleatorias en cada uno de dos modelos de generación. Con un radio de 2,048 bloques, la mediana del índice mostrado fue 62 en Java 26.3 y 63 en Bedrock 26.50. El techo matemático de 100 de la rúbrica es una magnitud distinta del centro de esa muestra. Las gráficas siguientes muestran cómo contextualizar una puntuación sin convertirla en una valoración de diversión.
Elige un radio de exploración
La calculadora ofrece radios de 512, 1,024, 2,048 y 4,096 bloques. Cada uno define un círculo medido horizontalmente desde el punto de aparición estimado del mundo. Un radio de 2,048 bloques alcanza esa distancia en todas las direcciones; no significa que un recorrido de 2,048 bloques visite todo lo que contiene.
Usamos 2,048 bloques como valor predeterminado porque la herramienta necesita un área inicial. No hemos calibrado esa elección frente a una medida representativa de cuánto exploran los jugadores de Minecraft. La guía de exploración de Mojang describe tanto viajes cortos como aventuras más largas, sin ofrecer un radio medio.
Elige el radio que se ajuste al mundo que buscas. Un círculo pequeño mide la variedad cercana. Uno mayor incluye más destinos posibles y da más valor por distancia al mismo descubrimiento cercano. Compara dos semillas con el mismo radio para mantener la pregunta constante.
El radio cambia, por tanto, dos cosas: el área examinada y el valor de una distancia concreta. Una predicción a 1,024 bloques del punto de aparición recibe 0.75 de valor con un radio de 2,048, pero 0.875 con uno de 4,096. La puntuación puede subir con el radio mayor incluso antes de encontrar otro tipo. Ese aumento responde a una pregunta de exploración más amplia; no establece que la propia semilla haya mejorado.
Contar experiencias distintas
El recuento bruto de biomas puede dar varios puntos a terrenos muy parecidos. La calculadora mantiene visibles esos identificadores, pero agrupa las variantes relacionadas para puntuar. Las llanuras y las llanuras de girasoles comparten una familia. El océano y el océano profundo comparten otra. El bosque floral tiene su propia familia; las familias de cuevas también cuentan por separado.
Estas familias son definiciones editoriales nuestras. La herramienta no puntúa la obtención de avances. Todas las familias admitidas tienen el mismo peso en la parte de biomas de la puntuación. Una familia solo se admite cuando el catálogo de la versión del modelo de generación seleccionado contiene alguno de sus miembros.
Para el terreno superficial, la calculadora toma muestras en una cuadrícula de 32 bloques a la altura aproximada de la superficie. Si esa altura devuelve un bioma de cueva, excluye la muestra del recuento superficial. Las zonas estrechas pueden quedar entre los puntos de la cuadrícula, de modo que el recuento bruto indica cuántos identificadores de bioma se muestrearon, sin ser un inventario exhaustivo.
El muestreo de cuevas usa una cuadrícula de 64 bloques en Y -48, -32, -16, 0, 16, 32 and 48 y conserva los puntos situados al menos ocho bloques bajo la superficie aproximada. Las muestras identifican regiones de biomas de cueva. Una muestra puede estar dentro de terreno sólido, por lo que no demuestra que haya una cueva accesible en esas coordenadas. En esta primera rúbrica, el desplazamiento vertical y el esfuerzo de excavar no reciben penalización por distancia.
Las estructuras contribuyen por tipo: las aldeas cuentan una vez, con independencia de cuántas predicciones de aldeas haya en el círculo. Una aldea y un naufragio añaden dos tipos distintos. La calculadora busca la predicción más cercana de cada tipo admitido, incluidos destinos subterráneos cuando los criterios de su versión los permiten.
Las minas abandonadas se excluyen de todos los perfiles porque el buscador disponible de la más cercana no puede establecer la cobertura en todos los radios ofrecidos. La puntuación mide, por tanto, los criterios que enumera y no todos los destinos posibles de la superficie.
Dar más valor a los descubrimientos cercanos
Para cada familia o tipo de estructura encontrado, la distancia horizontal determina su valor:
credit = 1 − 0.5 × distance / radius
Un descubrimiento en el punto de aparición recibe 1. A la mitad del radio recibe 0.75 y en el límite recibe 0.5. Un criterio no encontrado recibe 0. La media de cada categoría incluye en el denominador todos los criterios admitidos, también los no encontrados.
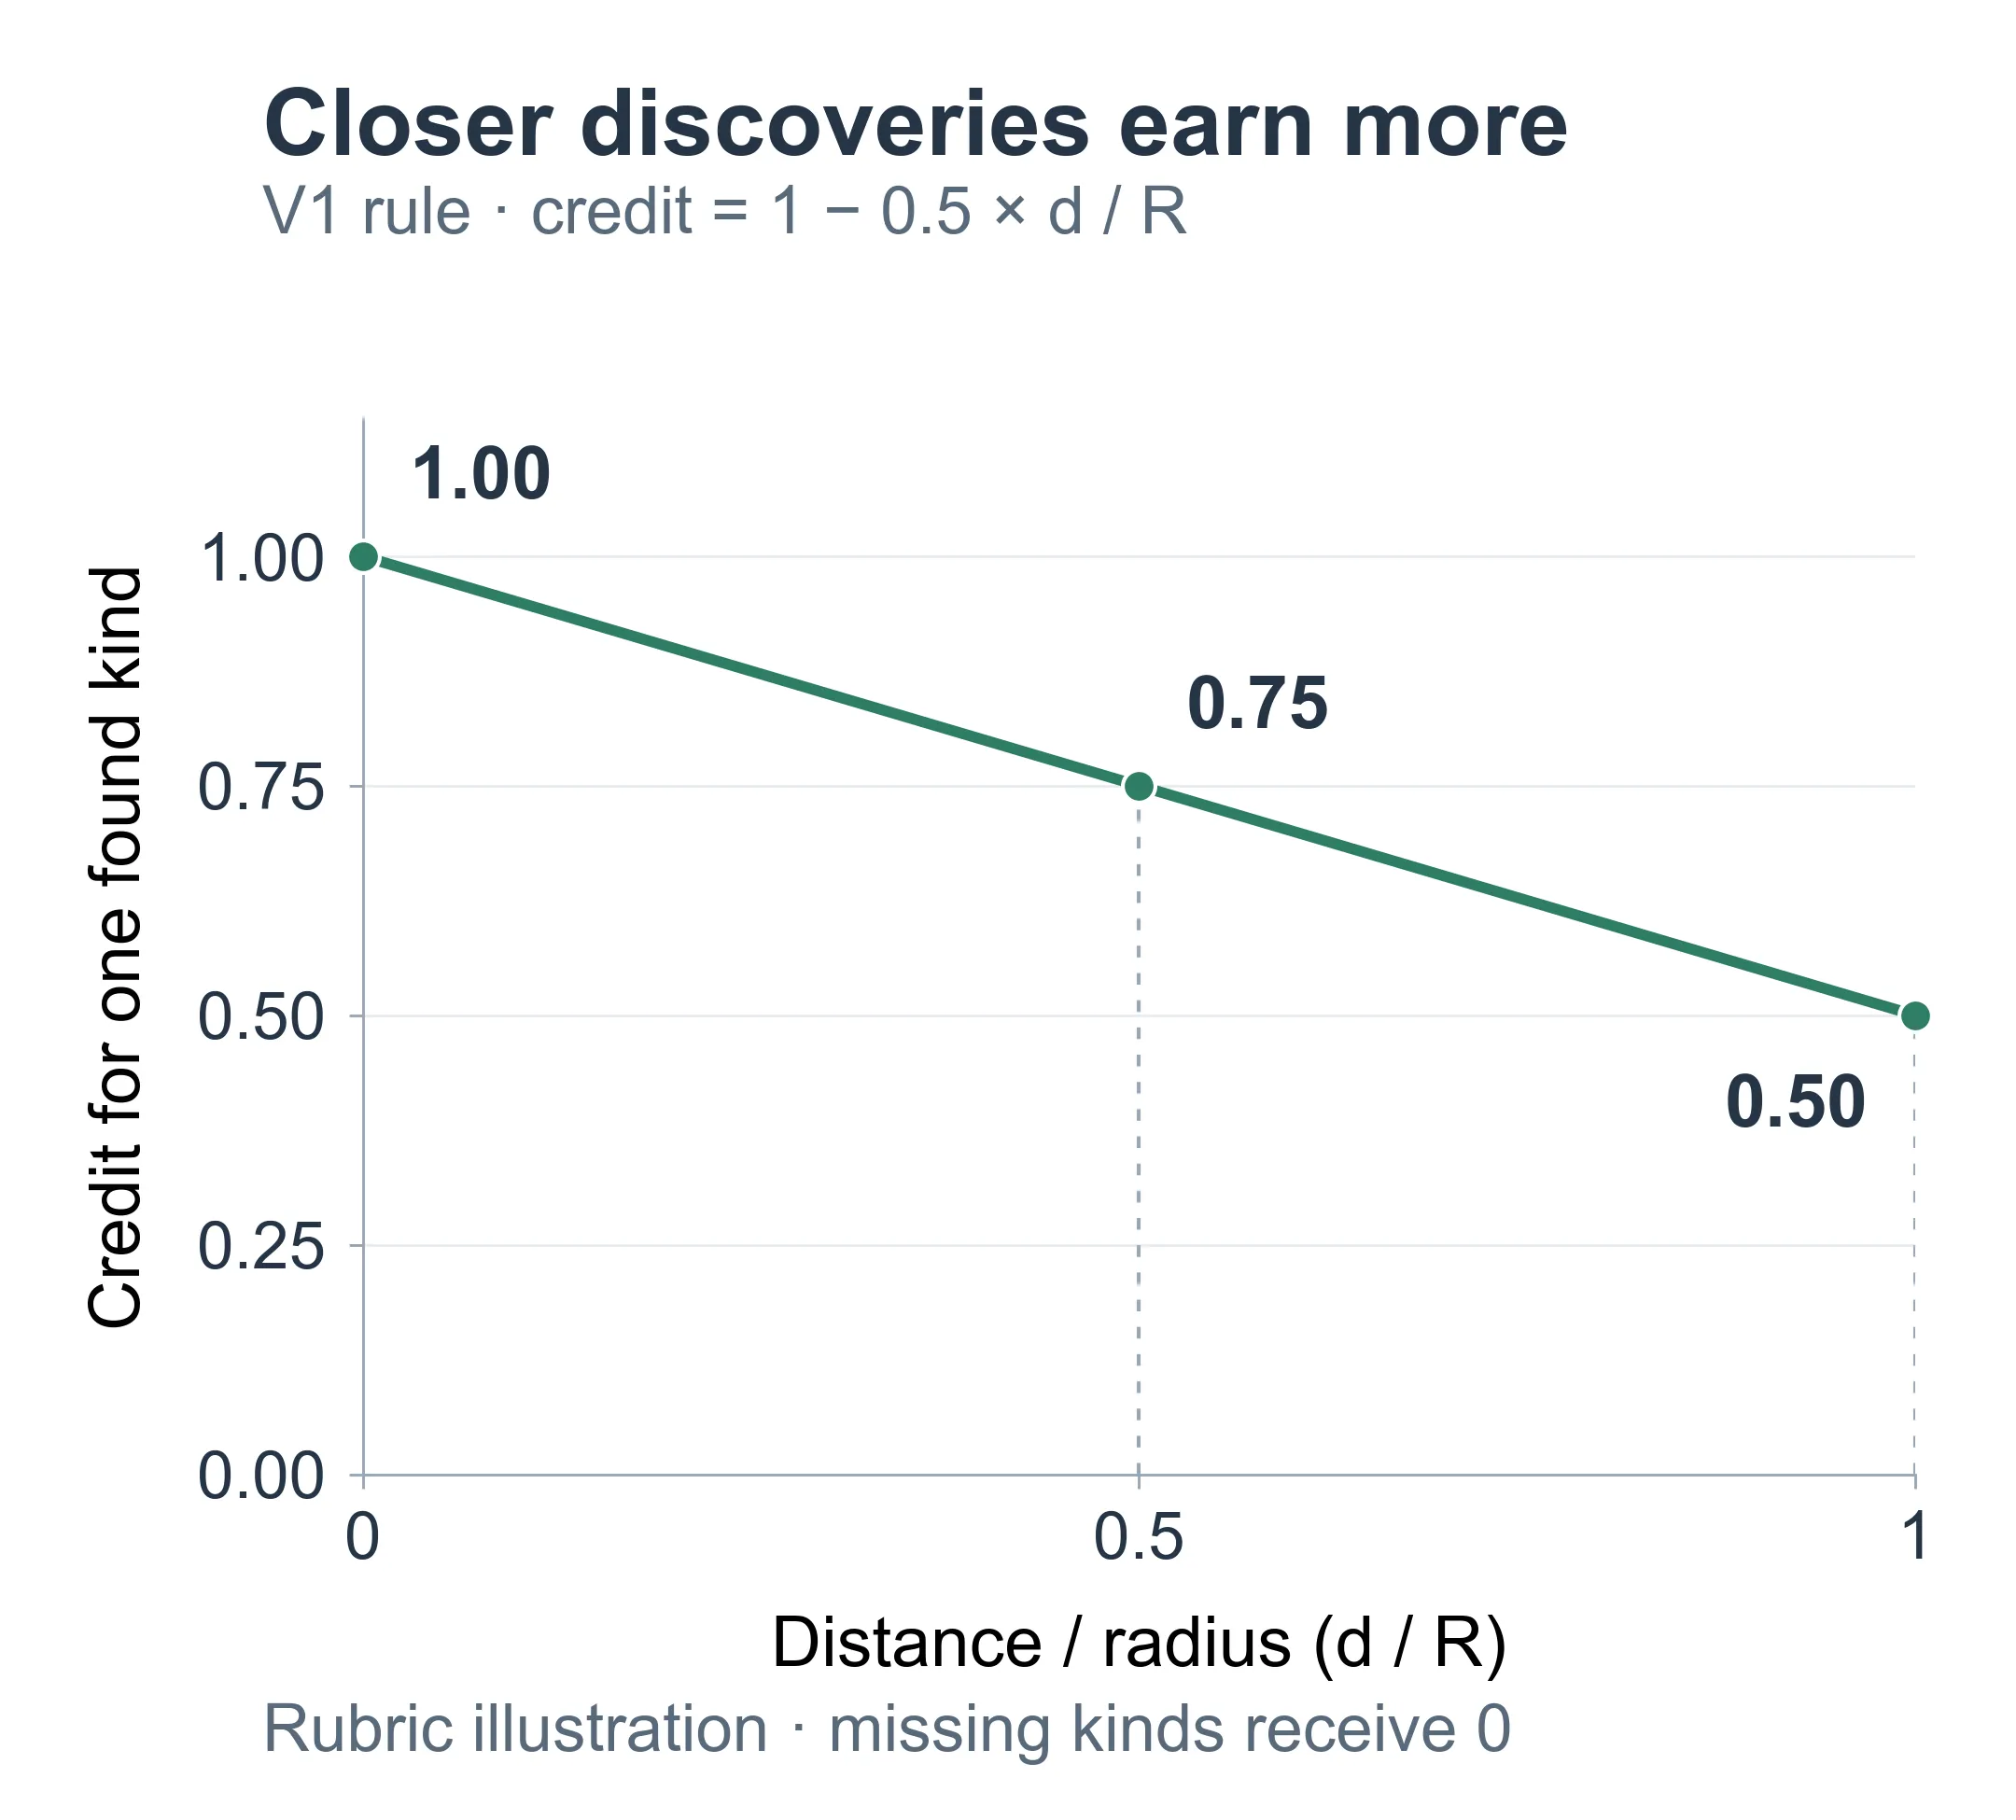
Ilustración de la rúbrica, sin muestras de mundos. El eje horizontal divide la distancia entre el radio elegido; el vertical muestra el valor de un criterio encontrado.
El cálculo final da el mismo peso a las dos categorías:
index = round(100 × (0.5 × biome average + 0.5 × structure average))
En los perfiles de Java 26.3 y Bedrock 26.50, los biomas pueden aportar hasta 50 puntos entre 35 familias, y las estructuras hasta 50 entre 17 tipos. Una familia puede aportar unos 50 / 35 = 1.43 puntos al índice antes del redondeo; un tipo de estructura, unos 50 / 17 = 2.94. Ambas aportaciones disminuyen con la distancia. Combinar los 52 criterios en una sola lista con el mismo peso daría más influencia a los biomas; las dos mitades mantienen iguales sus pesos totales.
Este ejemplo hipotético muestra las operaciones; no es el resultado de una semilla concreta:
| Categoría | Valores de sus criterios admitidos | Media |
|---|---|---|
| Cuatro familias de biomas | 1, 0.75, 0.5, 0 | 0.5625 |
| Tres tipos de estructuras | 0.75, 0, 0 | 0.25 |
El índice es round(100 × (0.5 × 0.5625 + 0.5 × 0.25)) = 41.
La agrupación, los pesos iguales de las categorías y el valor de la mitad en el límite son decisiones de la revisión 1. No las hemos ajustado a una encuesta sobre lo que disfrutan los jugadores. Una familia o tipo de estructura no recibe automáticamente más valor por aparecer con menor frecuencia en la muestra de referencia.
La herramienta también distingue una búsqueda completada sin predicción de una búsqueda incompleta. Cuando la cobertura limitada de estructuras deja un tipo como desconocido, no se muestra la puntuación global. Una cobertura desconocida no cuenta ni como descubrimiento conseguido ni como tipo ausente.
Compartir el código de cálculo y revisar los criterios por versión
La compatibilidad con versiones de Minecraft requiere dos decisiones separadas: qué modelo de generación usar y qué criterios de cálculo aplicar.
La calculadora comparte un único núcleo de muestreo y puntuación. Java y Bedrock usan los modelos de generación de cada edición ya existentes en el sitio. Un registro explícito conecta cada versión de generación compatible con sus criterios de cálculo. Las versiones pueden compartir una definición de criterios cuando sus reglas coinciden; no necesitan copias separadas del motor de la calculadora.
Los criterios controlan los tipos de estructuras admitidos, el intervalo de muestreo, las profundidades de cueva, los pesos de categoría y el valor por distancia. El catálogo de biomas procede de la versión del modelo seleccionado y se contrasta con las definiciones de familias revisadas. Un nombre de bioma desconocido o una versión incompatible detiene el cálculo hasta que se revisen sus criterios.
Por ejemplo, el perfil actual de Java 1.18.2 tiene 29 familias de biomas admitidas y 13 tipos de estructuras. Java 26.3 tiene 35 familias y 17 tipos. Son denominadores de la calculadora, no recuentos de una semilla individual. Al perfil antiguo nunca se le restan puntos por categorías ajenas al modelo y los criterios de su versión.
Cada resultado identifica su edición, versión de generación y revisión del cálculo. Si cambian las agrupaciones o los pesos, la rúbrica necesita una revisión nueva. La muestra de referencia correspondiente también debe evaluarse con esas reglas. Esto facilita mantener el cálculo y conserva el significado de un resultado guardado.
Interpretar el resultado como un conjunto de predicciones
El resultado presenta una puntuación grande, barras de valor por distancia e iconos de cada familia de biomas y tipo de estructura admitidos. Los iconos de biomas atenuados significan “no muestreado”; los de estructuras, “sin predicción encontrada”. La cobertura desconocida tiene su propio estado, y los tipos excluidos o no admitidos en la versión quedan fuera de las listas puntuadas.
Las colecciones de iconos muestran qué clases estaban representadas. Las barras de aportación explican cuánto de su valor posible queda después de descontar la distancia. Dos semillas pueden tener los mismos recuentos de familias y tipos, pero distintas puntuaciones si sus descubrimientos más cercanos están a diferentes distancias. Al compararlas, conserva los recuentos y las aportaciones de ambas categorías junto al total.
El resultado conserva los recuentos de biomas superficiales y de cueva muestreados, ambos denominadores y las coordenadas más cercanas. Sus enlaces al mapa de semillas permiten inspeccionar esas posiciones. Una coordenada de bioma es el punto muestreado más cercano, no un límite exacto del bioma. La aparición y la altura de la superficie son estimaciones.
Las predicciones de estructuras usan las comprobaciones de colocación y biomas disponibles; la generación posterior aún puede impedir una estructura. Bedrock usa un modelo de compatibilidad cuya precisión no se ha comprobado independientemente dentro del juego. La página Acerca de explica las etiquetas de pruebas del sitio.
El perfil cubre la generación predeterminada. Quedan fuera los paquetes de datos personalizados, Biomas grandes, los mundos superplanos y los chunks existentes generados antes de actualizar un mundo. Usa la versión que generó el área que evalúas.
Un índice alto no garantiza un paisaje atractivo, una supervivencia fácil ni botín valioso. Tampoco indica qué fracción del círculo visitarás realmente. Un mundo de islas con poca variedad puede gustarte más que una semilla con muchas categorías cercanas.
Calcular una semilla que te interese
Abre la calculadora, introduce una semilla y elige su edición y versión de generación. Java también admite texto de semilla y lo convierte en una semilla numérica; Bedrock requiere una semilla numérica. Elige un radio y calcula.
Inspecciona el desglose por categorías antes de comparar las cifras finales. Si un bioma o estructura te importa especialmente, usa el buscador de semillas para buscar esa condición y después evalúa la variedad circundante con la calculadora. La URL de la calculadora conserva tus entradas para que puedas volver a la misma consulta.
Qué nos dicen las semillas aleatorias
Seleccionamos 1,024 semillas numéricas pseudoaleatorias de 64 bits con signo y evaluamos cada una en Java 26.3 y Bedrock 26.50. Ambas cohortes usan la generación predeterminada de la superficie, un radio de 2,048 bloques y la revisión 1 del cálculo, con 35 familias de biomas y 17 tipos de estructuras admitidos. Los mismos números de semilla forman un estudio emparejado; la distribución de cada edición se resume por separado. Se completaron las 2,048 evaluaciones del modelo, sin omitir ni reemplazar ningún resultado fallido o incompleto.
Seleccionamos semillas numéricas sin elegirlas del catálogo publicado. Este estudio describe la calculadora con esos ajustes; no mide mundos que los jugadores decidieron conservar.
Interpretar la distribución global
La tabla describe el índice mostrado y redondeado. P10 a P90 indica los valores de los percentiles 10 y 90 de la muestra. Los empates de enteros hacen que la proporción entre esos valores pueda superar el 80%; el intervalo no es un intervalo de confianza.
| Modelo de generación | Índice medio | Mediana del índice | P10 a P90 | Mediana de familias muestreadas | Mediana de tipos previstos |
|---|---|---|---|---|---|
| Java 26.3 | 62.4 | 62 | 56 a 68 | 27 de 35 | 13 de 17 |
| Bedrock 26.50 | 62.8 | 63 | 57 a 69 | 27 de 35 | 13 de 17 |
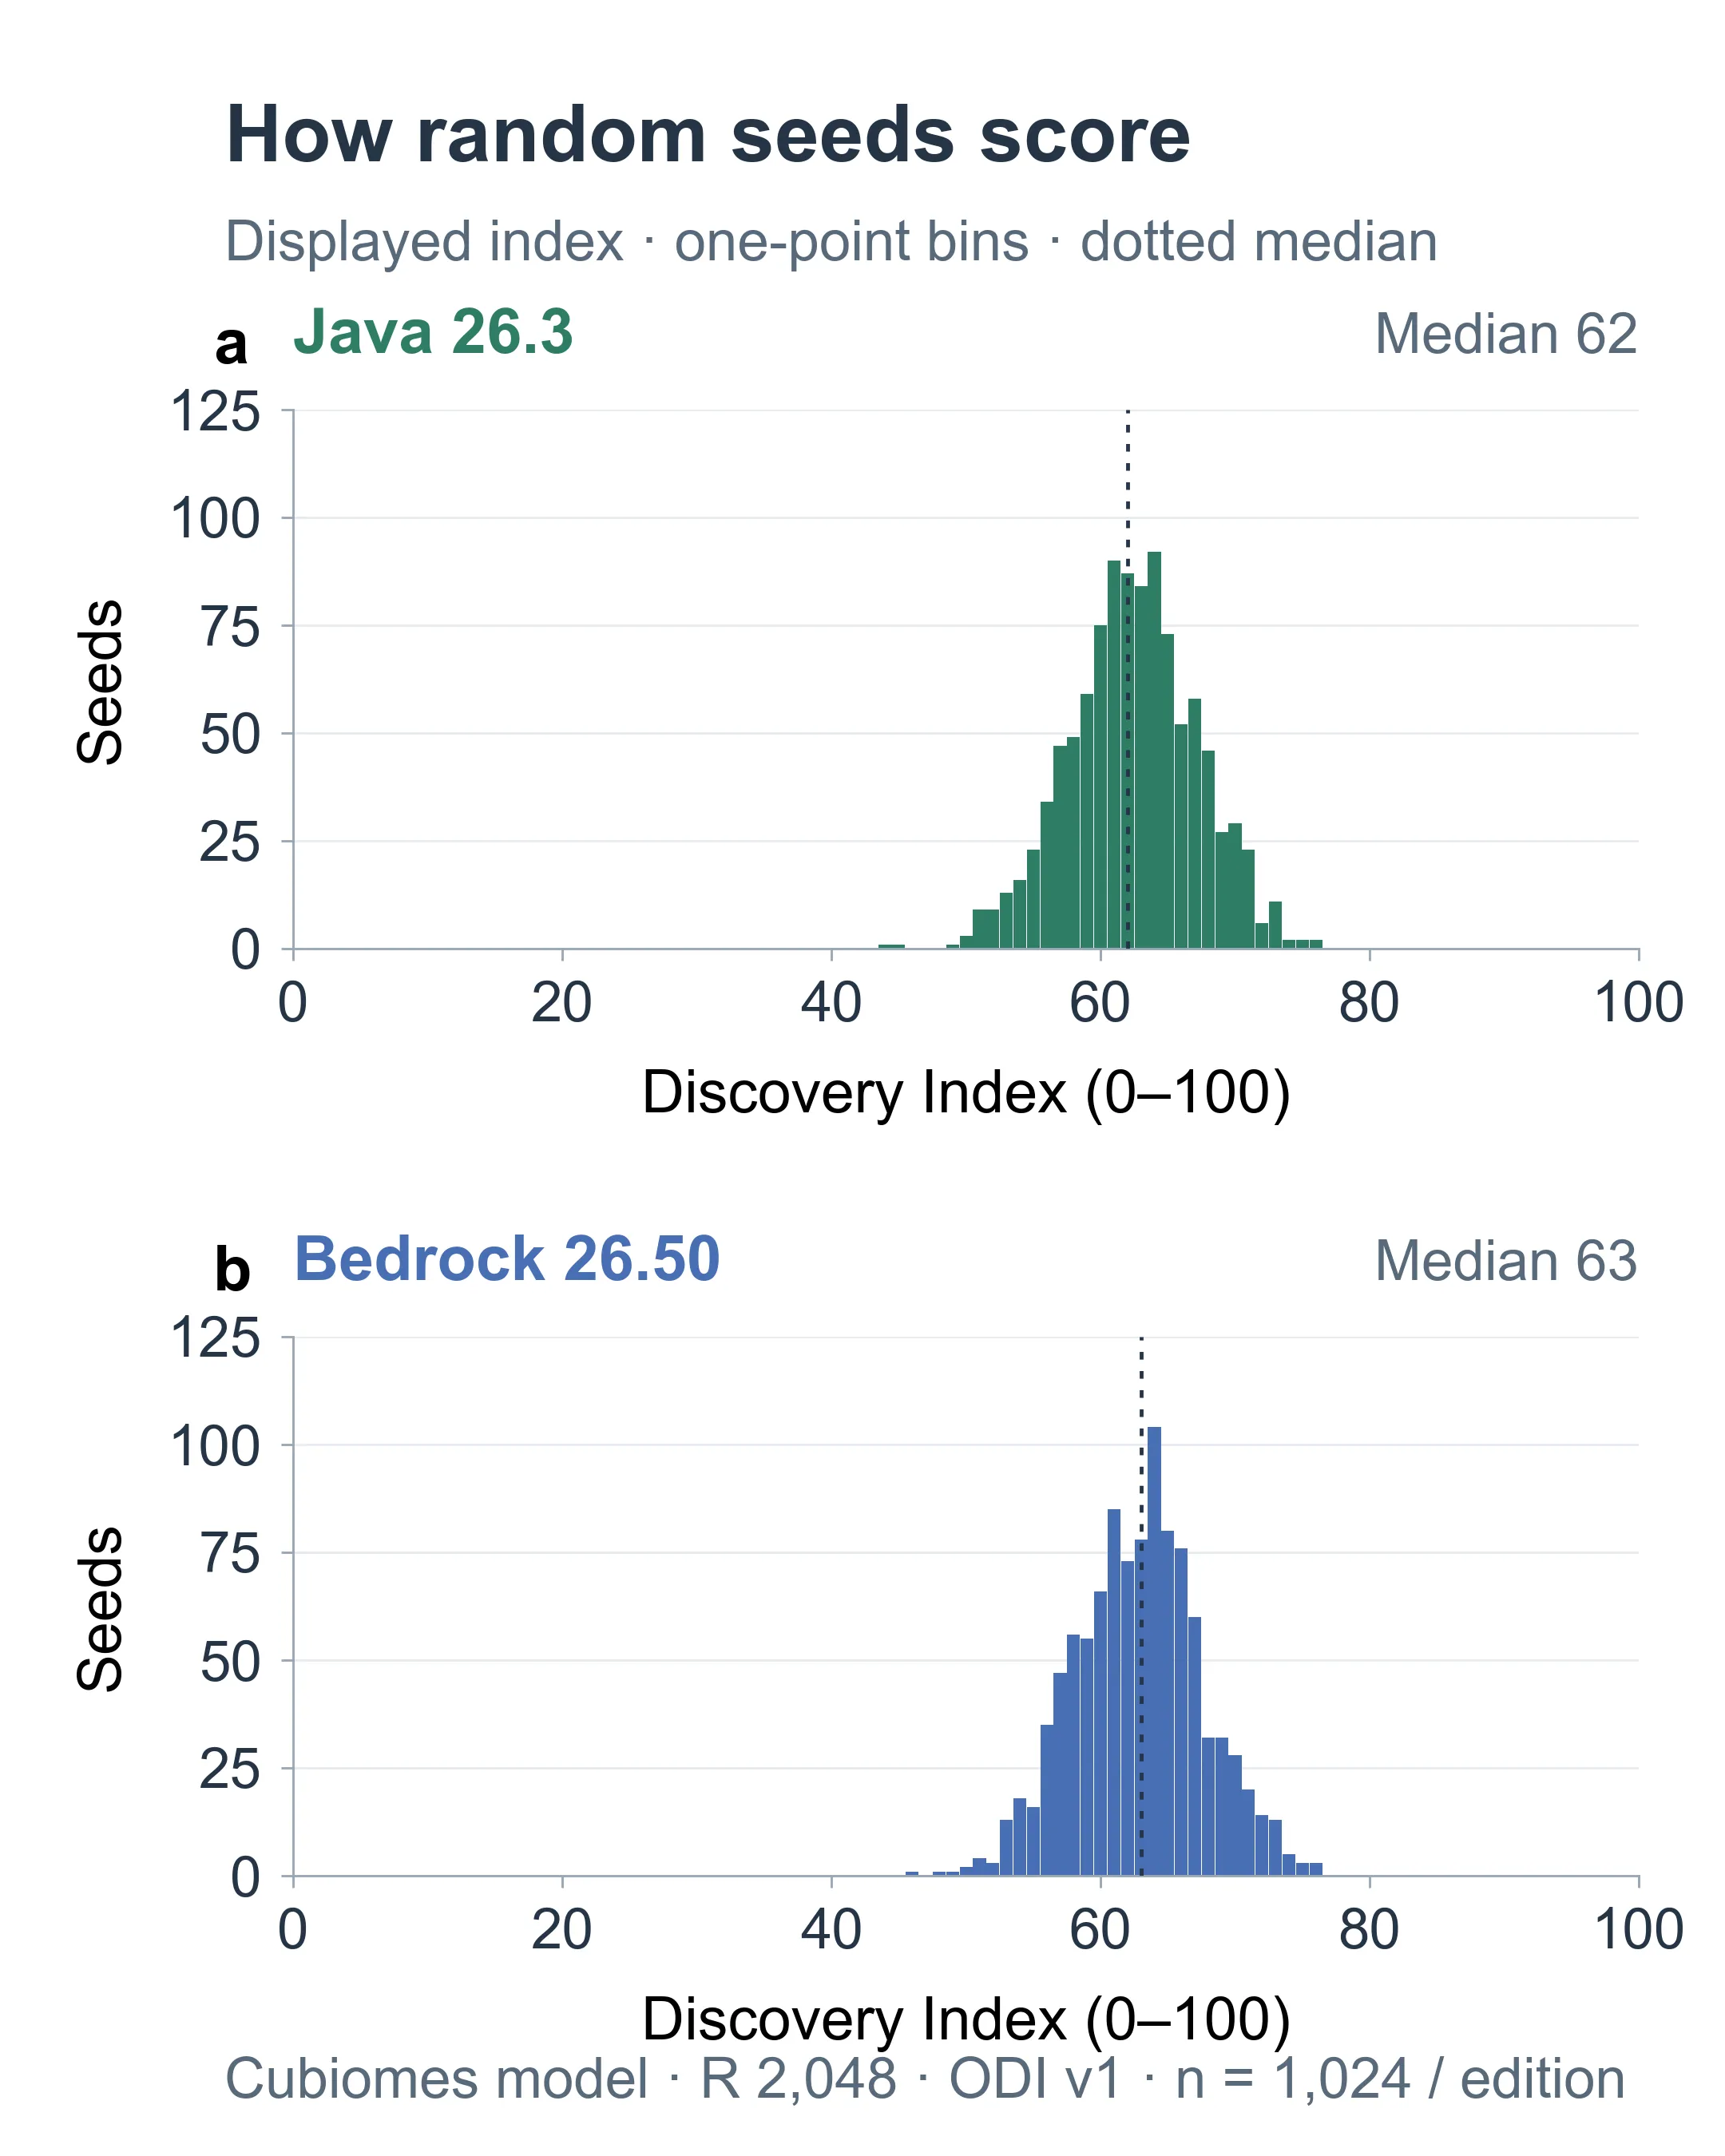
Predicciones del modelo de la calculadora. Cada barra estrecha cuenta las semillas con un valor concreto del índice mostrado. Ambos paneles usan la escala completa de 0 a 100 y la misma escala de recuento de semillas.
El eje horizontal es el índice mostrado; el vertical, el número de semillas muestreadas que lo reciben. Las barras más altas señalan puntuaciones más habituales en la cohorte. Las puntuaciones de Java van de 44 a 76 y las de Bedrock de 46 a 76. Sus medianas están cerca del centro de esas distribuciones observadas, muy por debajo del techo teórico de 100.
Una puntuación de 69 está, por tanto, por encima de la mediana de cualquiera de estas muestras de referencia correspondientes. El desglose de biomas y estructuras explica qué descubrimientos aportaron esos puntos.
Separar la variedad del valor por distancia
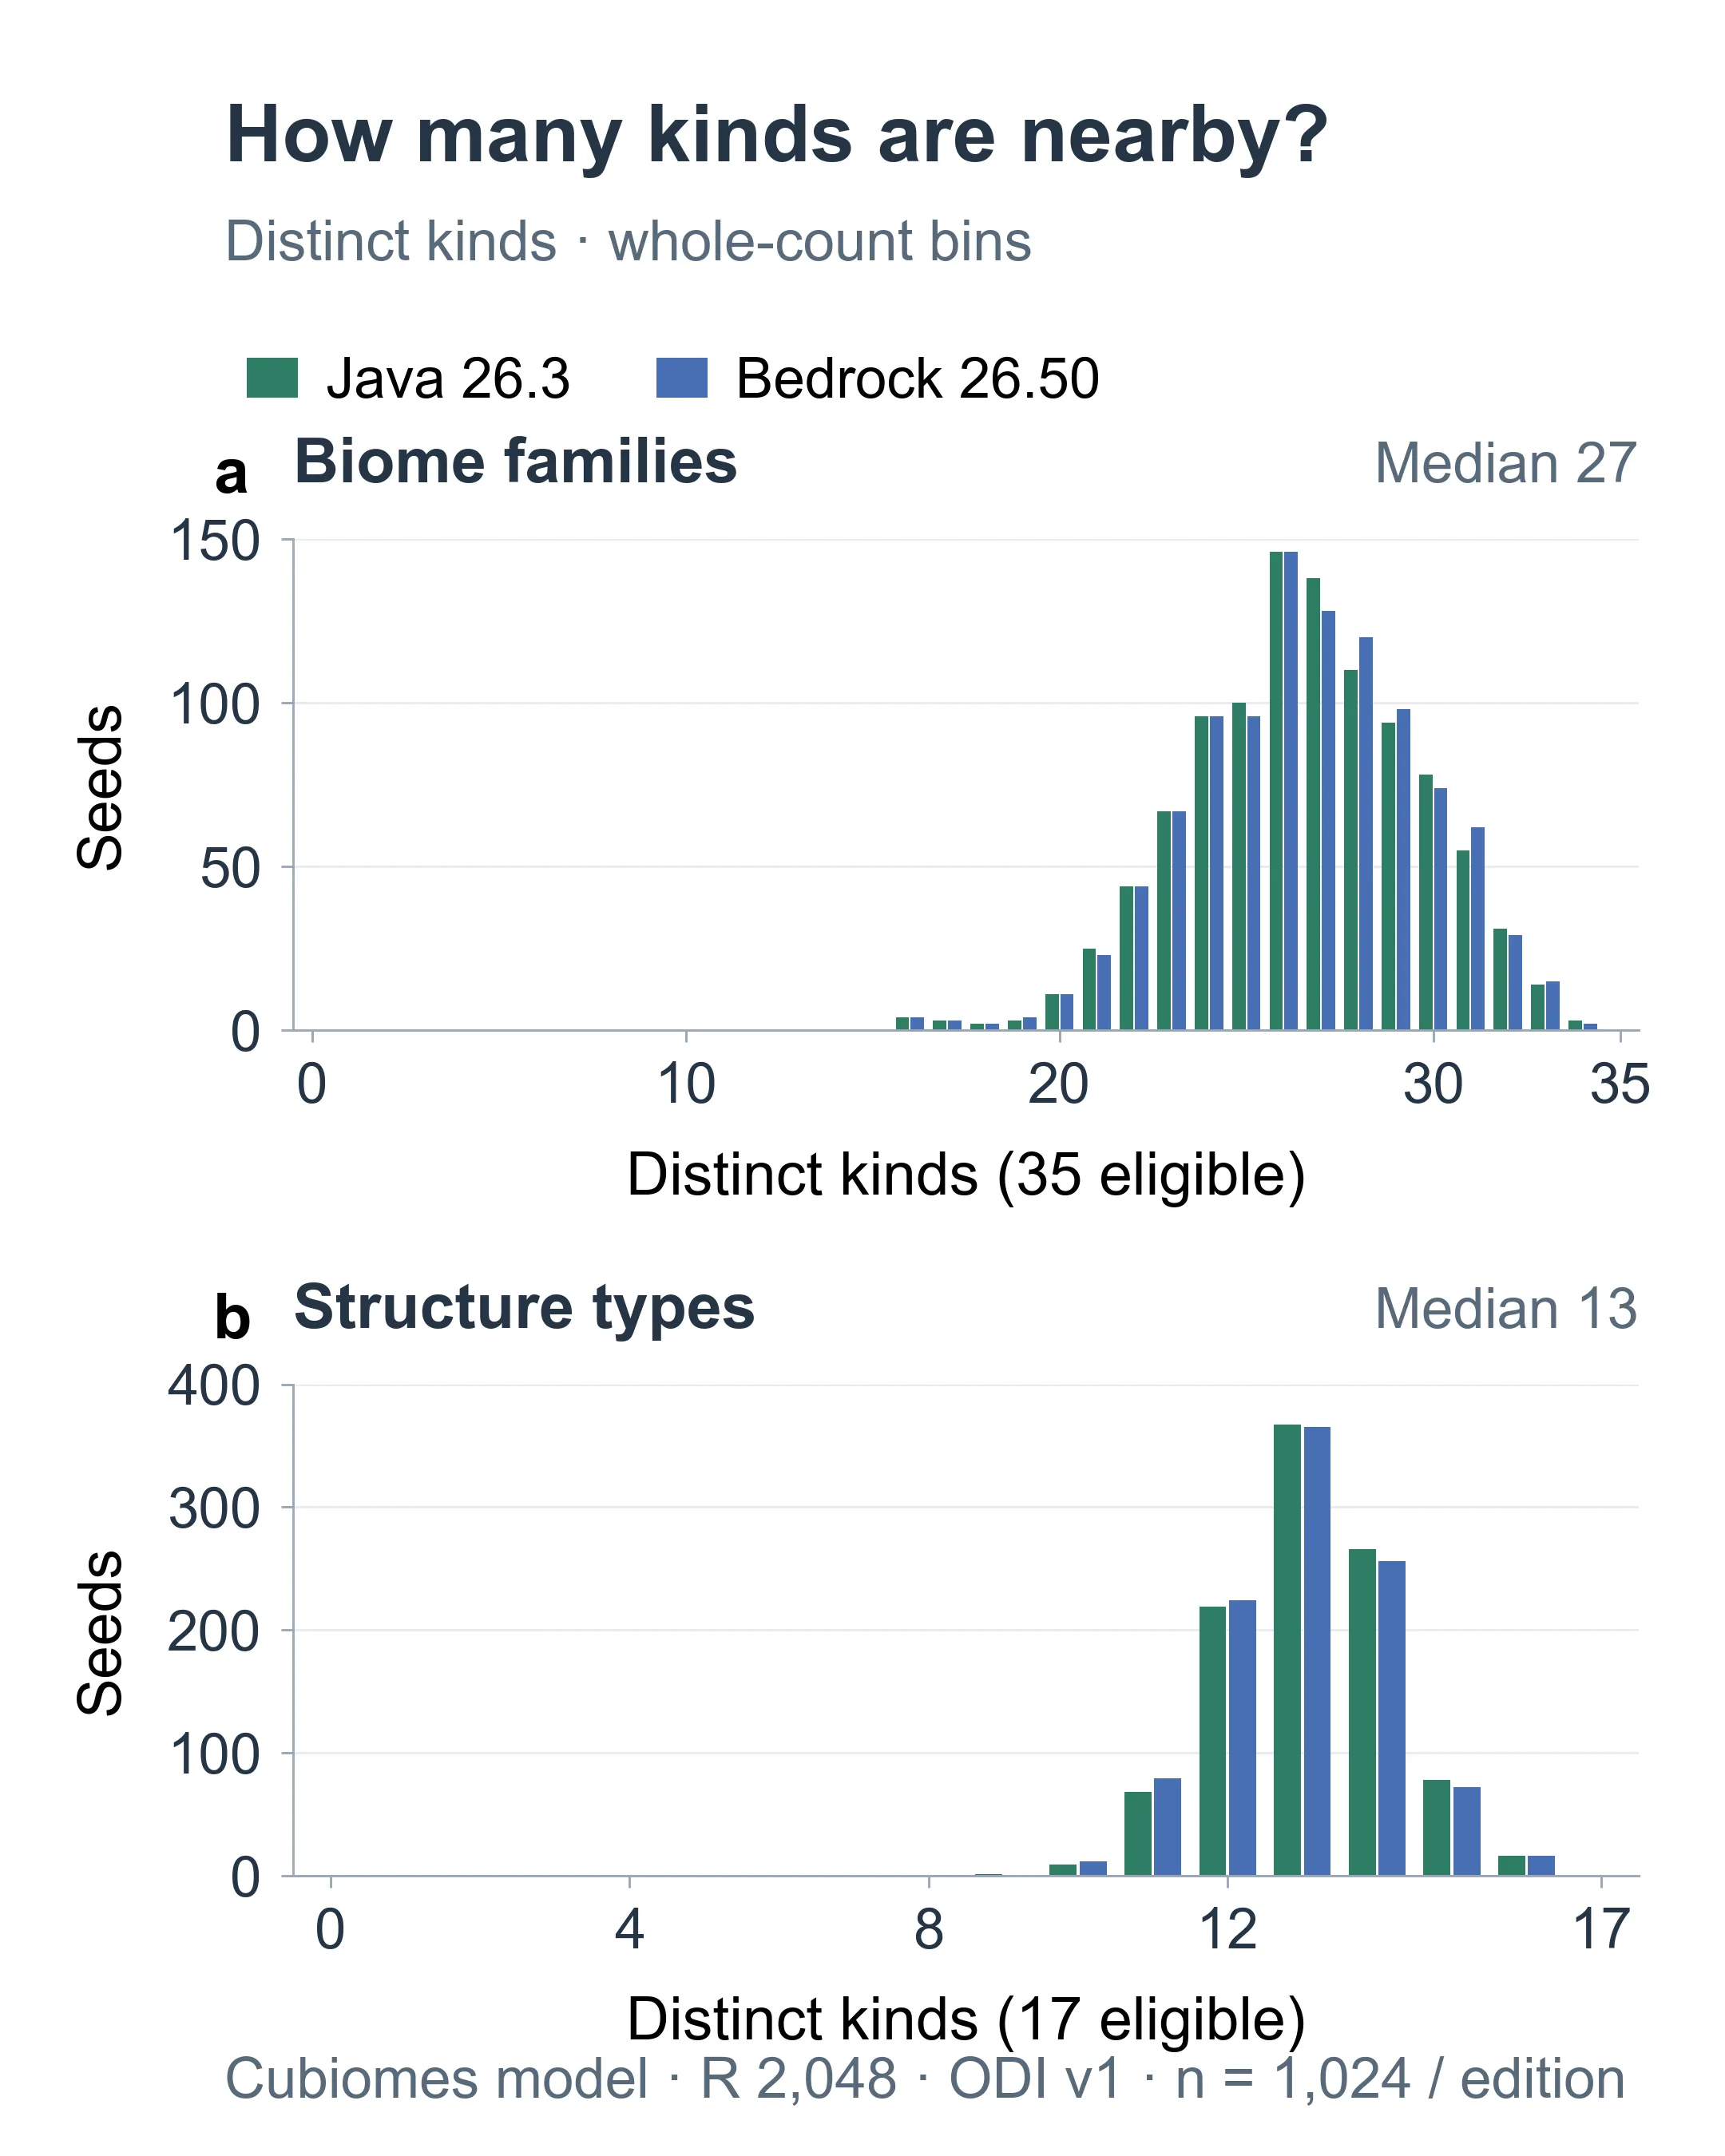
Cada barra cuenta las semillas del modelo con un número concreto de familias o tipos de estructuras representados. Se incluyen familias superficiales y de cuevas. Estos recuentos no se ponderan por distancia.
El panel superior muestra cuántas familias distintas de biomas se muestrearon dentro del círculo. El inferior muestra cuántos tipos distintos de estructuras tenían una predicción dentro de él. Lee por separado las barras verdes y azules de cada grupo entero; sumarlas combinaría dos ediciones cuyos ajustes de referencia deben mantenerse separados.
Ambas ediciones tienen una mediana de 27 familias muestreadas y 13 tipos previstos. Los recuentos de familias van de 16 a 34 en cada cohorte. Los de tipos previstos van de 9 a 16 en Java y de 10 a 16 en Bedrock. Ningún mundo muestreado representaba las 35 familias ni los 17 tipos con estos ajustes del modelo.
La variedad indica cuántas clases están representadas, sin considerar la distancia de sus muestras o predicciones más cercanas. La puntuación final también recompensa la proximidad. Por eso un recuento de 27 familias o de 13 estructuras no debe interpretarse como una puntuación parcial de 27 o 13 sobre 100.
Inspeccionar la mitad de biomas
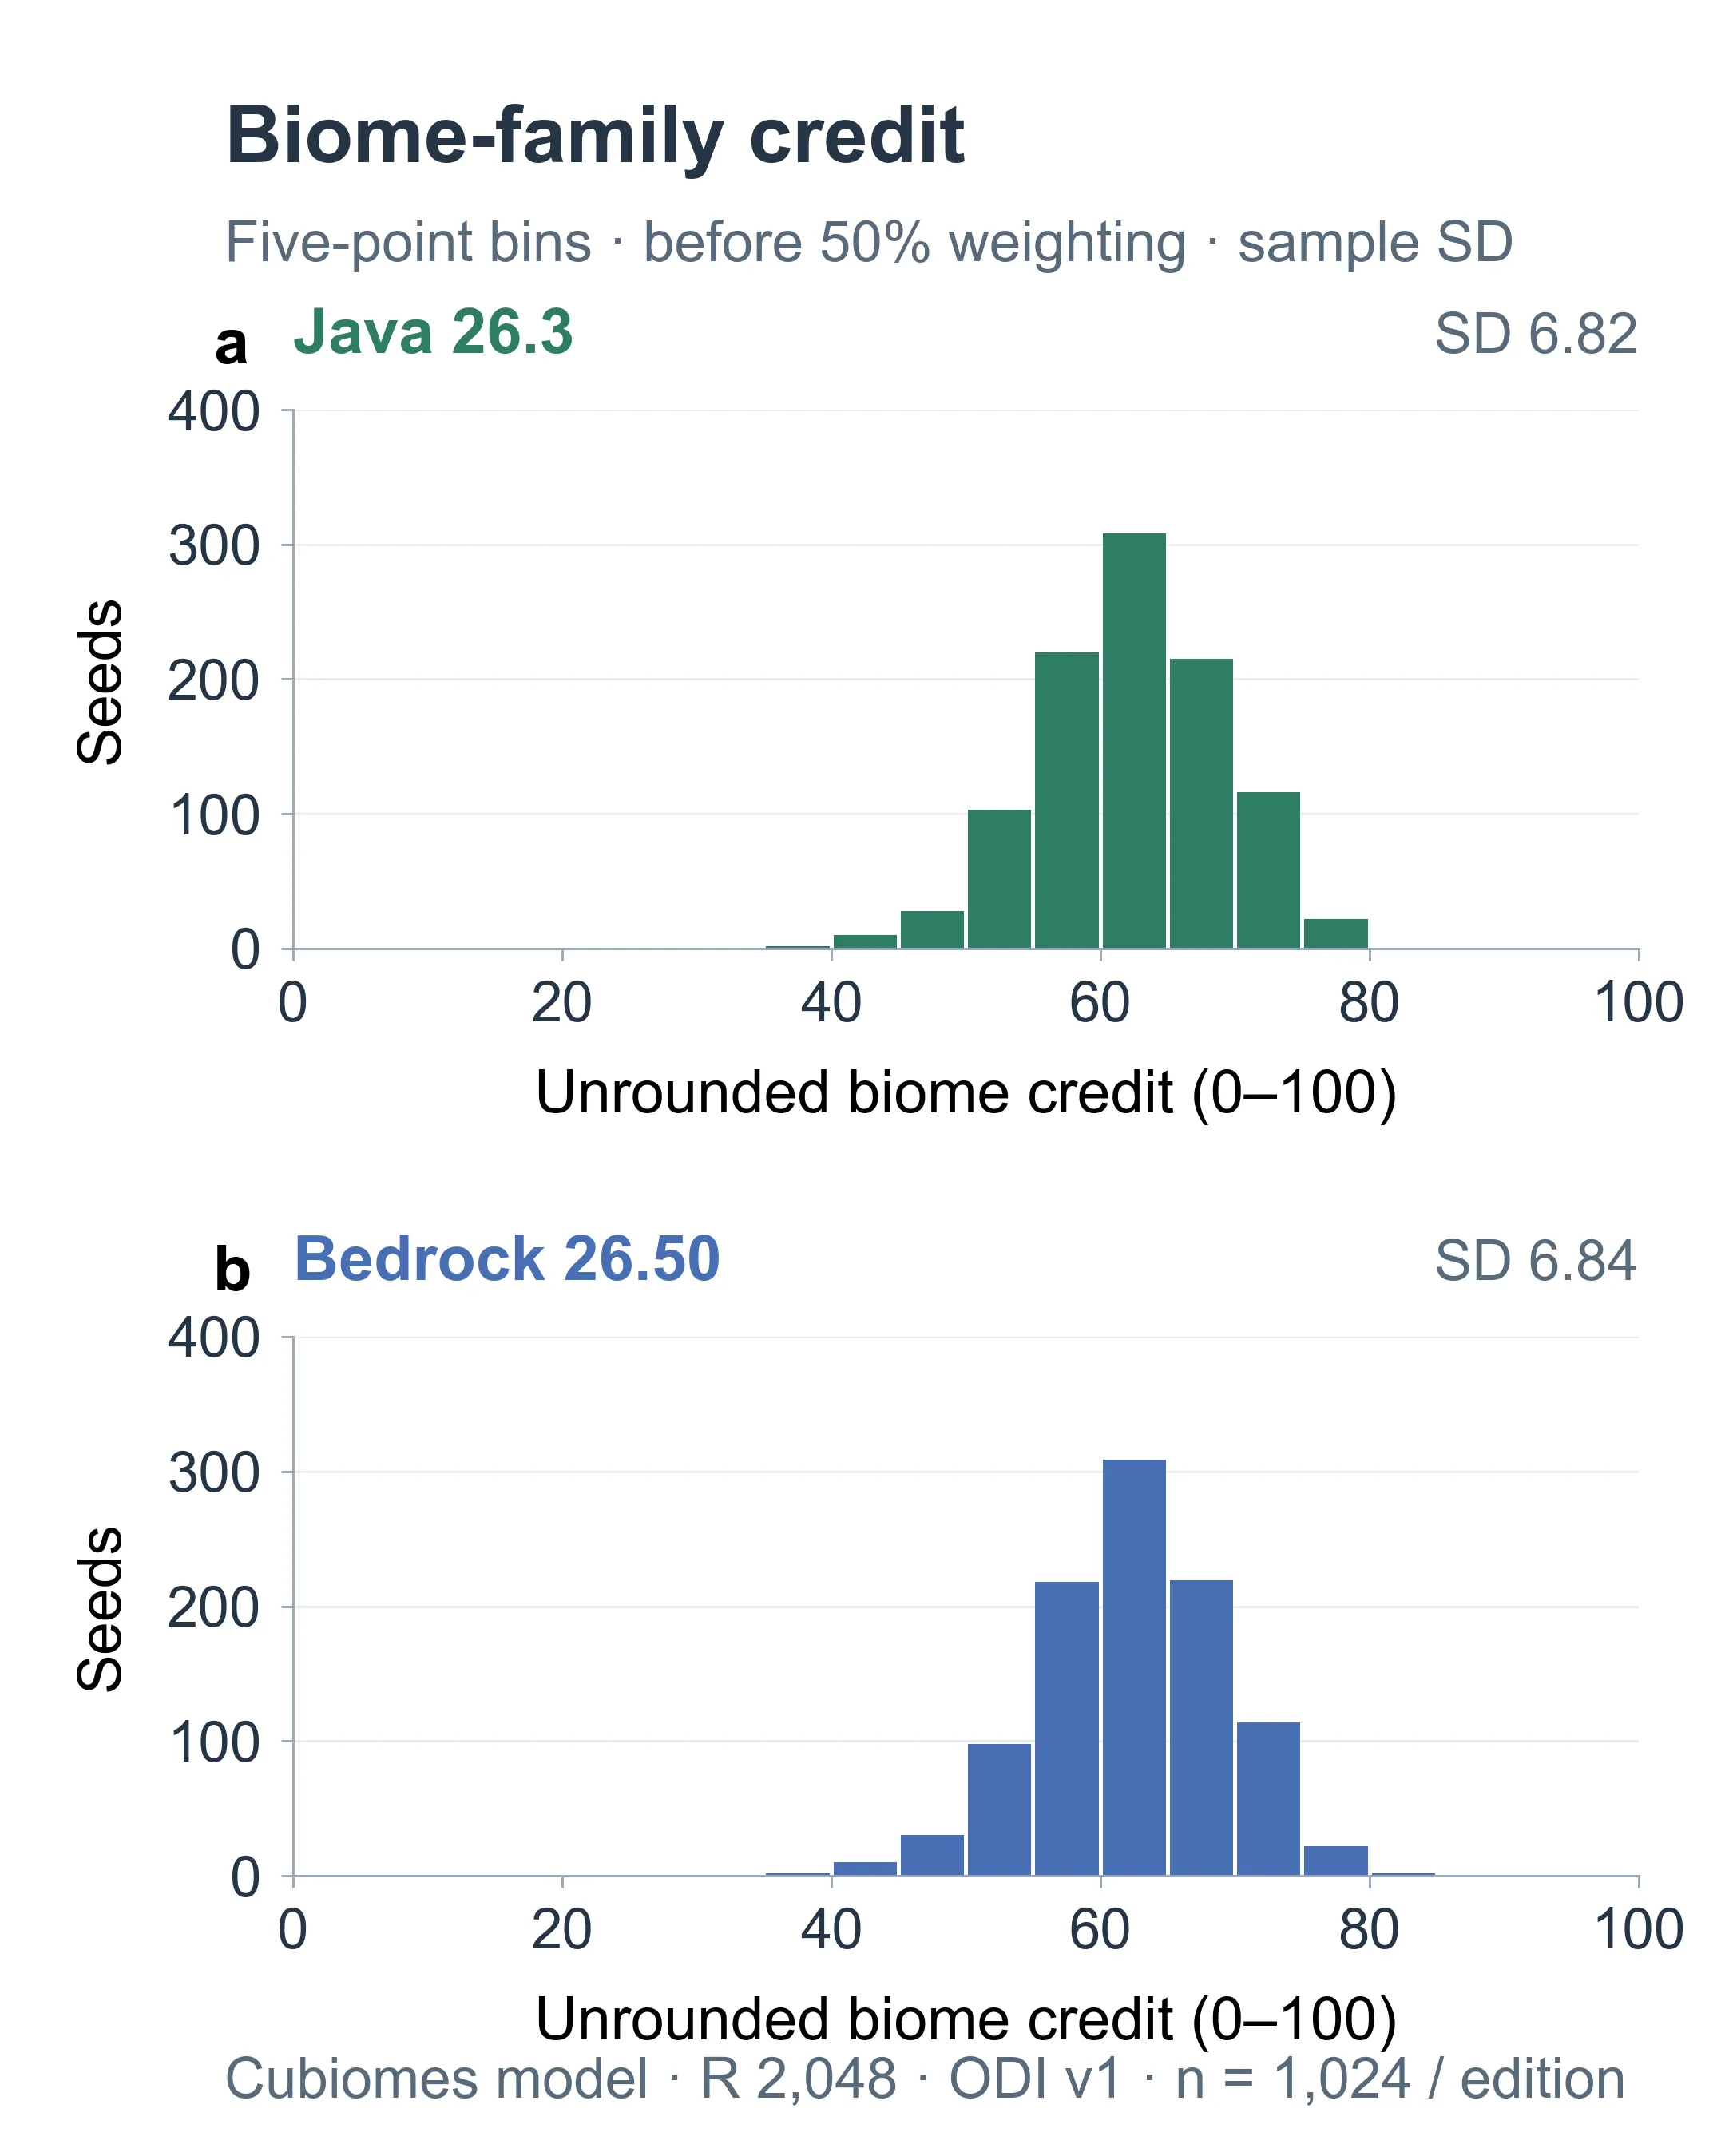
Predicciones del modelo de la misma muestra emparejada de semillas. Estos valores del eje horizontal son puntuaciones de biomas antes de aplicar su peso de la mitad en el índice global.
Cada barra abarca un intervalo de cinco puntos, a diferencia de las barras de un entero del histograma global. Un componente de biomas de 70 aportaría 35 puntos al índice antes del redondeo final. Significa que el valor medio de las familias admitidas es 0.70; no significa 70 familias ni que se haya explorado el 70% del círculo.
Las distribuciones de biomas varían más entre estas muestras que las de estructuras siguientes. Sus desviaciones estándar muestrales son de unos 6.82 puntos en Java y 6.84 en Bedrock. NIST describe la desviación estándar como una medida de dispersión alrededor de la media muestral, expresada en las unidades originales. Aquí son puntos del componente de la puntuación. Describe la variación entre puntuaciones de semillas, no un margen de error de la media. En nuestra prueba de diagnóstico, ambas distribuciones de biomas también muestran una desviación de la forma normal detectable estadísticamente después de corregir por pruebas múltiples.
El número de familias y las distancias producen conjuntamente esta dispersión. El histograma no identifica qué familia falta en una semilla concreta; los iconos y detalles de coordenadas de la calculadora responden a esa pregunta.
Inspeccionar la mitad de estructuras
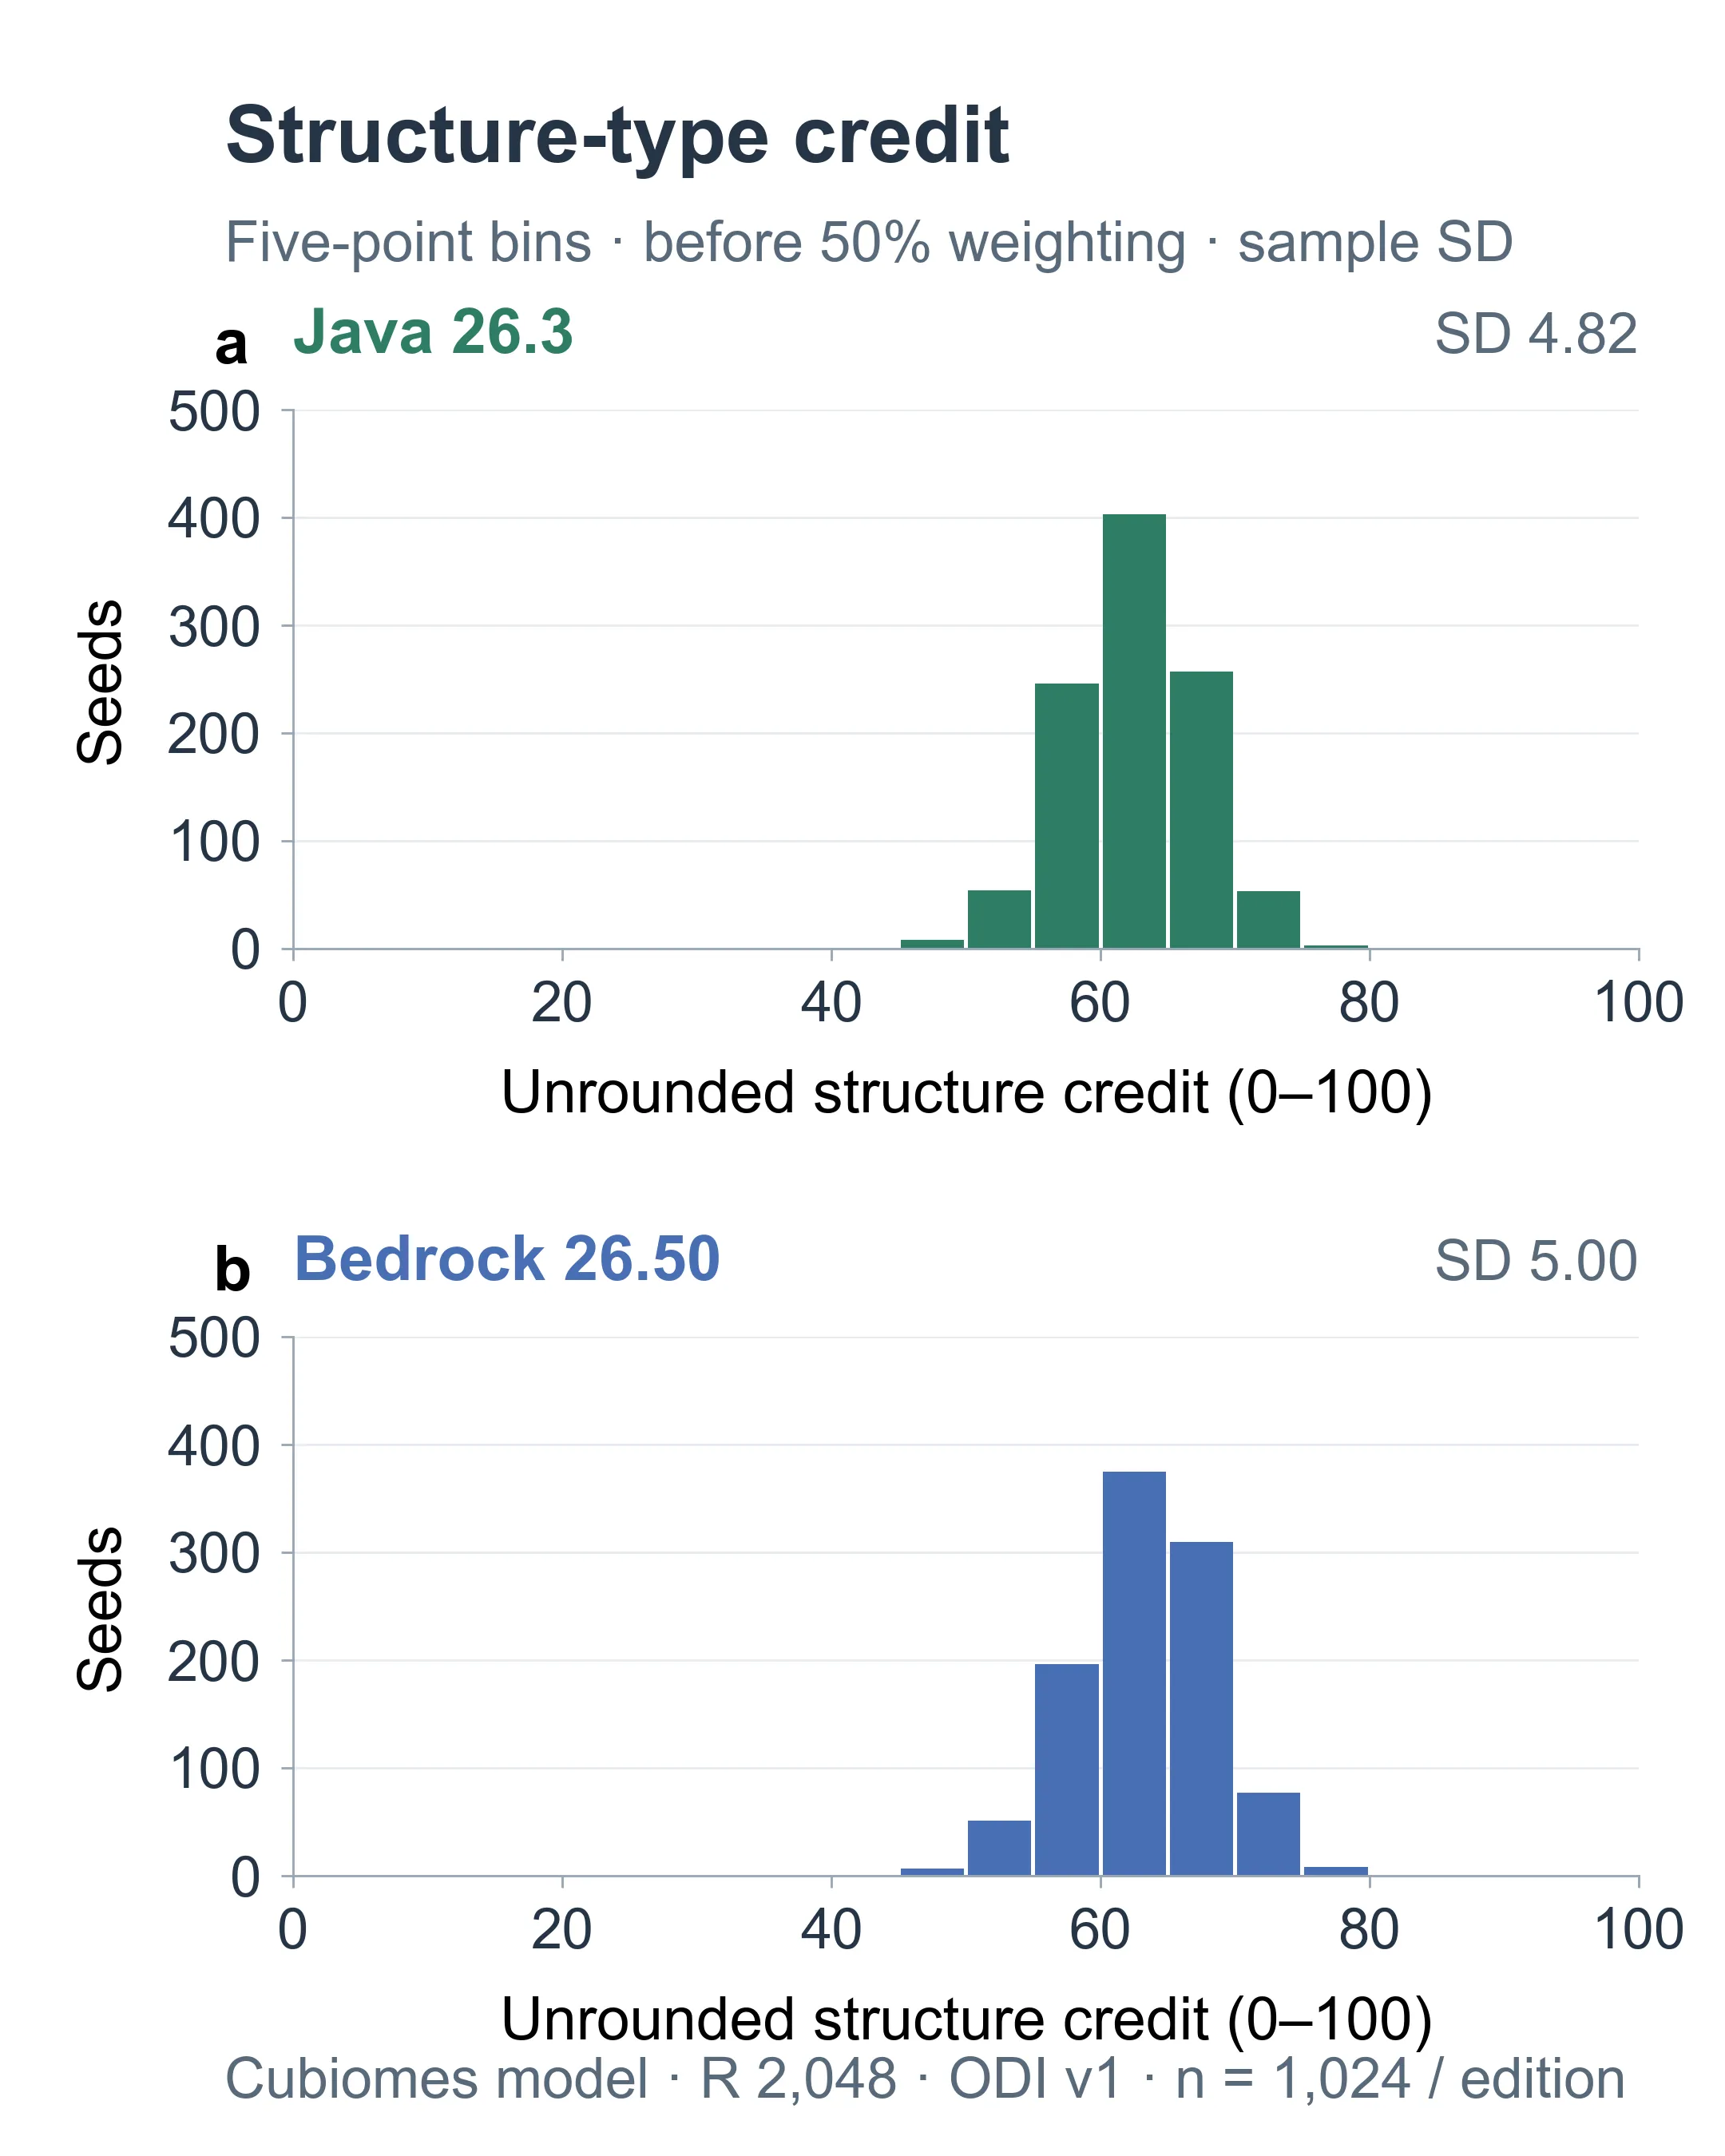
Cada tipo de estructura modelado aporta una sola vez mediante su predicción más cercana. La gráfica no cuenta todas las estructuras de un mundo.
Los ejes y los intervalos de cinco puntos tienen el mismo significado que en la gráfica de biomas, por lo que sus dispersiones horizontales son comparables. Cada gráfica tiene sus propias marcas verticales de recuento de semillas. Las desviaciones estándar muestrales son de unos 4.82 puntos en Java y 5.00 en Bedrock, menores que la dispersión del componente de biomas. Nuestra prueba de normalidad corregida no rechazó ninguna de las distribuciones del componente de estructuras.
La mitad de estructuras combina el número de tipos representados con la proximidad horizontal. Las aldeas adicionales del mismo tipo no añaden puntos de variedad, y una fortaleza prevista cercana no recibe un ajuste adicional por el esfuerzo de llegar a ella bajo tierra. Son propiedades de esta rúbrica, no conclusiones sobre la dificultad de esos mundos.
El índice global promedia estas dos puntuaciones distintas antes de redondear. Su distribución puede diferir de cualquiera de las mitades. En estas cohortes, el total tiene aproximadamente forma de campana aunque el componente de biomas se aparte de la normalidad. Evaluamos ese total directamente; combinar dos puntuaciones no establece una regla general para todas las versiones o radios.
Comprobar las colas con un gráfico Q-Q normal
Un histograma permite ver dónde se concentra la mayoría de las puntuaciones, pero sus intervalos pueden ocultar pequeñas diferencias de forma. El gráfico Q-Q normal compara las puntuaciones ordenadas sin redondear con las esperadas de una distribución normal usando la media observada y la desviación estándar muestral de cada cohorte. La explicación de NIST sobre gráficos de probabilidad normal describe cómo las desviaciones de una recta de referencia revelan diferencias respecto a una forma normal.
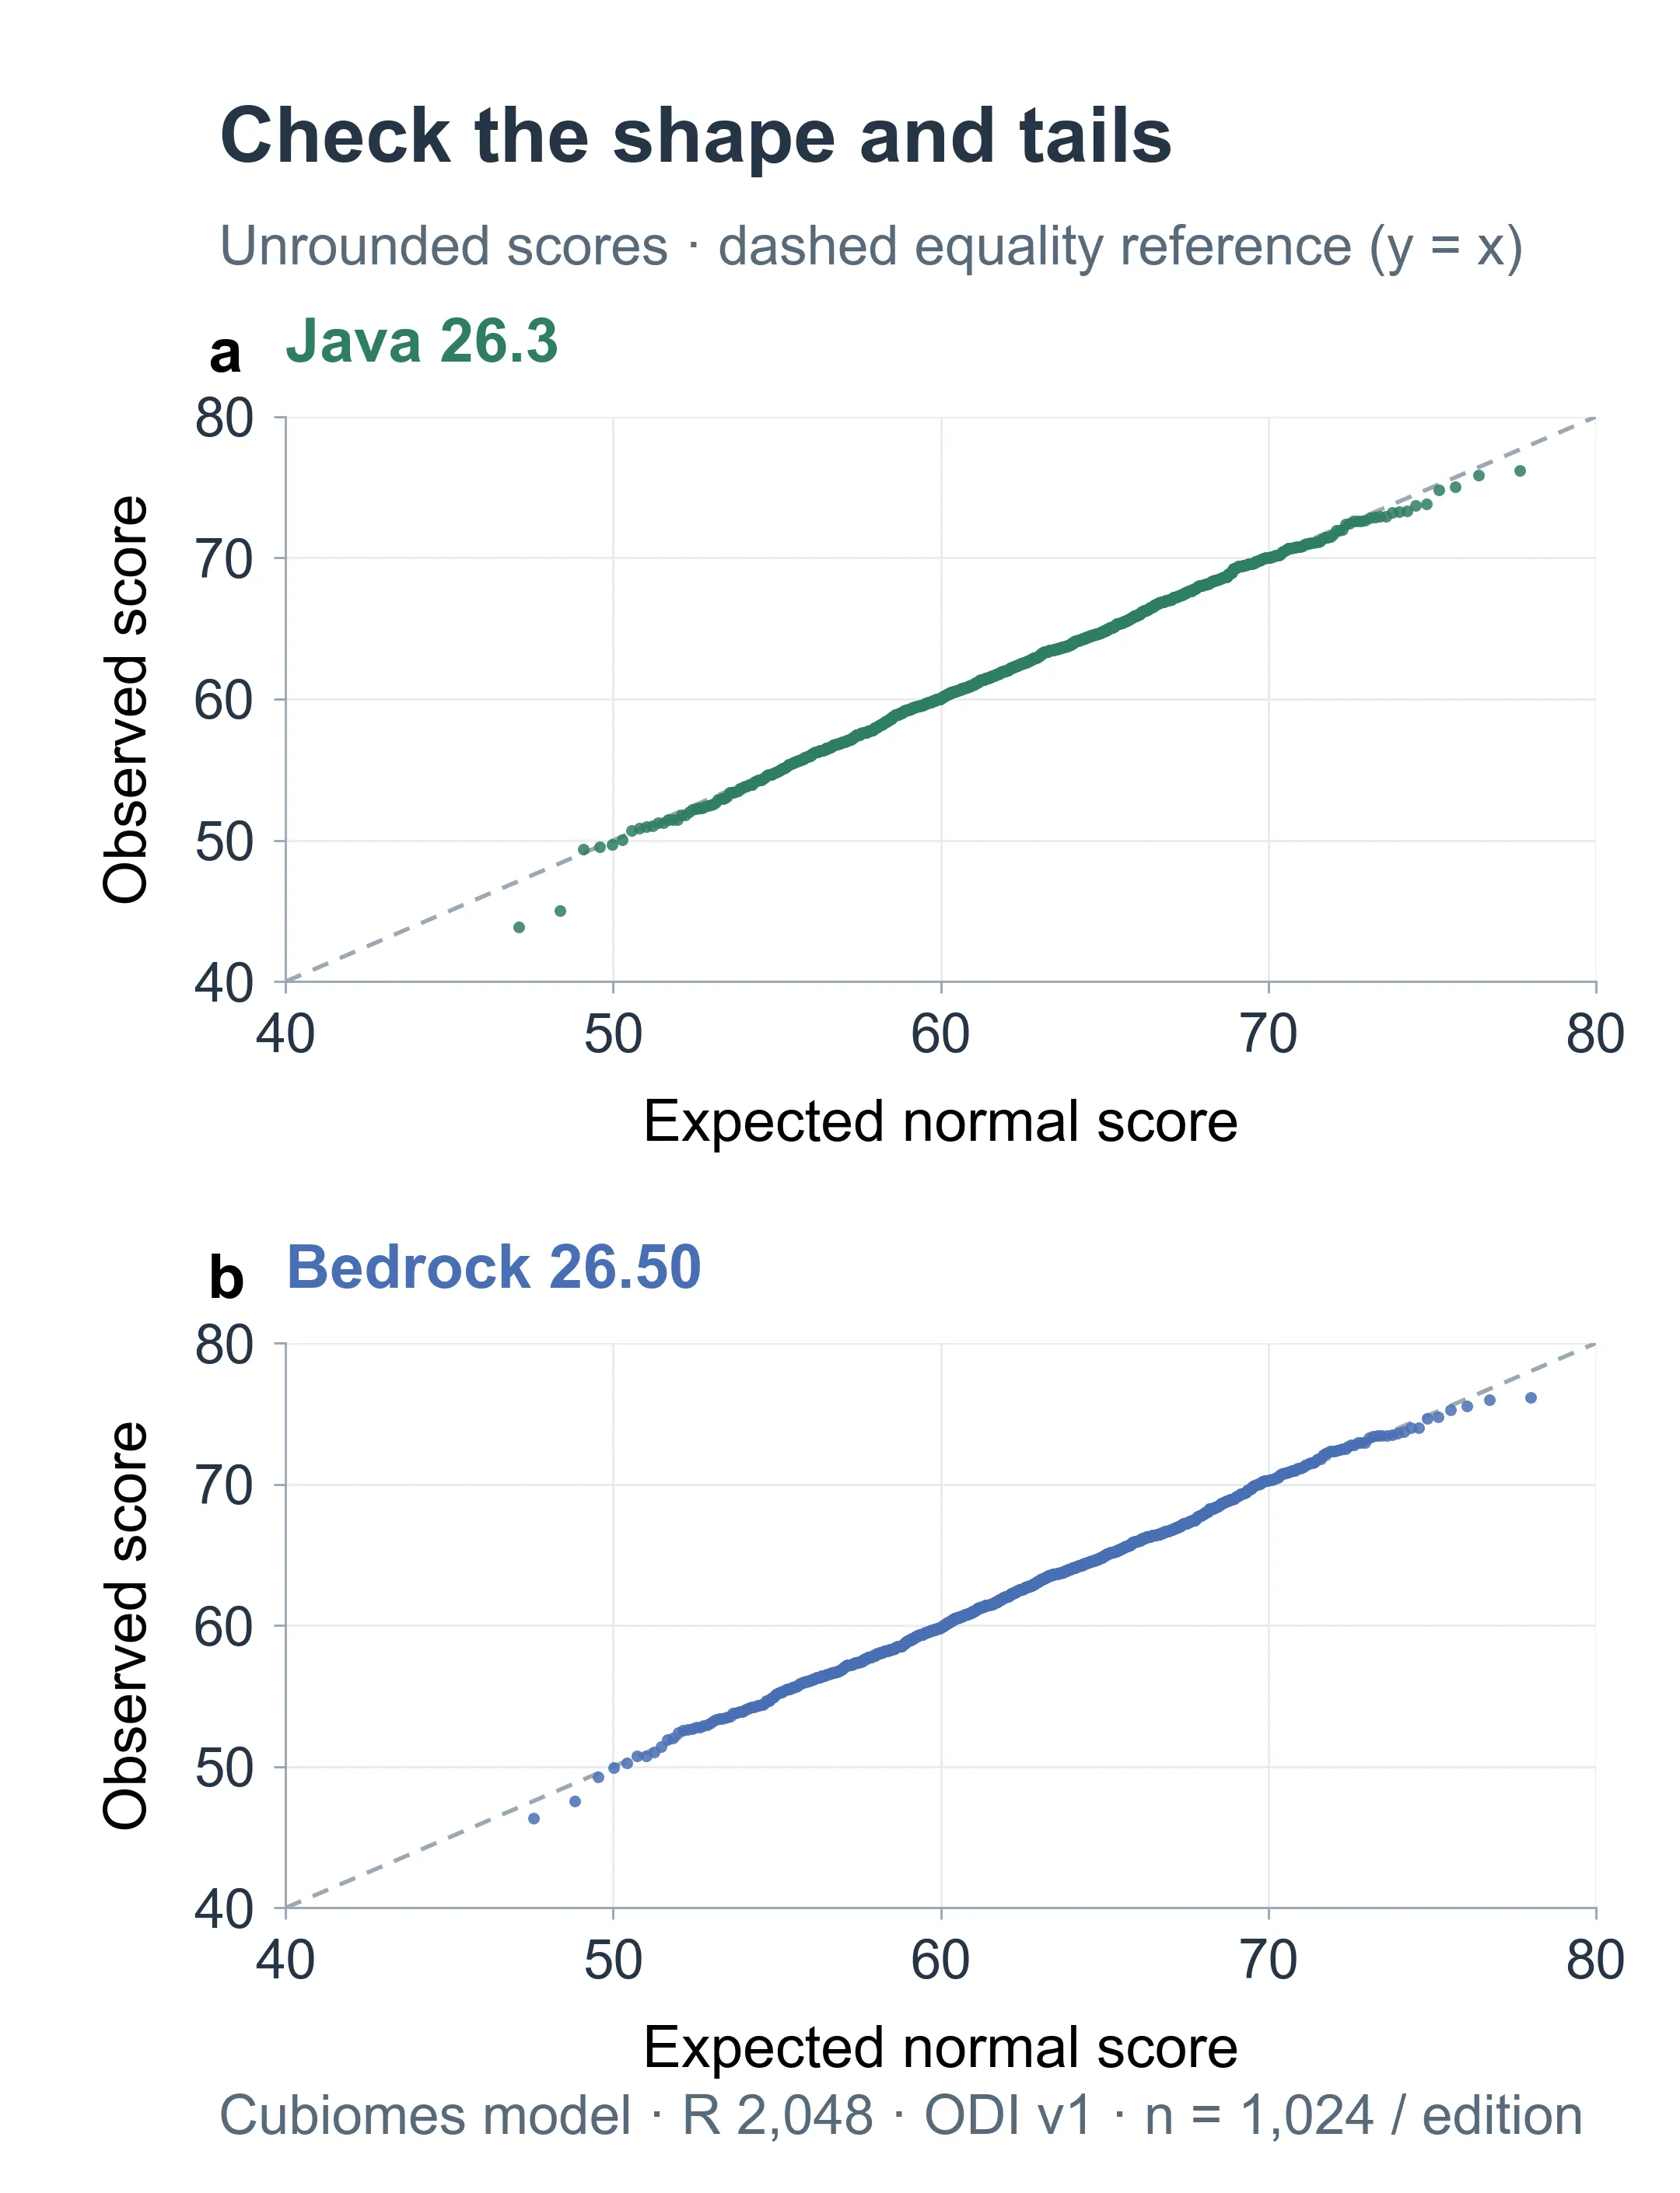
Cada panel contiene las 1,024 puntuaciones globales sin redondear. Las puntuaciones normales esperadas usan la media y la desviación estándar de la muestra; la diagonal gris marca valores esperados y observados iguales. No es una banda de confianza.
Ambos ejes usan puntos del índice. Un punto en la diagonal tiene la puntuación observada esperada en esa posición de la comparación normal. Los puntos superiores tienen puntuaciones observadas mayores; los inferiores, menores. Los extremos izquierdo y derecho representan las colas baja y alta de la muestra.
La mayoría de los puntos sigue de cerca la diagonal, con desviaciones en los extremos. Esos puntos finales importan cuando la pregunta trata de puntuaciones excepcionalmente bajas o altas. Un ajuste cercano en el centro no establece una estimación fiable de la curva normal para una puntuación muy rara fuera del intervalo observado.
Qué establece la comprobación de normalidad
Aplicamos la prueba de Shapiro-Wilk documentada por SciPy a la puntuación global sin redondear y a ambos componentes sin redondear de cada edición. Usar valores sin redondear evita tratar los empates de enteros de la visualización como mediciones continuas. Usamos un umbral de 0.05 y la corrección de Holm para esas seis pruebas.
| Distribución evaluada | Valor p ajustado de Java 26.3 | Valor p ajustado de Bedrock 26.50 | Resultado a 0.05 |
|---|---|---|---|
| Índice global | 0.667 | 0.667 | Desviación no detectada |
| Componente de biomas | 0.0059 | 0.0059 | Desviación detectada |
| Componente de estructuras | 0.231 | 0.472 | Desviación no detectada |
Los valores p sin ajustar de las pruebas globales fueron 0.334 para Java y 0.660 para Bedrock. La falta de rechazo es coherente con las formas aproximadamente acampanadas de estas muestras concretas. No demuestra normalidad, no certifica los modelos de generación ni indica la probabilidad de que un mundo sea divertido.
Las puntuaciones siguen limitadas entre 0 y 100. Para comparar semillas usamos las frecuencias observadas reales, sin convertir una puntuación mediante una curva normal ajustada. Las pruebas y gráficas describen estas dos cohortes; otras ediciones, versiones, radios o revisiones futuras de la rúbrica necesitan su propia evaluación.
El resumen estadístico completo y todos los resultados muestreados del modelo conservan las mediciones de estas figuras. Las cinco figuras de distribución usan la misma muestra emparejada; la de valor por distancia ilustra la fórmula.
Contextualizar una puntuación individual
Para la semilla de ejemplo Java 26.3 12345, la calculadora prevé una puntuación de 69, con 30 de las 35 familias muestreadas y 14 de los 17 tipos de estructuras previstos. Esa cobertura suma unos 84 puntos posibles antes de descontar la distancia: 50 × 30 / 35 + 50 × 14 / 17 ≈ 84. Las distancias más cercanas lo reducen al 69 mostrado. En la muestra de referencia correspondiente, 922 puntuaciones fueron inferiores, 27 iguales y 75 superiores.
Los empates importan. Cada 69 mostrado representa un resultado redondeado y distintas combinaciones de valor de biomas y estructuras pueden producirlo. Los recuentos exactos de puntuaciones mostradas inferiores, iguales y superiores conservan esos empates. También explican la comparación de manera más directa que asignar sin avisar el mismo percentil normal estimado a todas las semillas empatadas.
La calculadora muestra el histograma observado, la mediana muestral, el intervalo P10 a P90 y los recuentos por debajo, iguales y por encima de tu puntuación cuando coinciden exactamente la edición, versión, radio, rúbrica y modelo de generación. Los demás ajustes también reciben su desglose de descubrimientos; actualmente carecen de una muestra de referencia correspondiente.
La frecuencia de encuentro también necesita su propio denominador. En la cohorte de Java 26.3 con este radio, el modelo muestreó una familia de campos de champiñones en 294 de 1,024 semillas (28.7%) y previó una mansión del bosque en 158 (15.4%). Son apariciones en algún lugar del círculo del punto de aparición estimado, no la probabilidad de aparecer en ese bioma ni una medida de su superficie global.
Un histograma global indica con qué frecuencia produjo la calculadora ciertos totales en esta muestra. Un criterio ponderado por rareza respondería a otra pregunta sobre la frecuencia de encuentro de familias o tipos de estructuras concretos. La revisión 1 conserva pesos iguales dentro de cada categoría; estas mediciones no se han convertido en bonificaciones por rareza. Ese cambio necesitaría referencias de encuentros ajustadas a la edición, versión de generación, radio y reglas de muestreo, además de una nueva revisión aprobada de la rúbrica.
Esta es una muestra de referencia de predicciones del modelo, no un percentil de rareza de la población, una muestra de mundos jugados ni una medida de cuánto viajan los jugadores. Una puntuación de 80 no significa que la semilla tenga más variedad que el 80% de todas las semillas. Usa la calculadora para comparar los descubrimientos modelados del área que planeas explorar y después inspecciona en el mapa las posiciones que te interesan.