seedlookout
Minecraftのシード体験指数は、探索したい範囲に、このシードがどれだけ異なる地形や何種類の目的地を提供するか、という実用的な問いに役立ちます。
シード体験計算ツールでは、これをオーバーワールド探索指数と呼びます。標本で調べたバイオーム群と、予測した構造物の種類を0から100のスコアにまとめ、推定スポーンに近い発見ほど高く評価します。エディション、地形生成バージョン、半径は自分で選びます。スコアはモデル上の多様性を示しますが、そこで遊びたいかを決めるのは自分の好みです。
2つの生成モデルで、それぞれ1,024個の疑似乱数シードを調べました。半径2,048ブロックでの表示指数の中央値は、Java 26.3が62、Bedrock 26.50が63でした。評価基準の数学的な上限100は、この標本の中心とは別の量です。以下の図で、スコアを楽しさの評価に変えずに、その位置付けを理解する方法を説明します。
探索半径を選ぶ
計算ツールでは512、1,024、2,048、4,096ブロックの半径を選べます。どれも推定ワールドスポーンから水平に測った円です。半径2,048ブロックは各方向にその距離まで届く範囲であり、2,048ブロック歩けば内部をすべて訪れるという意味ではありません。
ツールには初期の対象範囲が必要なので、既定値は2,048ブロックにしています。この選択を、Minecraftプレイヤーの探索距離を代表する測定値に合わせて調整したわけではありません。Mojangの探索ガイドは短い外出も大きな冒険も説明していますが、平均半径は示していません。
求めるワールドに合う半径を選んでください。小さな円は近場の多様性を調べます。大きな円はより多くの目的地候補を含み、同じ近場の発見にも距離による得点を多く与えます。2つのシードを比べる際は、同じ問いを保つために半径をそろえてください。
半径は、検索範囲と特定の距離に対する得点の2つを変えます。スポーンから1,024ブロック離れた予測は、半径2,048では0.75、半径4,096では0.875の得点を得ます。別の種類が見つからなくても、半径を広げるとスコアが上がることがあります。これはより広い探索範囲への答えであり、シード自体が改善したという意味ではありません。
異なる体験を数える
バイオームをそのまま数えると、よく似た地形で複数の点を得ることがあります。計算ツールは元のIDを表示しつつ、得点では関連する変種をまとめます。平原とヒマワリ平原は同じ群です。海洋と深海も1つの群になります。花の森は独立した群で、洞窟の各群も別に数えます。
この群分けは私たちの編集上の定義です。進捗の達成度を採点するツールではありません。対象となる各群は、バイオームのスコア内で同じ重みを持ちます。選択した生成モデルのバージョン別カタログに、その群のバイオームが含まれる場合にのみ対象となります。
地表では、近似的な地表高度で32ブロック間隔の格子を調べます。その高度で洞窟バイオームが返されたら、地表の集計から除きます。狭い領域は格子点の間に入るため、元の集計は標本で見つけたバイオームIDの数であり、漏れのない一覧ではありません。
洞窟では64ブロック間隔の格子を使い、Y -48, -32, -16, 0, 16, 32 and 48で、近似地表より少なくとも8ブロック下にある点を残します。標本は洞窟バイオームの領域を特定しますが、点が固体の地形内にある場合もあり、その座標に通れる洞窟がある証拠にはなりません。この最初の評価基準では、上下の移動や掘る労力に距離のペナルティを付けていません。
構造物は種類ごとに得点します。円内に何件の村の予測があっても、村は1回だけ数えます。村と難破船なら、異なる2種類です。計算ツールは対象となる各種類の最寄りの予測を探し、バージョン別の基準が対応する場合は地下の目的地も含めます。
廃坑は、利用できる最寄り検索が選択可能な全半径で探索範囲を確定できないため、すべてのプロファイルから除外しています。このため、スコアは掲載した基準を測るもので、オーバーワールドのあらゆる目的地を測るものではありません。
近くの発見を高く評価する
見つかったバイオーム群や構造物の種類ごとに、水平距離で得点が決まります。
credit = 1 − 0.5 × distance / radius
スポーンでの発見は1、半径の半分の距離では0.75、境界では0.5を得ます。見つからない基準は0です。各カテゴリの平均では、見つからなかったものも含む、対象の全基準を分母にします。
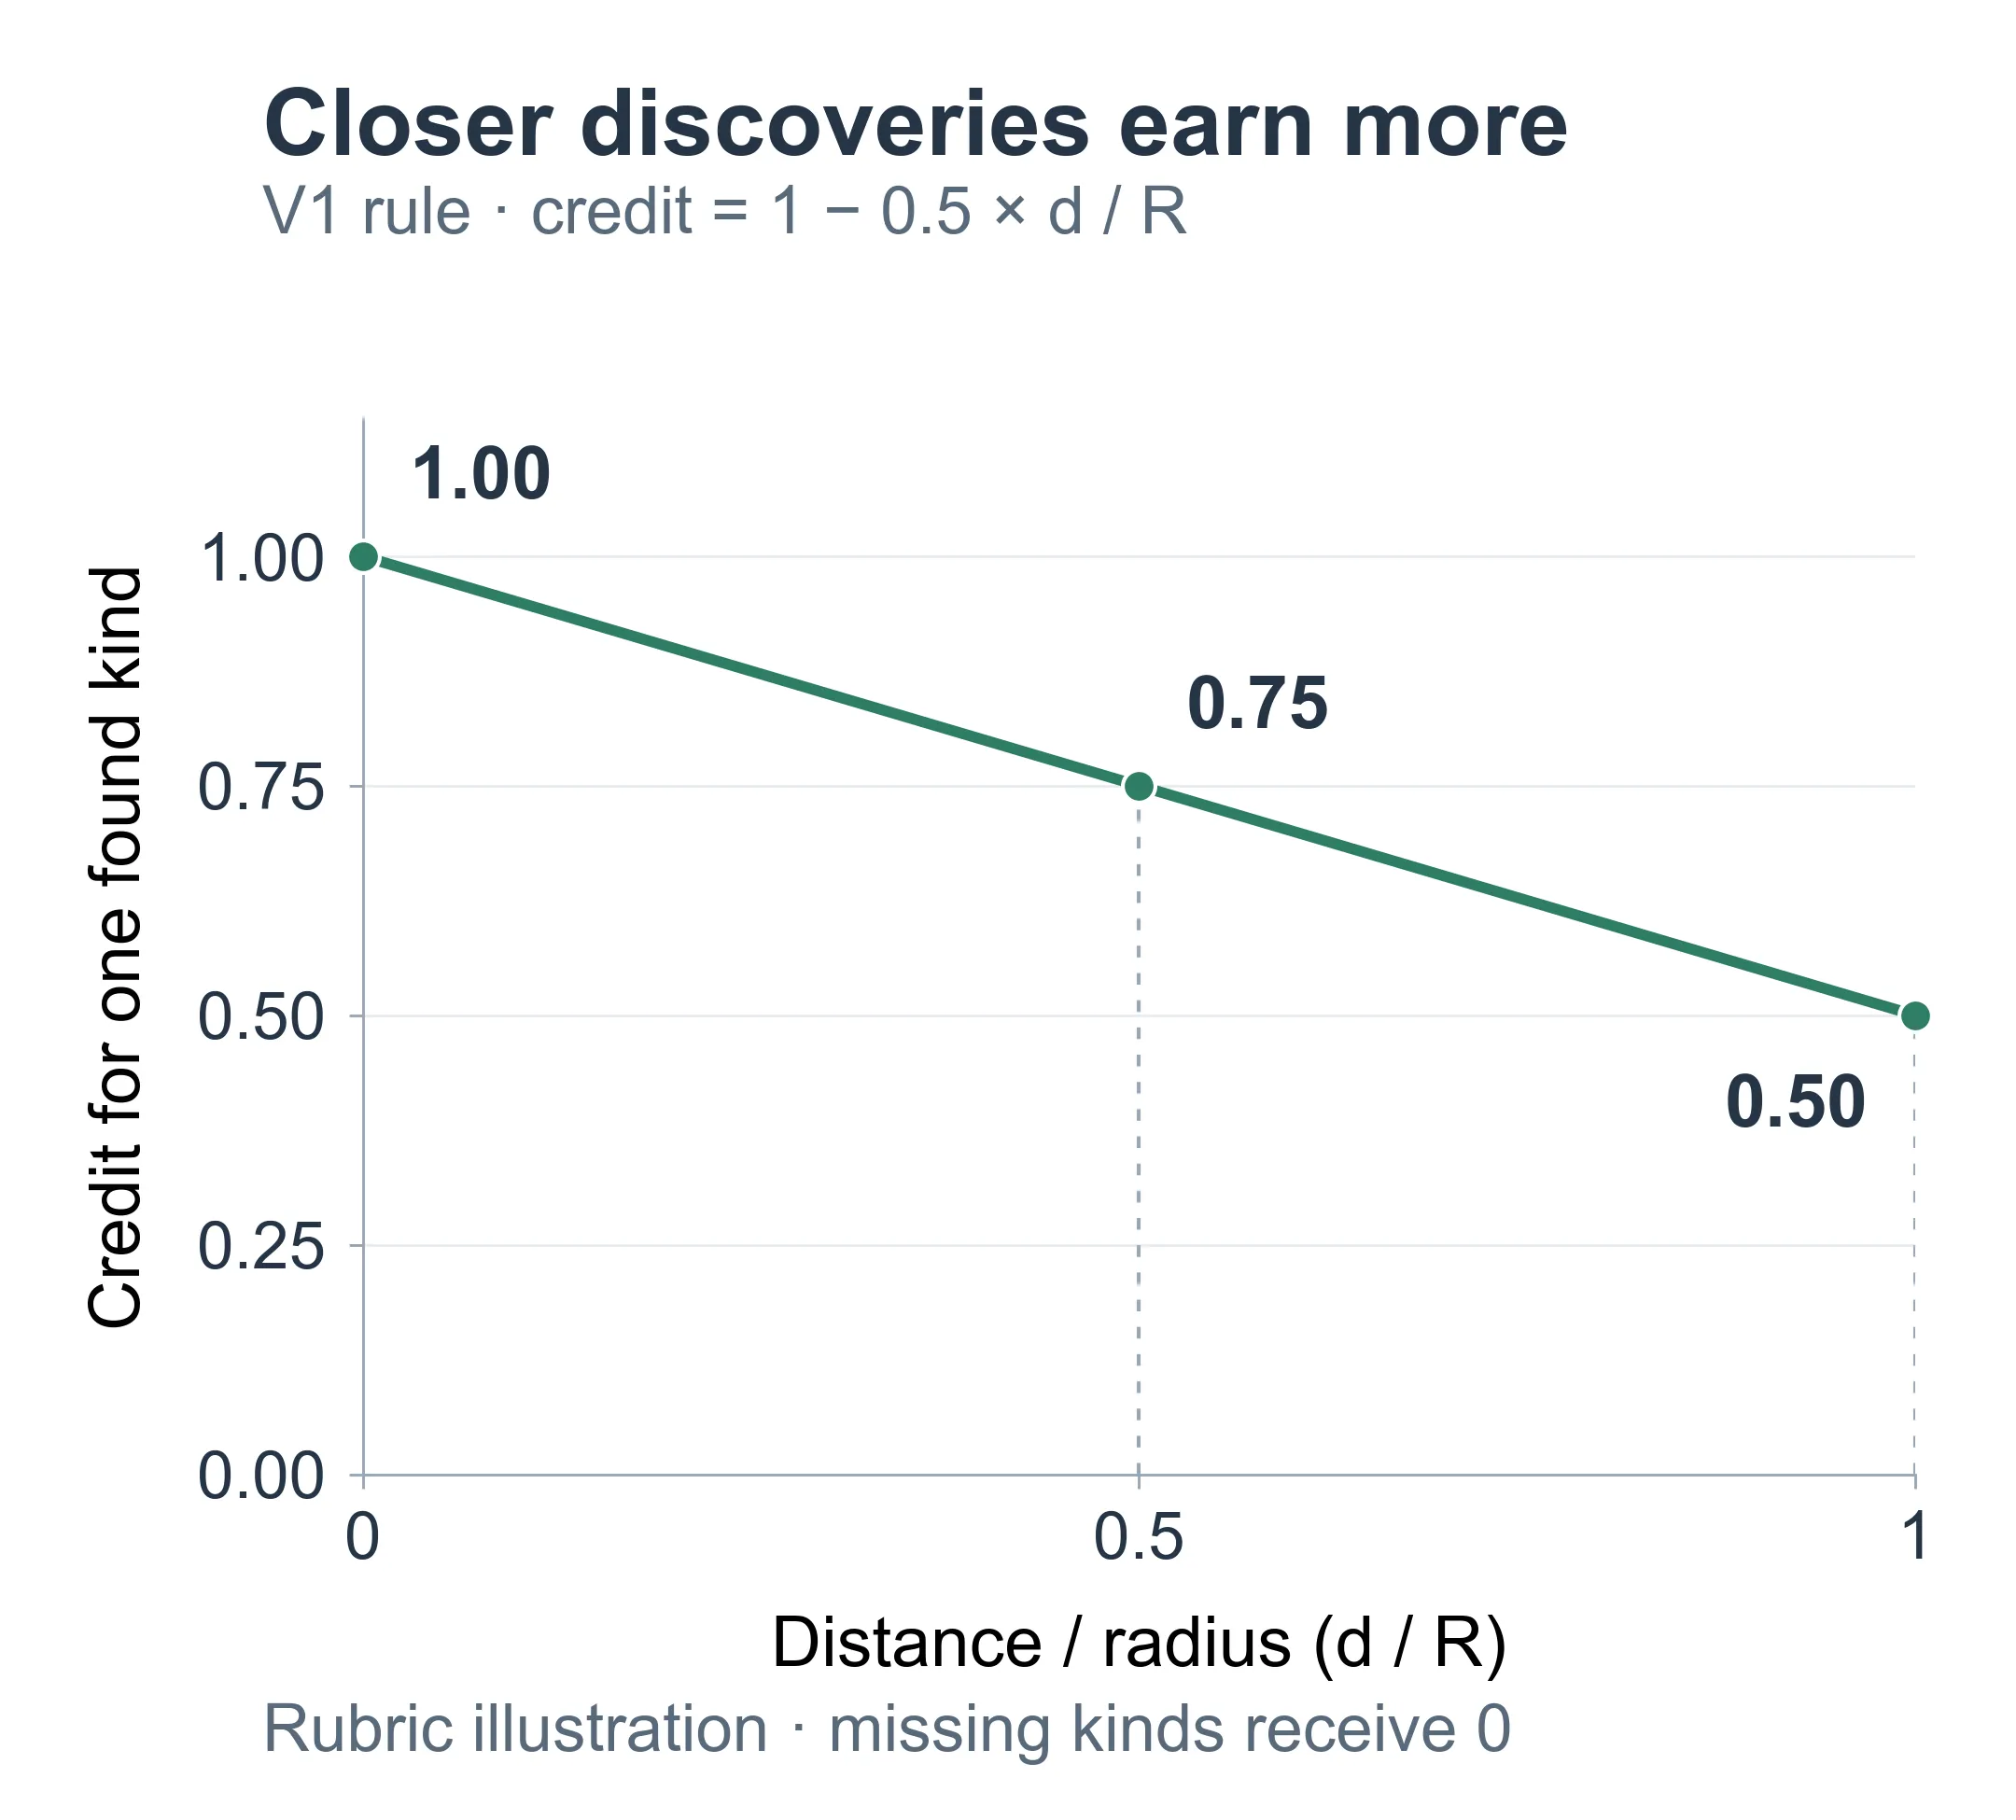
評価基準の説明図であり、ワールドの標本ではありません。横軸は距離を選んだ半径で割り、縦軸は見つかった1つの基準の得点を示します。
最終計算では2つのカテゴリに同じ重みを与えます。
index = round(100 × (0.5 × biome average + 0.5 × structure average))
Java 26.3とBedrock 26.50のプロファイルでは、バイオームは35群で最大50点、構造物は17種類で最大50点を得られます。丸める前の指数への寄与は、1群が約50 / 35 = 1.43点、1種類が約50 / 17 = 2.94点です。どちらも距離で減ります。52基準すべてを等しい重みで1つの一覧にするとバイオームの影響が強くなるため、2つに分けて総重みを等しくしています。
以下は計算を示す仮の例であり、特定のシードの結果ではありません。
| カテゴリ | 対象の各基準の得点 | 平均 |
|---|---|---|
| バイオーム4群 | 1, 0.75, 0.5, 0 | 0.5625 |
| 構造物3種類 | 0.75, 0, 0 | 0.25 |
指数はround(100 × (0.5 × 0.5625 + 0.5 × 0.25)) = 41です。
群分け、カテゴリの等しい重み、境界で半分の得点という設定は、リビジョン1の選択です。プレイヤーが何を楽しいと感じるかという調査に合わせた設定ではありません。参照標本で出現が少ないからといって、バイオーム群や構造物の種類が自動で加点されることもありません。
予測が見つからずに完了した検索と、未完了の検索も区別します。構造物の検索範囲が限られ、ある種類の結果が不明なら、総合スコアは表示しません。不明な範囲は、発見としても、見つからなかった種類としても計上しません。
計算コードを共有し、バージョン別の基準を確認する
Minecraftのバージョン対応には、生成モデルの選択と、適用する計算基準の選択という2つの別の判断が必要です。
計算ツールは、標本抽出と得点計算の中核を共有しています。JavaとBedrockはサイトの既存のエディション別生成モデルを使います。明示的な登録情報で、対応する各地形生成バージョンと計算基準を関連付けます。規則が同じならバージョン間で基準を共有でき、計算エンジンのコピーを別々に持つ必要はありません。
基準は、対象となる構造物の種類、標本の間隔、洞窟の深さ、カテゴリの重み、距離による得点を定めます。バイオームのカタログは選択したモデルバージョンから取得し、レビュー済みの群の定義と照合します。不明なバイオーム名や未対応のバージョンがあれば、基準をレビューするまで計算を止めます。
例えば、現在のJava 1.18.2プロファイルの対象はバイオーム29群と構造物13種類です。Java 26.3は35群と17種類です。これは計算の分母であり、個々のシードにある数ではありません。古いプロファイルが、そのバージョンのモデルと基準にないカテゴリで減点されることはありません。
各結果はエディション、地形生成バージョン、計算リビジョンを明記します。群分けや重みを変える場合は、評価基準を新しいリビジョンにします。対応する参照標本も、その規則で再評価する必要があります。これにより、保存した結果の意味を保ちながら計算を保守できます。
結果を予測の集まりとして読む
結果には大きなスコア、距離による得点の棒、対象となる各バイオーム群と構造物の種類のアイコンが表示されます。薄いバイオームアイコンは「標本で見つからなかった」、薄い構造物アイコンは「予測が見つからなかった」を意味します。検索範囲が不明な場合は別の状態で表示し、除外した種類やバージョンの対象外の種類は採点一覧の外に置きます。
アイコンの一覧は、どの種類が含まれていたかを示します。寄与の棒は、可能な得点のうち距離で減点した後にどれだけ残ったかを示します。バイオーム群や構造物の種類の数が同じシードでも、最寄りの発見の距離が違えばスコアは変わります。比較するときは、総合値とともに件数と両カテゴリの寄与も見てください。
結果には、標本で調べた地表と洞窟のバイオーム数、両方の分母、最寄りの座標を残します。シードマップへのリンクで、それらの場所を確認できます。バイオームの座標は最寄りの標本点であり、正確な境界ではありません。スポーンと地表高度は推定です。
構造物の予測は、利用できる配置とバイオームの判定を使いますが、後の生成で構造物が作られない場合があります。Bedrockは互換モデルを使い、その精度はゲーム内で独立に検証していません。このサイトについてで、サイトの根拠を示すラベルを説明しています。
プロファイルの対象は標準的な生成です。独自のデータパック、「大きなバイオーム」、スーパーフラット、ワールド更新前に生成された既存チャンクは対象外です。評価する領域を生成したバージョンを使ってください。
指数が高くても、美しい景色、生き残りやすさ、価値の高い戦利品を保証しません。円のうち実際にどの割合を訪れるかも分かりません。多くのカテゴリが近くにあるシードより、多様性のスコアが低い島のワールドが好みに合う場合もあります。
気になるシードを計算する
計算ツールを開き、シードを入力してエディションと地形生成バージョンを選びます。Javaは文字列シードも受け付け、数値シードに変換します。Bedrockは数値シードを使います。半径を選び、計算してください。
最終値を比較する前に、カテゴリ別の内訳を見てください。特定のバイオームや構造物が特に重要なら、シード検索でその条件を探し、計算ツールで周囲の多様性を評価できます。計算ツールのURLは入力設定を残すので、同じ条件に戻れます。
無作為なシードから分かること
符号付き64ビットの数値シード1,024個を疑似乱数で選び、各シードをJava 26.3とBedrock 26.50の両方で評価しました。両集団は、標準的なオーバーワールド生成、半径2,048ブロック、計算リビジョン1を使い、対象はバイオーム35群と構造物17種類です。同じシード番号を使う対応のある研究で、各エディションの分布は別々に要約します。モデル評価2,048件はすべて完了し、失敗や未完了の結果の除外や差し替えはありません。
公開カタログから選別せず、数値シードを選びました。この研究はその設定での計算ツールを説明し、プレイヤーが残すと決めたワールドを測定するものではありません。
総合スコアの分布を読む
表は、丸めて表示した指数を示します。P10からP90は標本の10パーセンタイル値から90パーセンタイル値です。整数で同点になるため、その間にある割合は80%を超えることがあります。この範囲は信頼区間ではありません。
| 生成モデル | 平均指数 | 中央値 | P10からP90 | 標本で見つかった群数の中央値 | 予測した種類数の中央値 |
|---|---|---|---|---|---|
| Java 26.3 | 62.4 | 62 | 56から68 | 35群中27群 | 17種類中13種類 |
| Bedrock 26.50 | 62.8 | 63 | 57から69 | 35群中27群 | 17種類中13種類 |
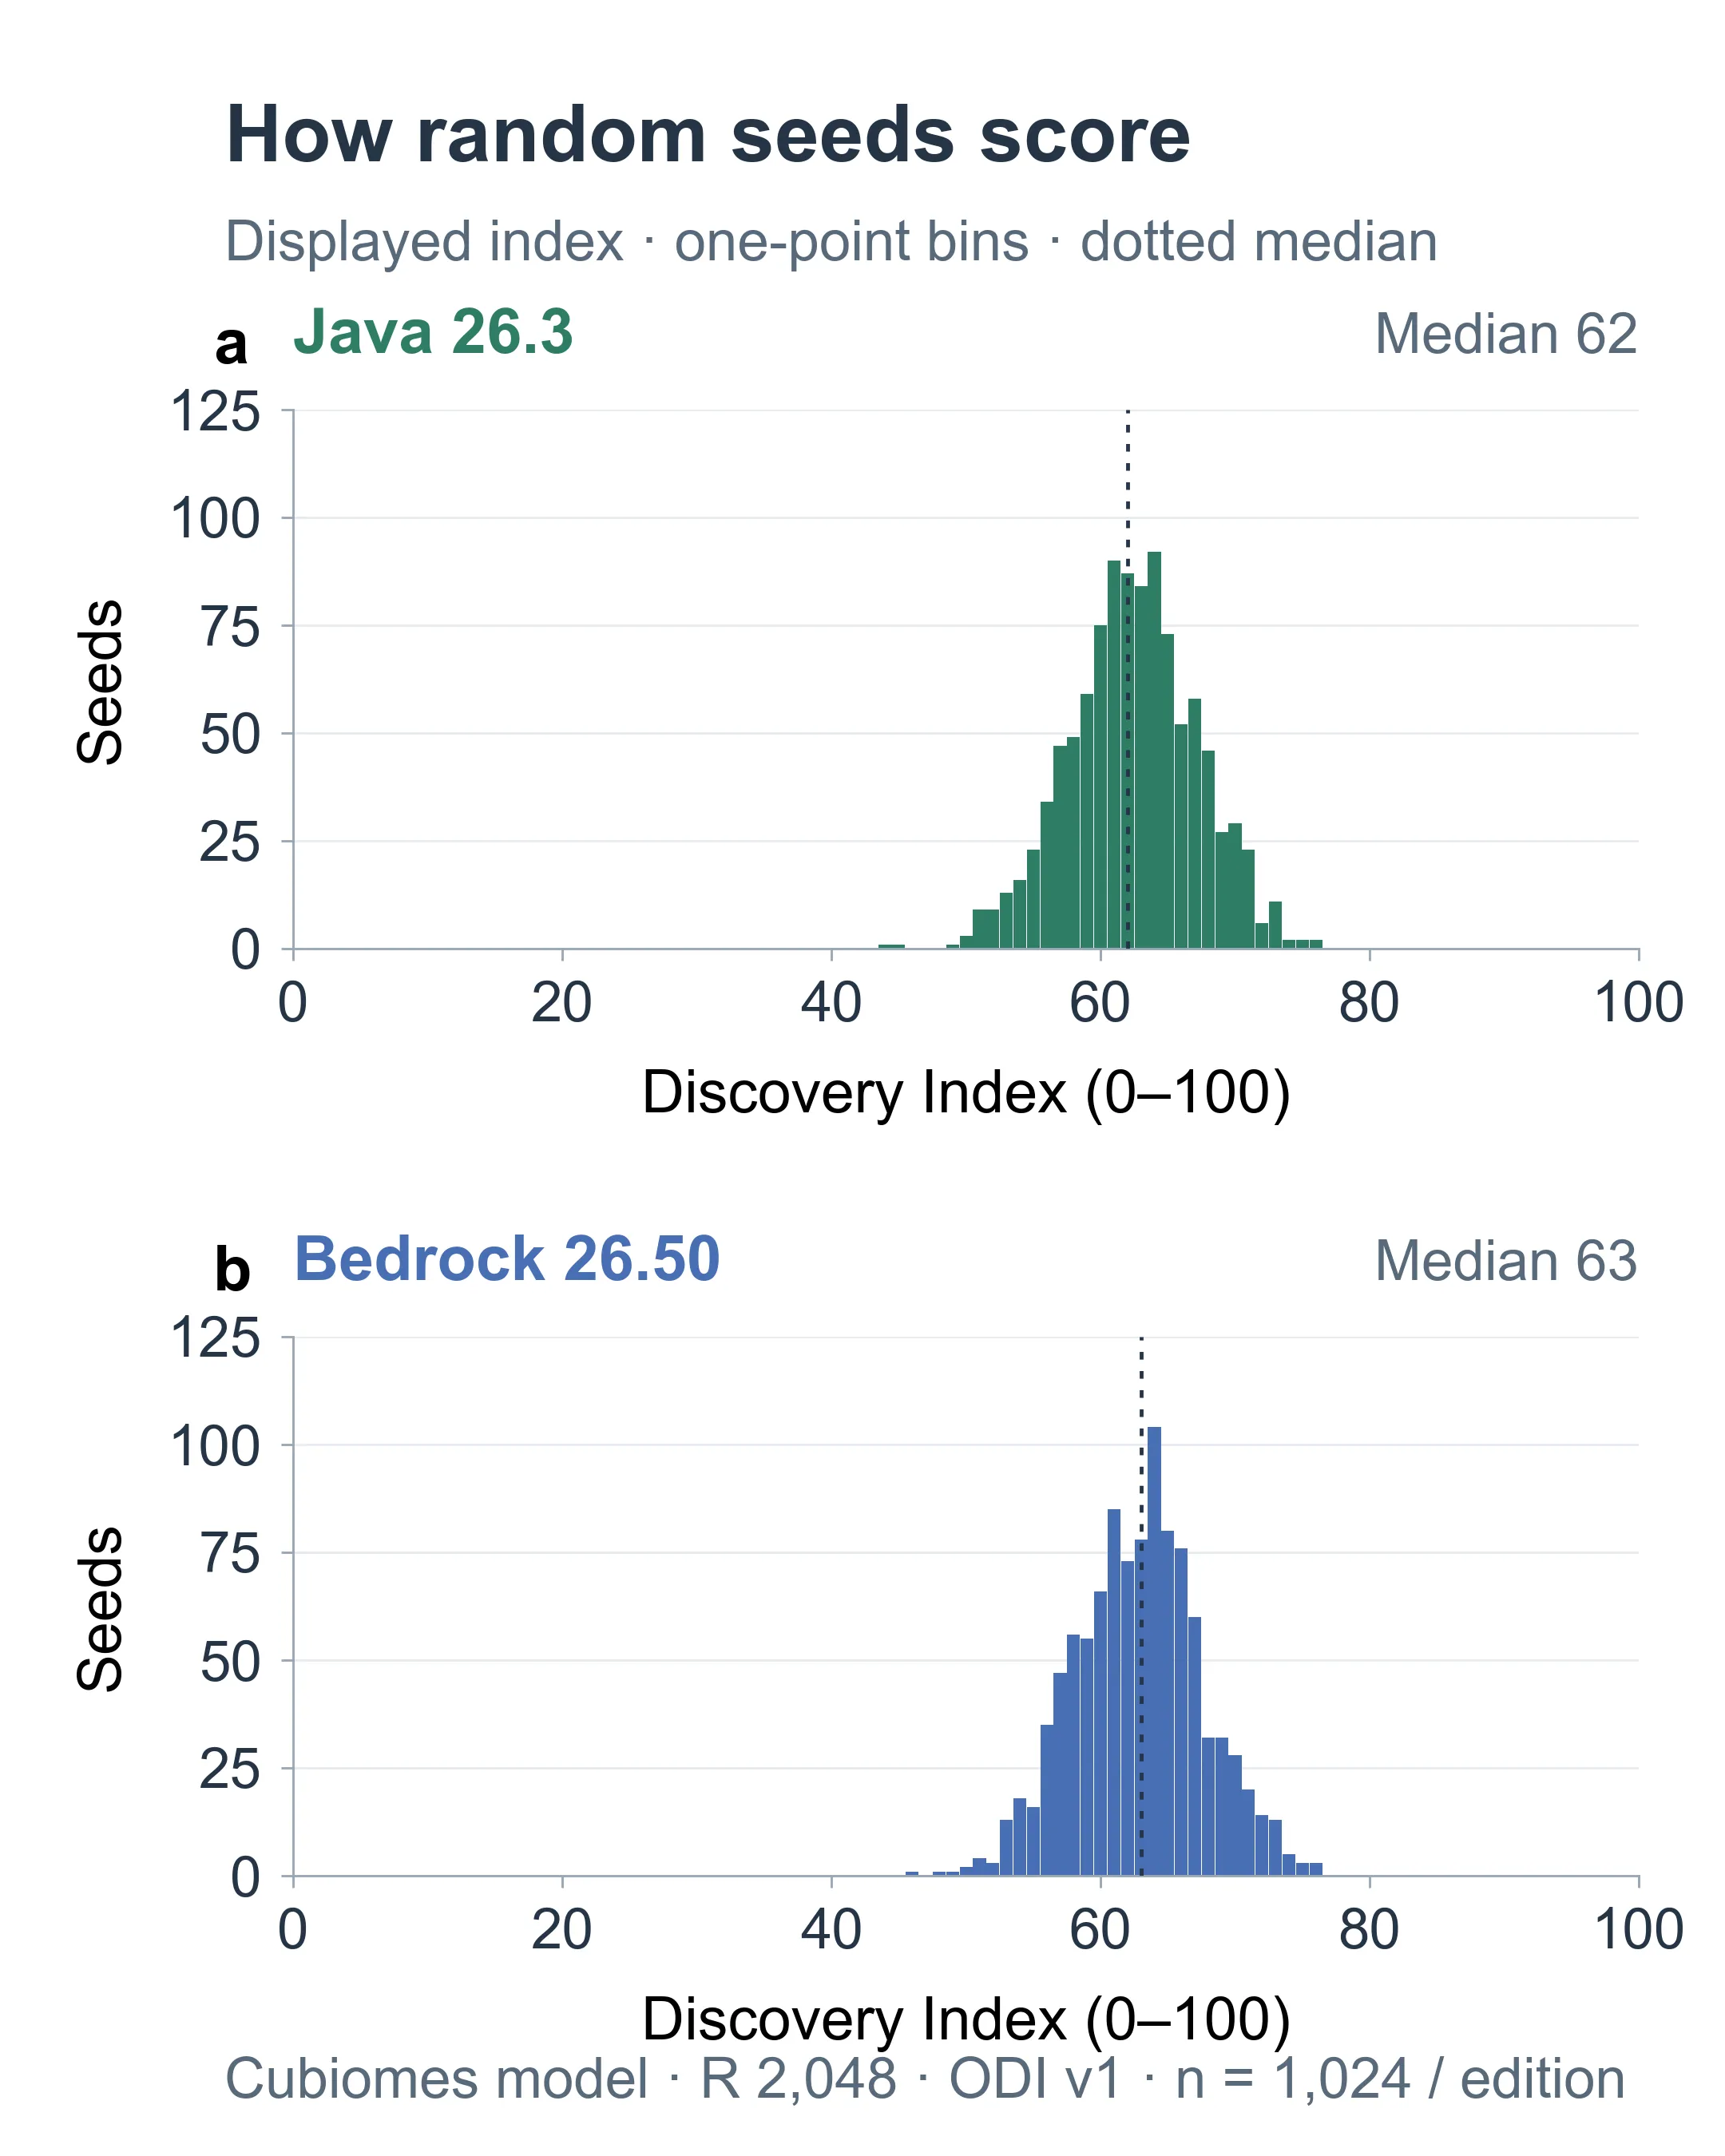
計算ツールのモデル予測。細い棒は、1つの表示指数に該当するシード数を数えます。両パネルは0から100の全スコア目盛と、同じシード数の目盛を使います。
横軸は表示指数、縦軸はその指数を得た標本シード数です。高い棒は、その集団でよくあるスコアを示します。Javaは44から76、Bedrockは46から76に分布しています。中央値は、観測した各分布の中央付近で、理論的な上限100よりかなり低い値です。
このため、スコア69は、設定の合うどちらの参照標本でも中央値より上です。バイオームと構造物の内訳で、どの発見が得点を生んだか分かります。
発見の種類数と距離による得点を区別する
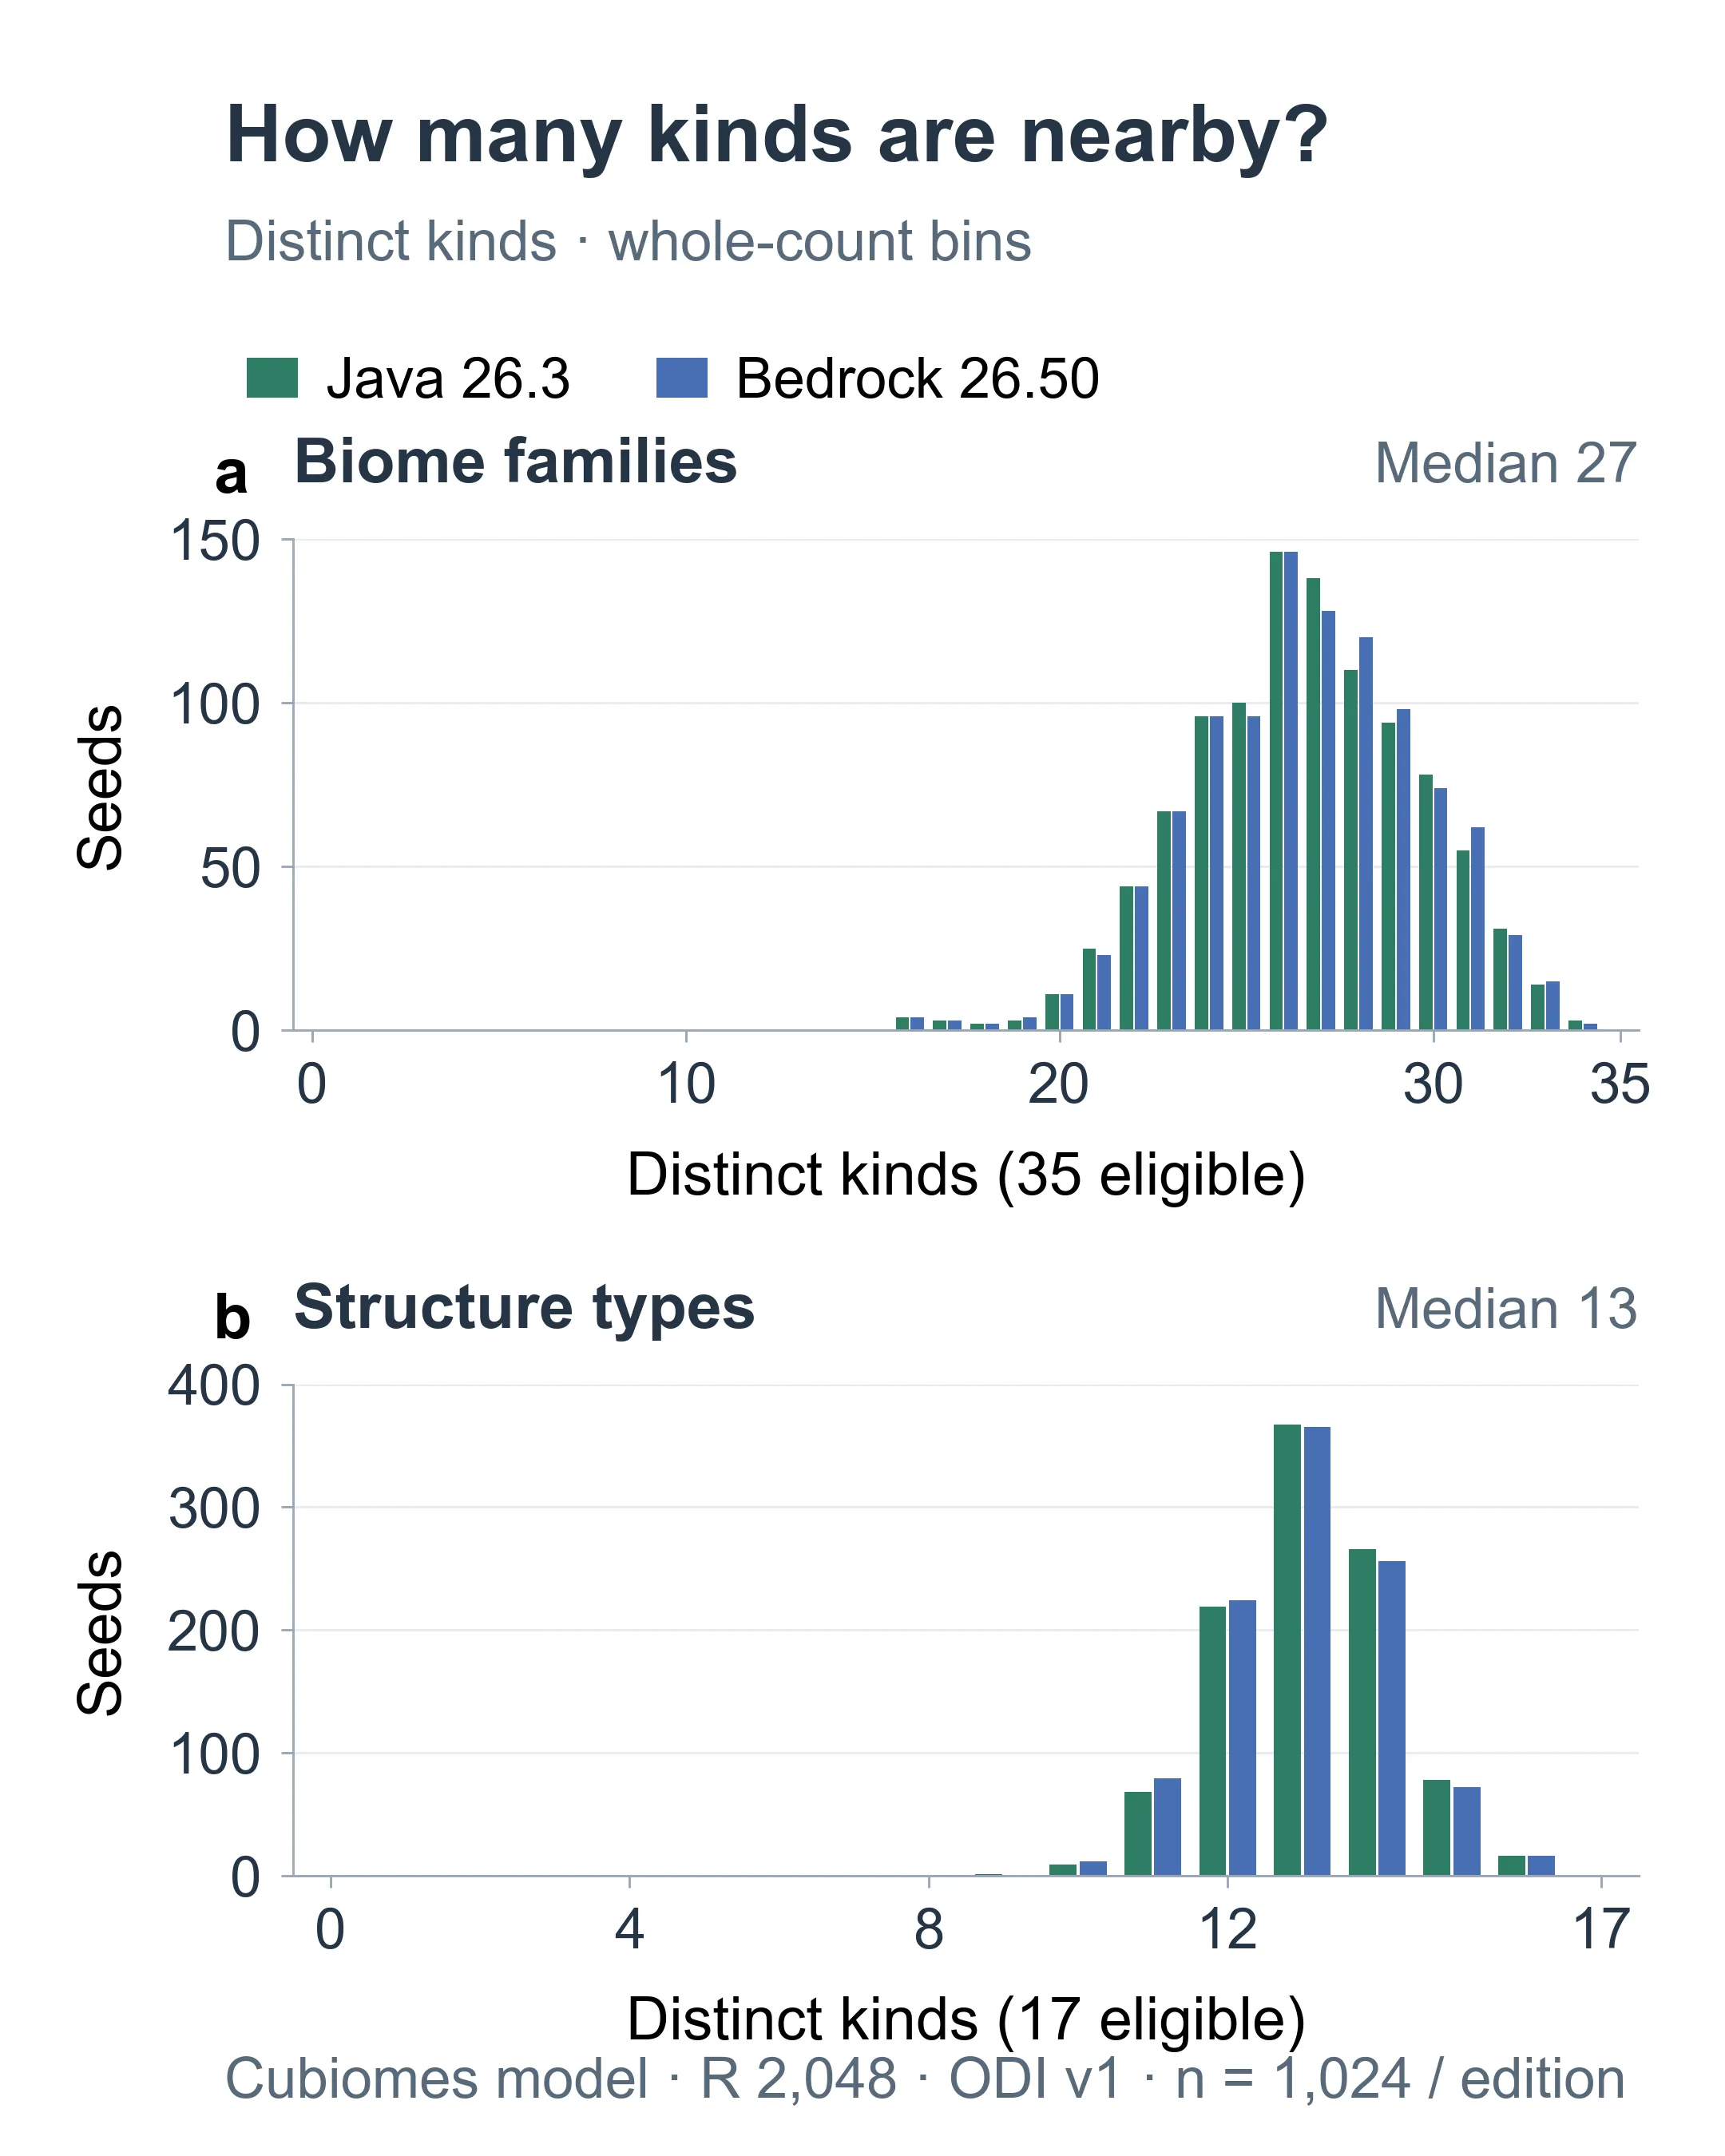
各棒は、特定の群数または構造物の種類数が含まれるモデルのシードを数えます。地表と洞窟の群を含みます。この数に距離による重みはありません。
上のパネルは、円内の標本で何種類のバイオーム群が見つかったか、下は円内に何種類の構造物が予測されたかを示します。各整数の群で緑と青の棒は別々に読んでください。足すと、参照設定を区別すべき2つのエディションを混ぜてしまいます。
両エディションの中央値は、標本バイオーム27群、予測構造物13種類です。群数は両集団とも16から34に分布します。構造物の種類数はJavaで9から16、Bedrockで10から16です。このモデル設定で、35群すべてや17種類すべてが含まれた標本ワールドはありませんでした。
種類数は、最寄りの標本点や予測がどれだけ遠くても、何種類が含まれるかを示します。最終スコアでは近さも評価します。したがって、27群や13種類という数を、100点満点のバイオームスコア27や構造物スコア13と読むべきではありません。
バイオームの半分を調べる
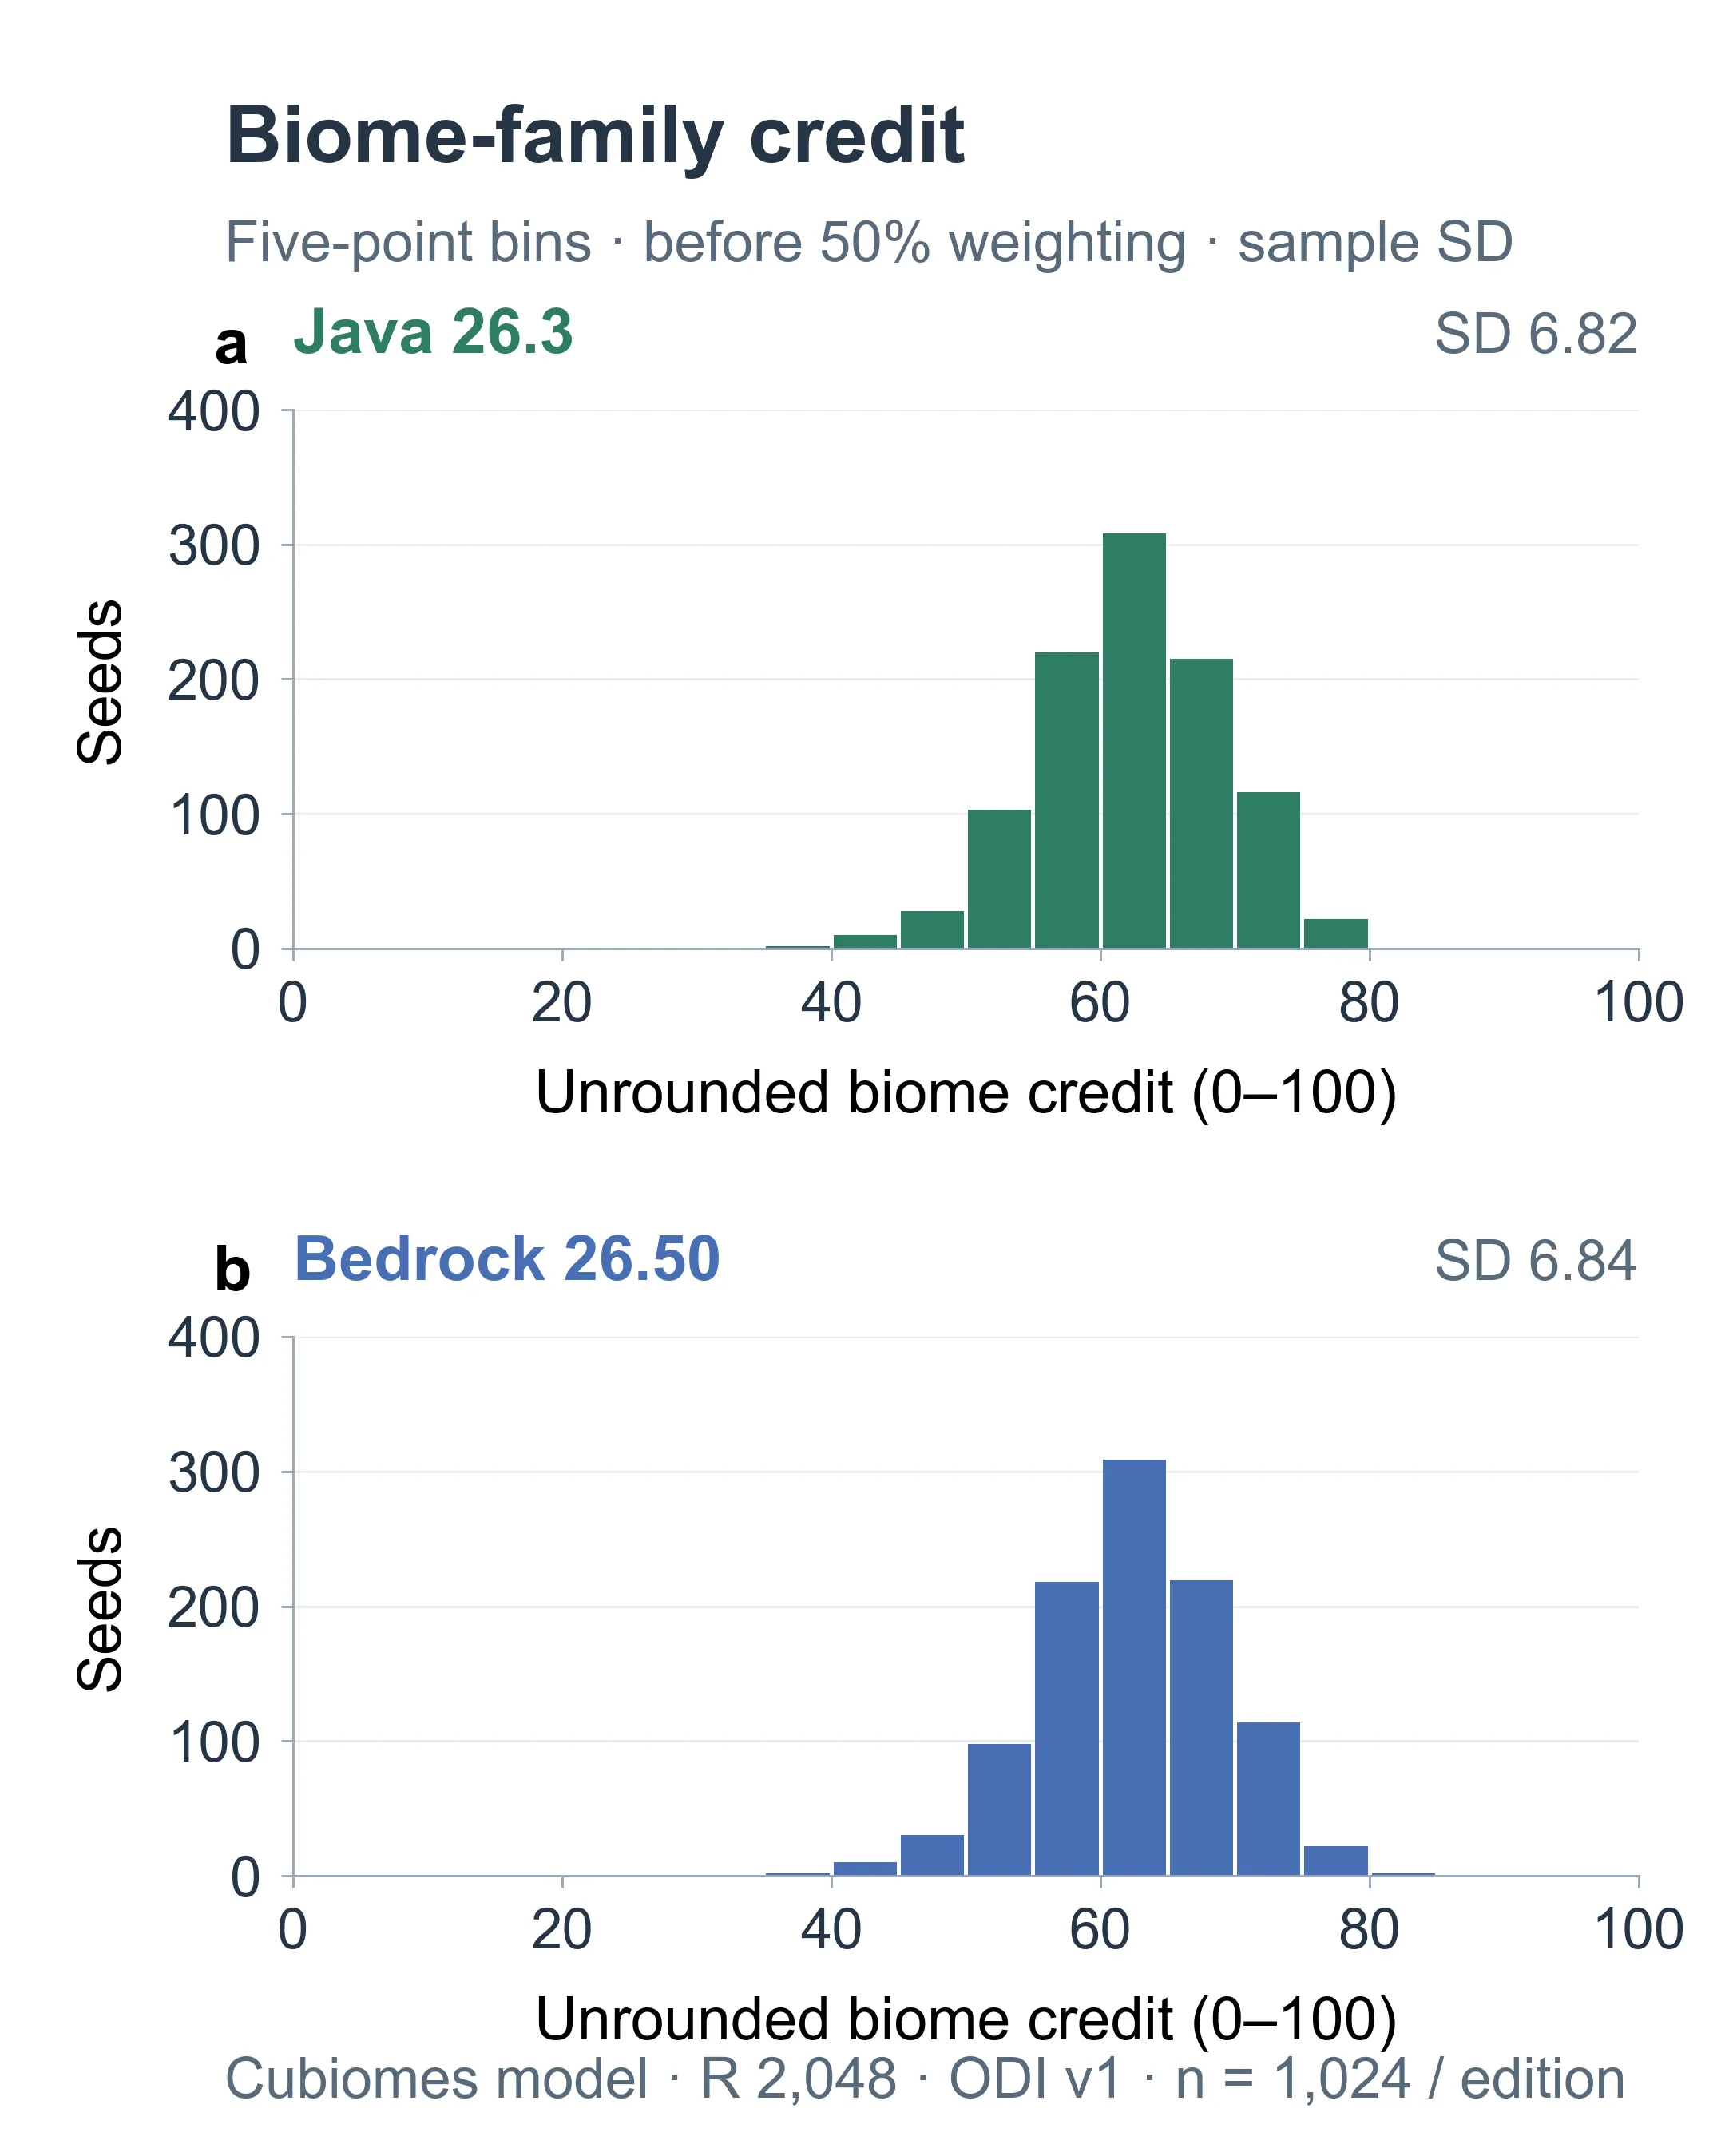
同じ対応のあるシード標本のモデル予測。横軸は、総合指数で半分の重みを掛ける前のバイオームスコアです。
各棒は5点幅の区間を表し、総合スコアのヒストグラムの1整数幅の棒とは異なります。バイオーム成分70は、最終的な丸め前の指数に35点寄与します。対象の群全体で平均得点が0.70という意味であり、70群あることや円の70%を探索したことではありません。
この標本のバイオーム分布は、下の構造物分布より広がっています。標本標準偏差はJavaで約6.82点、Bedrockで約6.84点です。NISTは、標準偏差を標本平均の周囲の広がりの尺度と説明しています。元の単位で表され、ここでは成分スコアの点です。シードのスコア間の変動を説明し、平均の誤差範囲ではありません。また、両バイオーム分布は、多重検定の補正後の診断で、正規分布形からの統計的に検出できるずれを示しました。
群数と距離が一緒に、この広がりを生みます。ヒストグラムから、あるシードにどの群が欠けるかは分かりません。その問いには、計算ツールのアイコンと座標の詳細が答えます。
構造物の半分を調べる
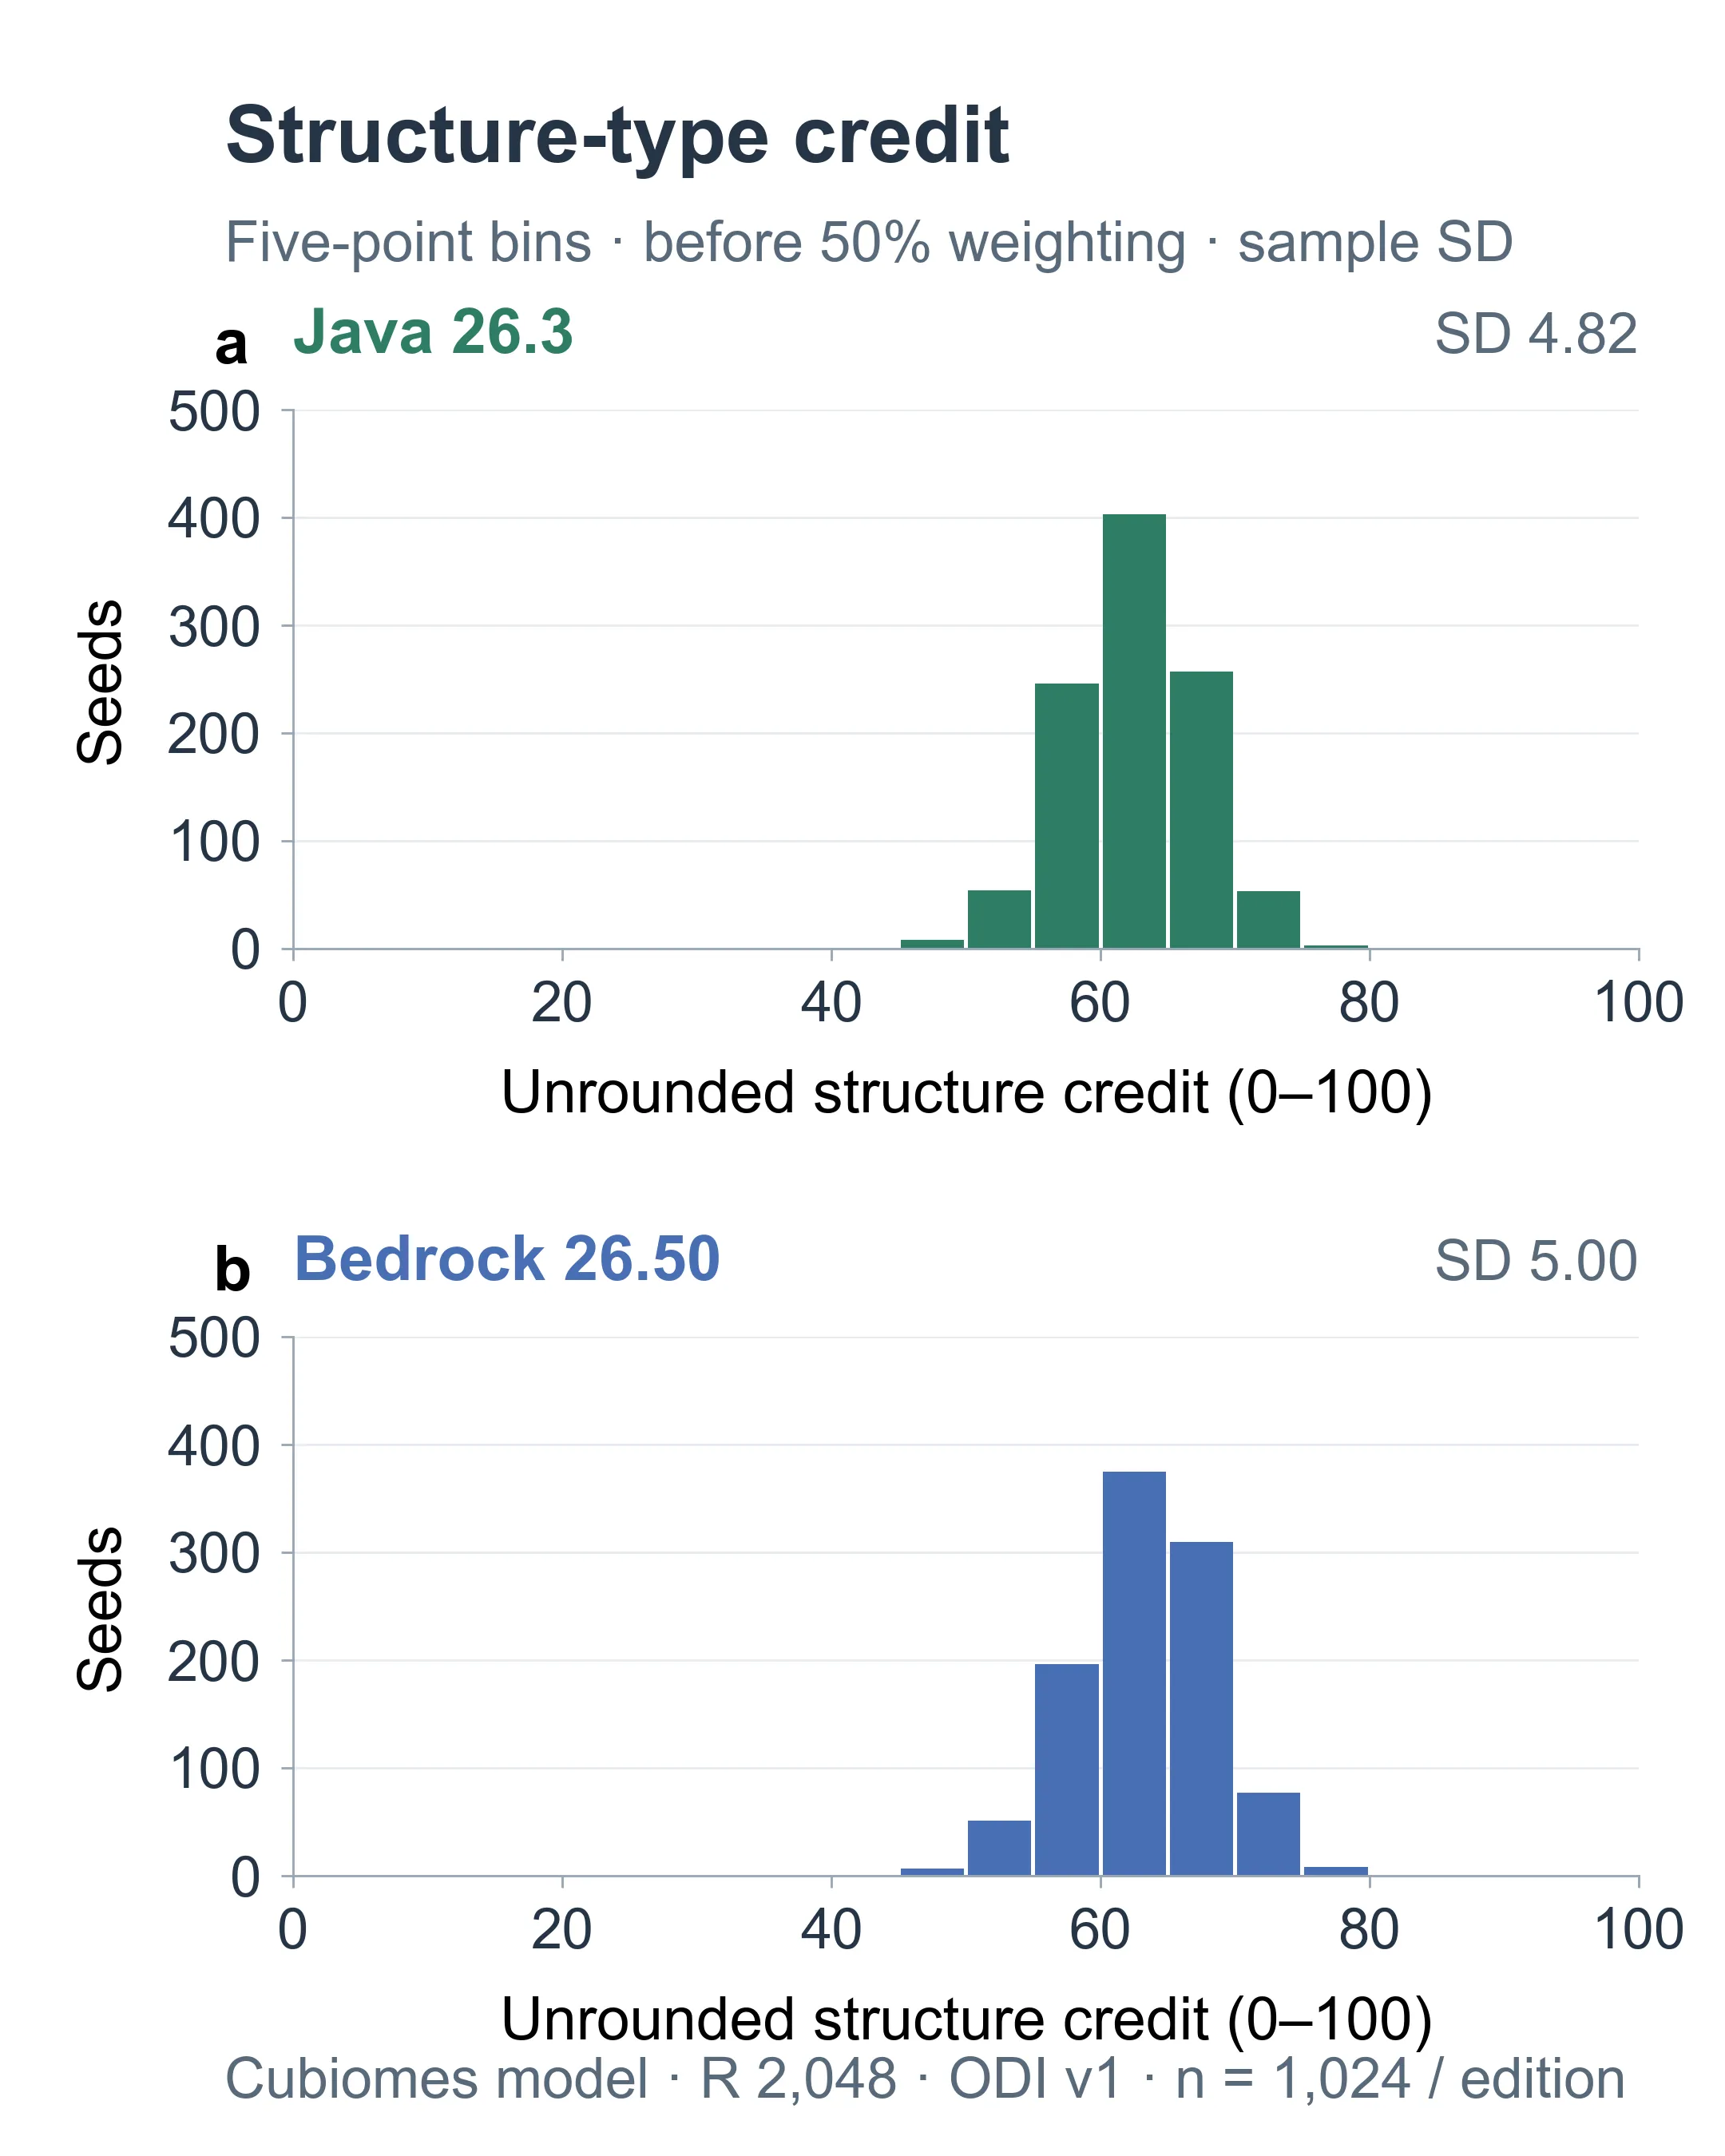
モデル化した構造物の各種類は、最寄りの予測で1回だけ寄与します。グラフはワールド内の全構造物を数えるものではありません。
軸と5点幅の区間はバイオーム成分の図と同じ意味なので、横方向の広がりを比較できます。縦のシード数の目盛は図ごとに異なります。標本標準偏差はJavaで約4.82点、Bedrockで約5.00点で、バイオーム成分より小さい値です。補正した正規性検定では、どちらの構造物成分の分布も棄却されませんでした。
構造物の半分は、含まれる種類数と水平距離を組み合わせます。同じ種類の村が増えても多様性の得点は増えず、近くに予測された要塞にも地下へ到達する作業に応じた追加調整はありません。これは評価基準の性質であり、そのワールドの難易度についての知見ではありません。
総合指数は、異なる2つの成分スコアを丸める前に平均します。その分布は各成分と異なることがあります。この集団では、バイオーム成分が正規性からずれる一方で、合計はおおむね釣り鐘型に見えます。合計自体を直接評価しており、2つのスコアを組み合わせるだけで全バージョンや全半径についての一般則が得られるわけではありません。
正規Q-Qプロットで両端を確認する
ヒストグラムは多数のスコアがある場所を見るのに役立ちますが、区間にまとめることで形の小さな違いが隠れる場合があります。正規Q-Qプロットは、丸める前のスコアを順に並べ、各集団で観測した平均と標本標準偏差を使った正規分布で期待される値と比較します。NISTの正規確率プロットの説明では、基準の直線からのずれが正規分布形との違いを示すと解説しています。
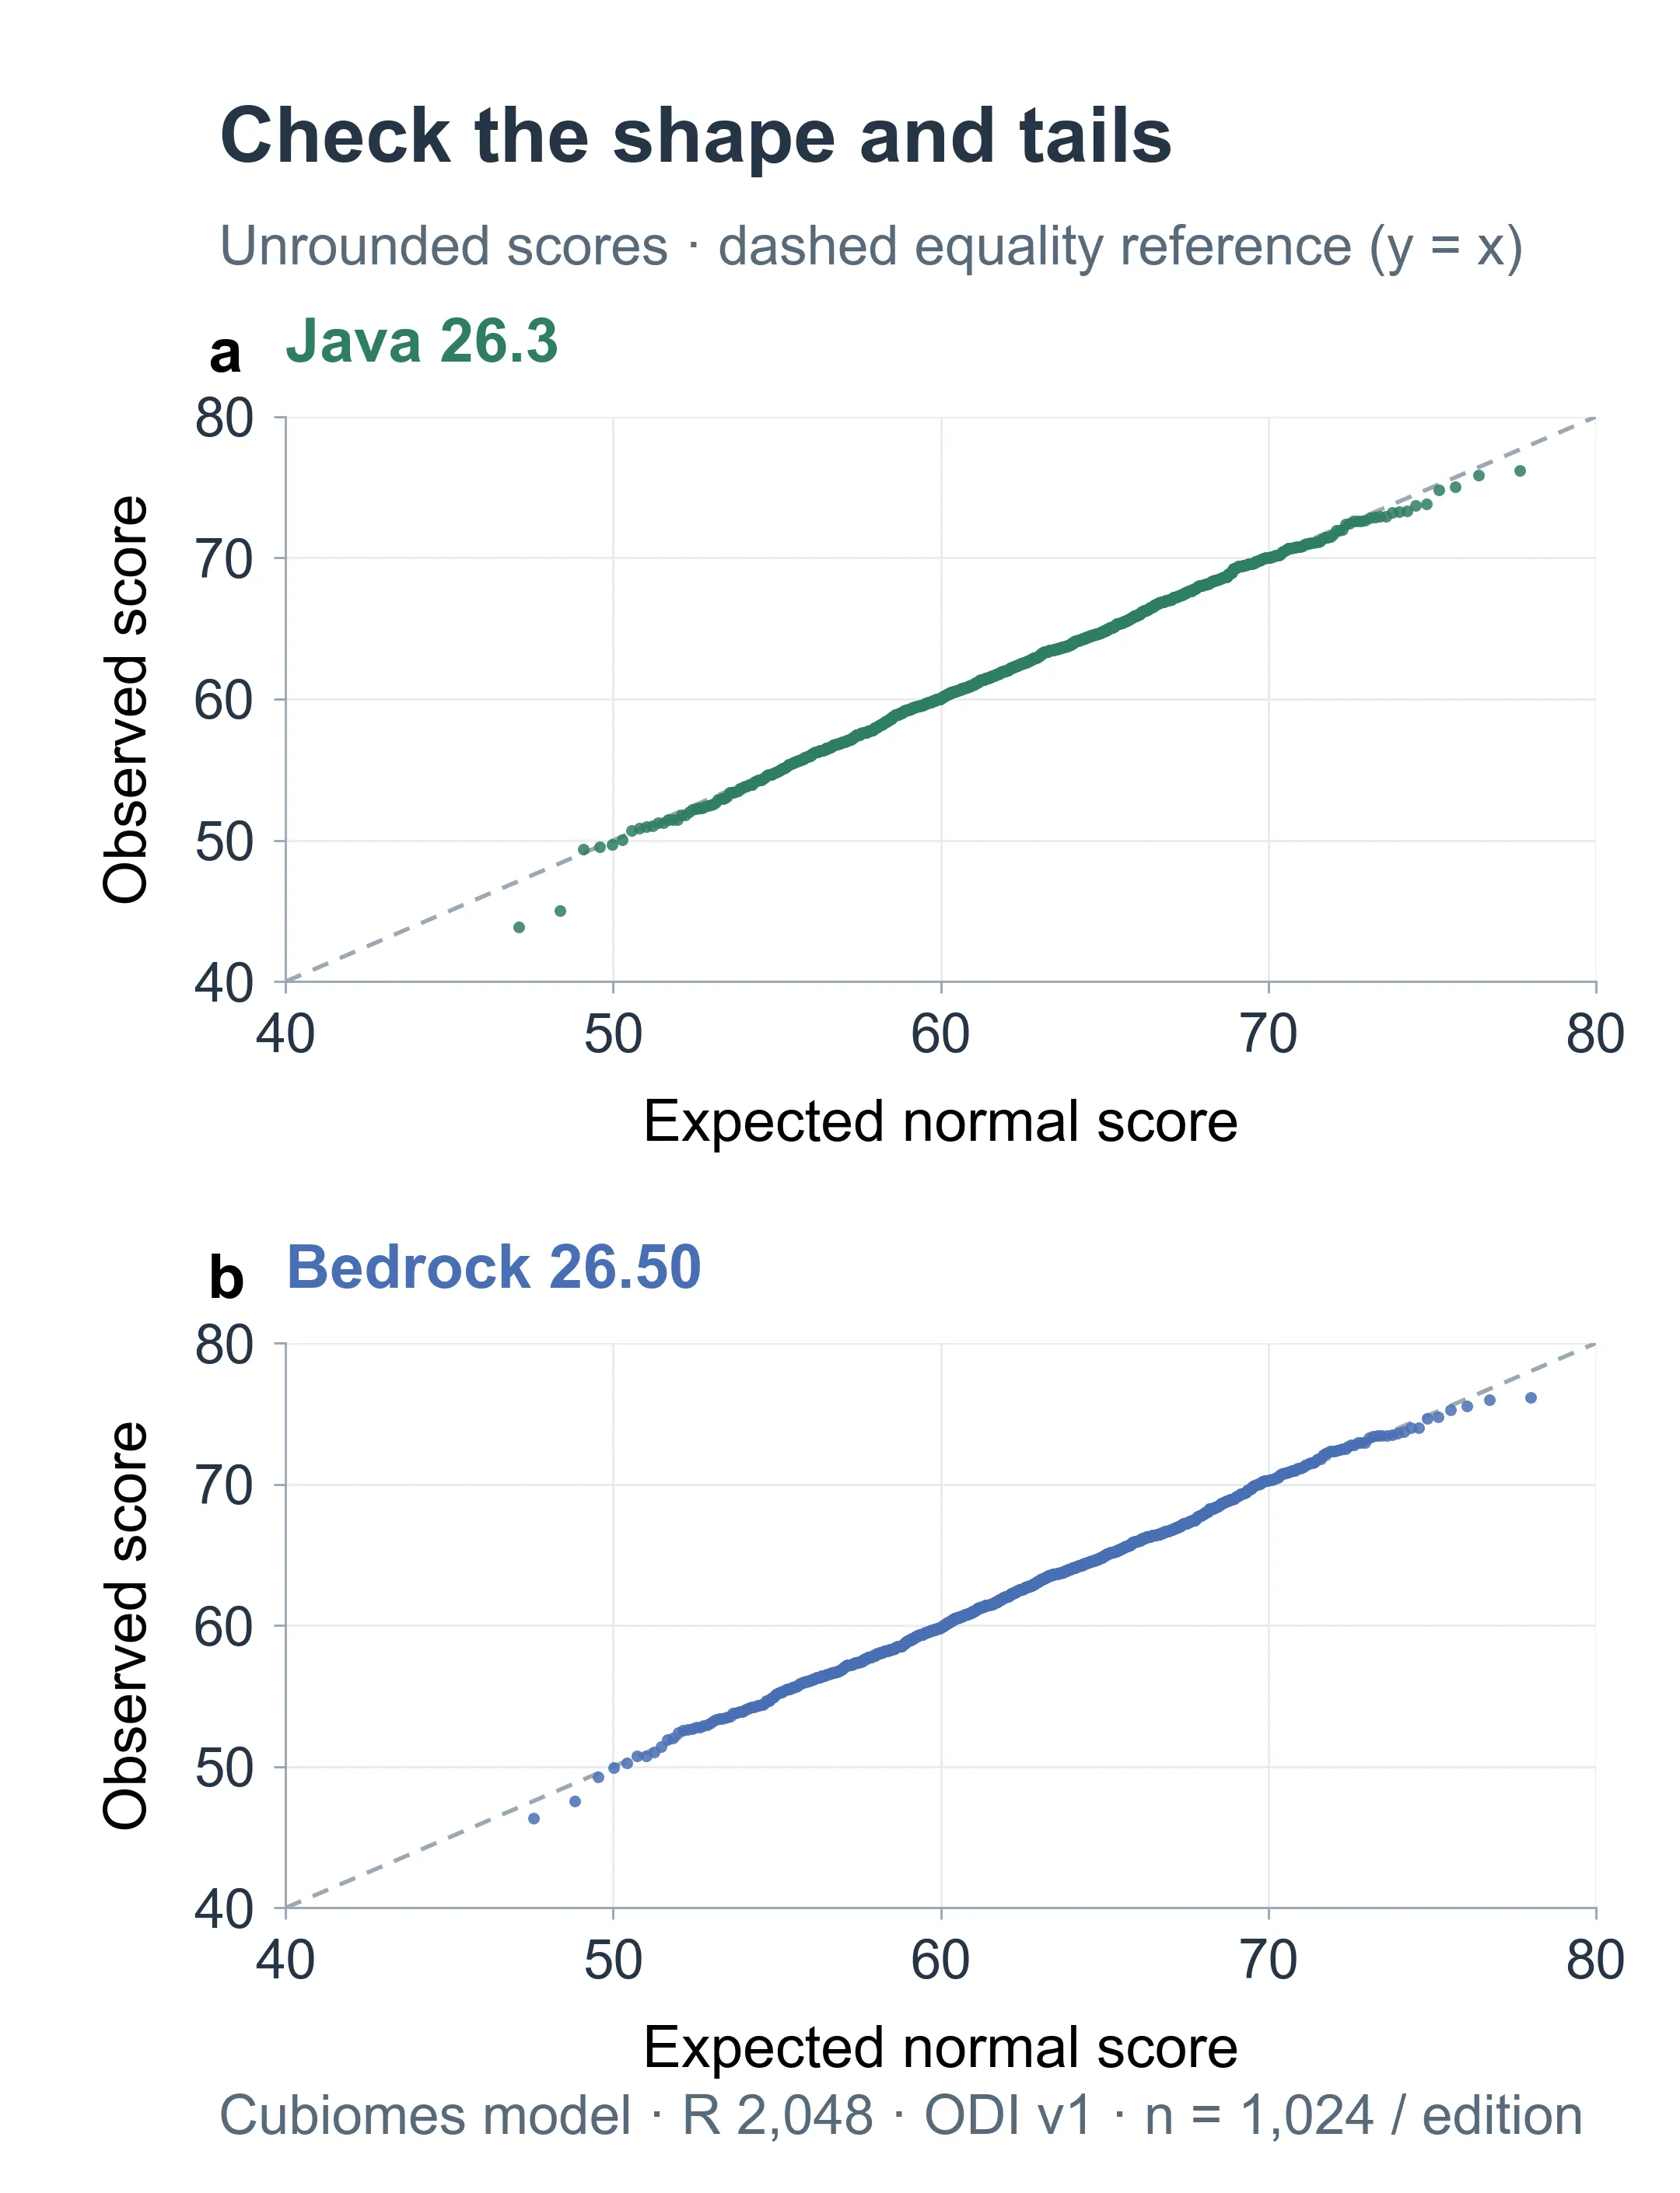
各パネルは丸める前の総合スコア1,024件すべてを含みます。期待される正規スコアは標本の平均と標準偏差を使い、灰色の対角線は期待値と観測値の一致を示します。信頼帯ではありません。
両軸の単位は指数の点です。対角線上の点は、正規分布との比較でその順位に期待される観測スコアを持ちます。上の点は観測値が高く、下の点は低いことを示します。最も左と右の点は、標本の低い側と高い側の裾です。
大部分の点は対角線に近く、両端でずれます。極端に低いスコアや高いスコアを調べるとき、この両端は重要です。中央でよく合っていても、観測範囲外の非常に希少なスコアを正規曲線で信頼して推定できるとは限りません。
正規性の確認で分かること
各エディションの丸め前の総合スコアと両成分に、SciPyで説明されているShapiro-Wilk検定を適用しました。丸める前の値を使うことで、表示の整数の同点を連続測定値として扱うことを避けます。しきい値は0.05とし、6検定全体にHolm補正を適用しました。
| 検定した分布 | Java 26.3の補正済みp値 | Bedrock 26.50の補正済みp値 | 0.05での結果 |
|---|---|---|---|
| 総合指数 | 0.667 | 0.667 | ずれを検出せず |
| バイオーム成分 | 0.0059 | 0.0059 | ずれを検出 |
| 構造物成分 | 0.231 | 0.472 | ずれを検出せず |
総合スコアの検定の未補正p値は、Javaが0.334、Bedrockが0.660でした。棄却されなかったことは、これらの特定の標本がおおむね釣り鐘型に見えることと整合します。正規性を証明したり、生成モデルを認証したり、ワールドが楽しい確率を示したりするものではありません。
スコアの範囲は0から100のままです。シード比較には実際に観測した頻度を使い、当てはめた正規曲線でスコアを変換しません。検定と図はこの2集団を説明するもので、他のエディション、バージョン、半径、将来の評価基準の改訂は別途評価が必要です。
完全な統計要約と標本のモデル結果全件に、図の元となる測定値を残しています。5つの分布図は同じ対応のある標本を使い、距離得点の図は式を説明しています。
個別のスコアを位置付ける
例のJava 26.3のシード12345では、計算ツールはスコア69、35群中30群の標本バイオーム、17種類中14種類の構造物を予測します。この網羅数は距離の減点前で約84点に相当し、50 × 30 / 35 + 50 × 14 / 17 ≈ 84です。最寄りの距離によって、表示の69まで減ります。設定の合う参照標本では、922件がそれより低く、27件が同点、75件が高いスコアでした。
同点も重要です。表示の69はすべて丸めた結果で、バイオームと構造物の得点の異なる組み合わせで生じます。表示スコアが低い、等しい、高い件数を正確に数えることで同点を保ちます。同点の全シードに同じ推定正規パーセンタイルを説明なく割り当てるより、比較も直接理解できます。
エディション、バージョン、半径、評価基準、生成モデルが正確に一致する場合、計算ツールは観測ヒストグラム、標本中央値、P10からP90の範囲、自分のスコア未満・同点・超過の件数を表示します。他の設定でも発見の内訳は得られますが、現在は対応する参照標本がありません。
遭遇頻度にも独自の分母が必要です。この半径のJava 26.3集団では、モデルは1,024シード中294個(28.7%)でキノコ島の群を標本から見つけ、158個(15.4%)で森の洋館を予測しました。推定スポーンの円内のどこかでの出現であり、そのバイオームにスポーンする確率や世界全体に占める面積ではありません。
総合スコアのヒストグラムは、この標本で計算ツールが各合計値をどのくらい生成したかを示します。希少性で重み付けする基準なら、特定の群や構造物の種類の遭遇頻度という別の問いになります。リビジョン1は各カテゴリ内の重みを等しく保ち、この測定を希少性ボーナスに変えていません。そのような変更には、エディション、地形生成バージョン、半径、標本抽出規則に合う遭遇頻度の基準値と、新しくレビューした評価基準のリビジョンが必要です。
これはモデル予測の参照標本です。母集団での希少性パーセンタイル、遊ばれたワールドの標本、プレイヤーの移動距離の測定ではありません。スコア80は、全シードの80%より多様だという意味ではありません。計算ツールで探索予定の範囲のモデル上の発見を比べ、シードマップで自分に重要な場所を確認してください。