seedlookout
Ein Erlebnisindex für Minecraft-Seeds kann eine praktische Frage beantworten: Wie viele unterschiedliche Landschaften und Arten von Zielen bietet dieser Seed innerhalb des Bereichs, den ich erkunden möchte?
Unser Seed-Erlebnisrechner nennt diesen Wert Oberwelt-Entdeckungsindex. Er fasst erfasste Biomfamilien und vorhergesagte Bauwerkstypen zu einem Wert von 0 bis 100 zusammen, wobei Entdeckungen näher am geschätzten Spawn mehr beitragen. Du wählst Edition, Generierungsversion und Radius. Der Wert beschreibt modellierte Vielfalt; deine Vorlieben entscheiden weiterhin, ob du dort spielen möchtest.
Wir untersuchten jeweils 1.024 pseudozufällige Seeds in zwei Generierungsmodellen. Bei einem Radius von 2.048 Blöcken lag der Median des angezeigten Index bei 62 für Java 26.3 und bei 63 für Bedrock 26.50. Die mathematische Obergrenze des Bewertungsschemas von 100 ist eine andere Größe als die Mitte dieser Stichprobe. Die folgenden Diagramme zeigen, wie du einen Wert einordnen kannst, ohne daraus eine Spaßbewertung zu machen.
Einen Erkundungsradius wählen
Der Rechner bietet Radien von 512, 1.024, 2.048 und 4.096 Blöcken. Jeder bezeichnet einen Kreis, der horizontal vom geschätzten Welt-Spawn aus gemessen wird. Ein Radius von 2.048 Blöcken reicht in jede Richtung so weit; er bedeutet nicht, dass ein Fußweg von 2.048 Blöcken alles darin besucht.
Wir verwenden 2.048 Blöcke als Standard, weil das Werkzeug einen Ausgangsbereich braucht. Wir haben diese Wahl nicht anhand einer repräsentativen Messung der Erkundungsentfernungen von Minecraft-Spielern kalibriert. Mojangs Erkundungsleitfaden beschreibt kurze Ausflüge und größere Abenteuer, ohne einen durchschnittlichen Radius anzugeben.
Wähle den Radius, der zu deiner gewünschten Welt passt. Ein kleiner Kreis fragt nach Vielfalt in der Nähe. Ein größerer Kreis umfasst mehr mögliche Ziele und gibt derselben nahen Entdeckung mehr Entfernungsbeitrag. Vergleiche zwei Seeds mit demselben Radius, damit die Fragestellung gleich bleibt.
Der Radius verändert damit zwei Dinge: den durchsuchten Bereich und den Beitrag bei einer bestimmten Entfernung. Eine Vorhersage 1.024 Blöcke vom Spawn entfernt erhält bei einem Radius von 2.048 einen Beitrag von 0,75, bei einem Radius von 4.096 dagegen 0,875. Bei größerem Radius kann der Wert schon steigen, bevor ein weiterer Typ gefunden wird. Dieser Anstieg beantwortet eine weiter gefasste Erkundungsfrage; er belegt nicht, dass der Seed selbst besser geworden ist.
Unterschiedliche Erlebnisse zählen
Rohe Biomzählungen können eng verwandten Landschaften mehrere Punkte geben. Der Rechner zeigt diese rohen IDs weiterhin an, fasst verwandte Varianten für die Bewertung aber zusammen. Ebene und Sonnenblumenebene teilen eine Familie. Ozean und Tiefsee bilden eine weitere. Der Blumenwald hat eine eigene Familie; auch die Höhlenfamilien zählen getrennt.
Diese Familien sind unsere redaktionellen Definitionen. Das Werkzeug bewertet nicht den Abschluss von Fortschritten. Jede berücksichtigte Familie hat innerhalb des Biomanteils denselben Stellenwert. Eine Familie wird nur berücksichtigt, wenn der Versionskatalog des gewählten Generierungsmodells ein Mitglied davon enthält.
Für Oberflächengelände nimmt der Rechner Stichproben in einem 32-Block-Raster auf ungefährer Oberflächenhöhe. Liefert diese Höhe ein Höhlenbiom, wird die Probe aus der Oberflächenzählung ausgeschlossen. Schmale Bereiche können zwischen Rasterpunkten liegen; die rohe Zählung gibt daher die Anzahl erfasster Biom-IDs an und ist kein vollständiges Verzeichnis.
Die Höhlenstichproben verwenden ein 64-Block-Raster bei Y -48, -32, -16, 0, 16, 32 and 48 und behalten Punkte mindestens acht Blöcke unterhalb der ungefähren Oberfläche. Diese Proben erkennen Höhlenbiomregionen. Eine Probe kann in festem Gelände liegen und beweist daher keine zugängliche Höhle an diesen Koordinaten. Vertikale Wege und Grabaufwand erhalten in diesem ersten Bewertungsschema keinen Entfernungsabzug.
Bauwerke tragen nach Typ bei: Dörfer zählen einmal, unabhängig davon, wie viele Dorfvorhersagen innerhalb des Kreises liegen. Ein Dorf und ein Schiffswrack ergänzen zwei unterschiedliche Typen. Der Rechner sucht die nächste Vorhersage jedes berücksichtigten Typs, einschließlich unterirdischer Ziele, sofern die Versionskriterien sie unterstützen.
Verlassene Minen sind aus jedem Profil ausgeschlossen, weil der verfügbare Finder für das nächste Vorkommen die Abdeckung nicht für alle angebotenen Radien belegen kann. Der Wert misst daher die aufgeführten Kriterien und nicht jedes mögliche Oberweltziel.
Nahe Entdeckungen stärker gewichten
Für jede gefundene Familie oder jeden Bauwerkstyp bestimmt die horizontale Entfernung den Beitrag:
credit = 1 − 0.5 × distance / radius
Eine Entdeckung am Spawn erhält 1. Beim halben Radius erhält sie 0,75 und am Rand 0,5. Ein nicht gefundenes Kriterium erhält 0. Der Durchschnitt jeder Kategorie enthält im Nenner jedes berücksichtigte Kriterium, auch nicht gefundene.
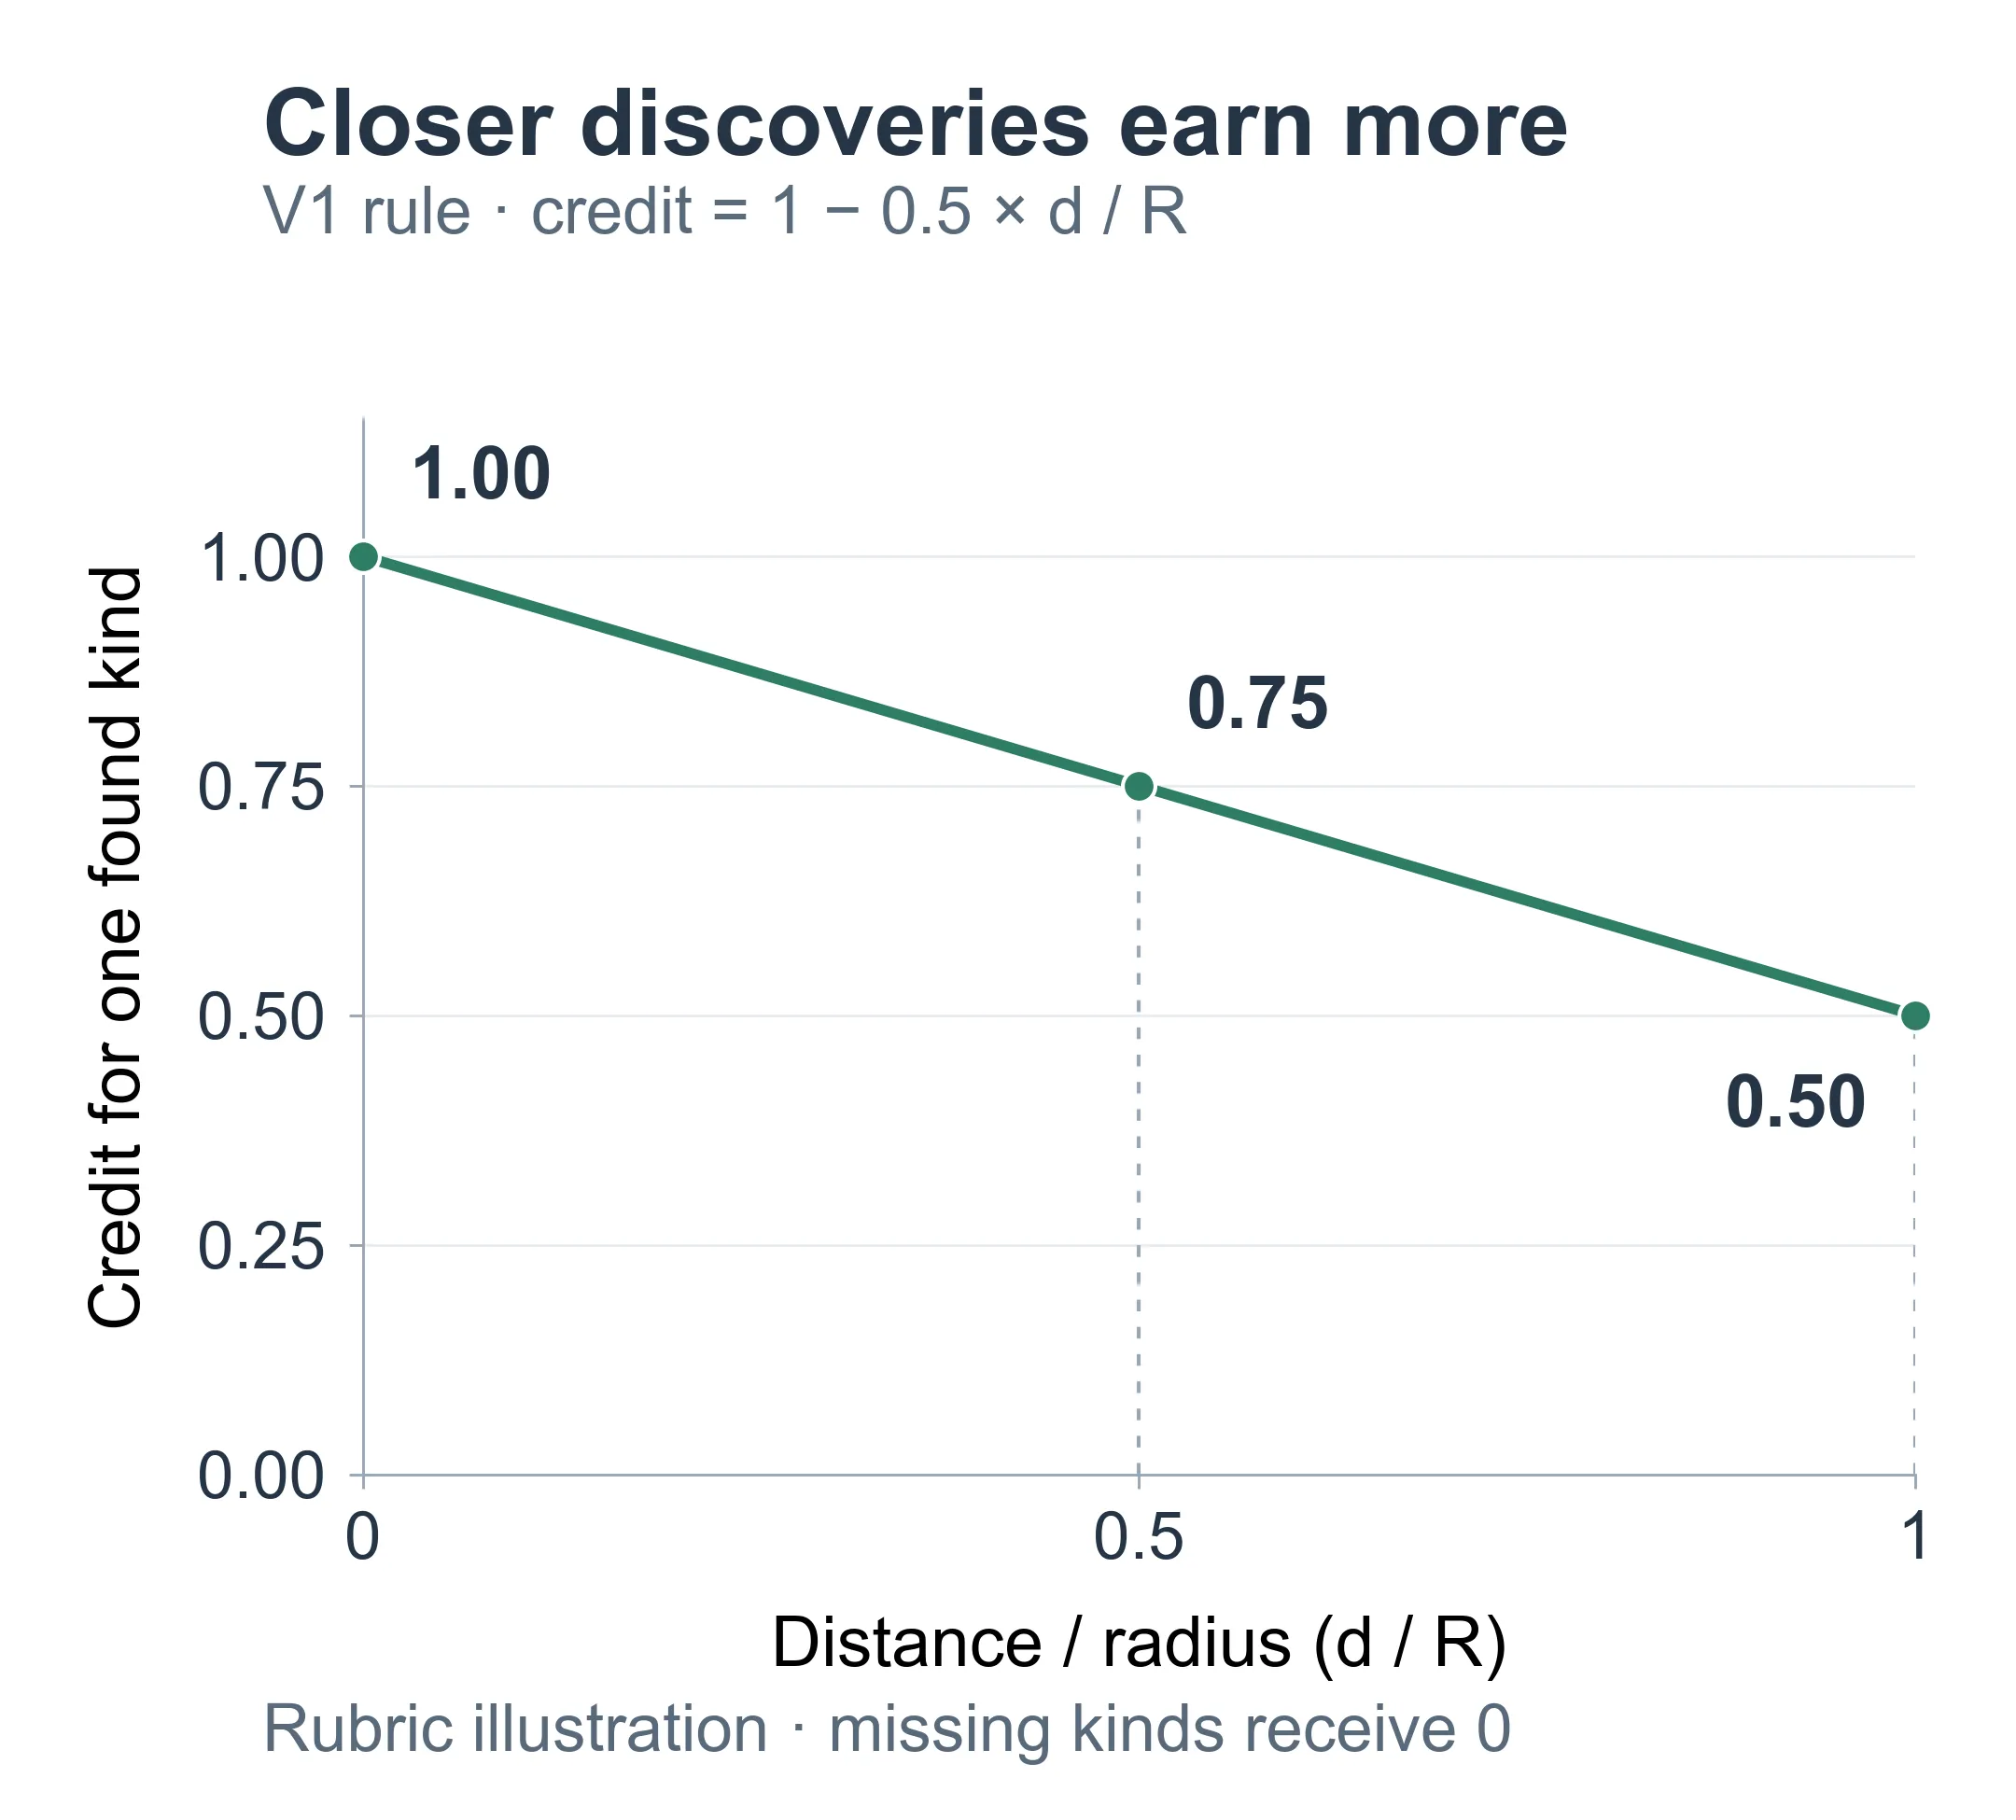
Veranschaulichung des Bewertungsschemas, keine Stichprobe von Welten. Die horizontale Achse teilt die Entfernung durch den gewählten Radius; die vertikale Achse zeigt den Beitrag eines gefundenen Kriteriums.
Die abschließende Berechnung gewichtet beide Kategorien gleich:
index = round(100 × (0.5 × biome average + 0.5 × structure average))
In den Profilen für Java 26.3 und Bedrock 26.50 können Biome über 35 Familien bis zu 50 Punkte beitragen, Bauwerke über 17 Typen ebenfalls bis zu 50. Eine Familie kann vor der Rundung etwa 50 / 35 = 1.43 Indexpunkte beitragen; ein Bauwerkstyp etwa 50 / 17 = 2.94. Beide Beiträge nehmen mit der Entfernung ab. Würden alle 52 Kriterien in einer einzigen, gleich gewichteten Liste zusammengefasst, hätten Biome mehr Einfluss; die beiden Hälften halten ihre Gesamtgewichte gleich.
Hier ist ein hypothetisches Beispiel zur Veranschaulichung der Rechnung, kein Ergebnis für einen bestimmten Seed:
| Kategorie | Beiträge ihrer berücksichtigten Kriterien | Durchschnitt |
|---|---|---|
| Vier Biomfamilien | 1; 0,75; 0,5; 0 | 0,5625 |
| Drei Bauwerkstypen | 0,75; 0; 0 | 0,25 |
Der Index ist round(100 × (0.5 × 0.5625 + 0.5 × 0.25)) = 41.
Die Gruppierung, die gleichen Kategoriegewichte und der halbe Beitrag am Rand sind Entscheidungen in Revision 1. Wir haben diese Entscheidungen nicht anhand einer Umfrage zu den Vorlieben von Spielern angepasst. Eine Familie oder ein Bauwerkstyp erhält nicht automatisch mehr Gewicht, weil sie oder er in der Referenzstichprobe seltener vorkommt.
Das Werkzeug unterscheidet außerdem zwischen einer abgeschlossenen Suche ohne Vorhersage und einer unvollständigen Suche. Wenn begrenzte Bauwerksabdeckung einen Typ unbekannt lässt, wird der Gesamtwert nicht ausgegeben. Unbekannte Abdeckung zählt weder als erfolgreiche Entdeckung noch als fehlender Typ.
Berechnungscode teilen, Kriterien je Version prüfen
Die Unterstützung einer Minecraft-Version erfordert zwei getrennte Entscheidungen: welches Generierungsmodell verwendet wird und welche Berechnungskriterien gelten.
Der Rechner verwendet einen gemeinsamen Kern für Stichproben und Bewertung. Java und Bedrock nutzen die vorhandenen editionsspezifischen Generierungsmodelle der Website. Ein explizites Verzeichnis verknüpft jede unterstützte Generierungsversion mit ihren Berechnungskriterien. Versionen können dieselben Kriterien verwenden, wenn die Regeln gleich sind; sie brauchen keine getrennten Kopien der Rechnerengine.
Die Kriterien steuern berücksichtigte Bauwerkstypen, Stichprobenabstände, Höhlentiefen, Kategoriegewichte und Entfernungsbeiträge. Der Biomkatalog stammt aus der gewählten Modellversion und wird mit den geprüften Familiendefinitionen abgeglichen. Ein unbekannter Biomname oder eine nicht unterstützte Version stoppt die Berechnung, bis die Kriterien geprüft wurden.
Das aktuelle Profil für Java 1.18.2 hat beispielsweise 29 berücksichtigte Biomfamilien und 13 Bauwerkstypen. Java 26.3 hat 35 Familien und 17 Typen. Das sind die Nenner des Rechners und keine Zählwerte für einen einzelnen Seed. Das ältere Profil wird nie für Kategorien belastet, die außerhalb des Modells und der Kriterien seiner Version liegen.
Jedes Ergebnis nennt Edition, Generierungsversion und Berechnungsrevision. Ändern sich Gruppierung oder Gewichte, braucht das Bewertungsschema eine neue Revision. Auch die passende Referenzstichprobe muss nach diesen Regeln ausgewertet werden. So bleibt die Berechnung wartbar und die Bedeutung eines gespeicherten Ergebnisses erhalten.
Das Ergebnis als Vorhersagen lesen
Das Ergebnis zeigt einen großen Wert, Balken für den Entfernungsbeitrag und Symbole für jede berücksichtigte Biomfamilie und jeden Bauwerkstyp. Abgeblendete Biomsymbole bedeuten „nicht erfasst“; abgeblendete Bauwerkssymbole bedeuten „keine Vorhersage gefunden“. Unbekannte Abdeckung hat einen eigenen Zustand, und ausgeschlossene oder für die Version nicht berücksichtigte Typen stehen außerhalb der bewerteten Listen.
Die Symbolgruppen zeigen, welche Arten vertreten waren. Die Beitragsbalken erklären, wie viel ihres möglichen Beitrags nach dem Entfernungsabzug übrig bleibt. Zwei Seeds können dieselben Familien- und Typenzahlen haben, aber unterschiedliche Werte, wenn ihre nächsten Entdeckungen unterschiedlich weit entfernt liegen. Behalte beim Vergleich die Zählwerte und beide Kategoriebeiträge neben dem Gesamtwert bei.
Das Ergebnis behält die Zählwerte erfasster Oberflächen- und Höhlenbiome, beide Nenner und die nächsten Koordinaten bei. Über seine Seed-Kartenlinks kannst du diese Positionen untersuchen. Eine Biomkoordinate ist der nächste Stichprobenpunkt und keine exakte Biomgrenze. Spawn und Oberflächenhöhe sind Schätzungen.
Bauwerksvorhersagen verwenden die verfügbaren Platzierungs- und Biomprüfungen; spätere Generierung kann ein Bauwerk dennoch verhindern. Bedrock nutzt ein Kompatibilitätsmodell, dessen Genauigkeit nicht unabhängig im Spiel geprüft wurde. Die Über-uns-Seite erklärt die Belegkennzeichnungen der Website.
Das Profil gilt für die Standardgenerierung. Angepasste Datenpakete, Große Biome, superflache Welten und bestehende Chunks, die vor einem Weltupdate erzeugt wurden, liegen außerhalb seines Umfangs. Verwende die Version, die den bewerteten Bereich erzeugt hat.
Ein hoher Index belegt keine schöne Landschaft, leichtes Überleben oder wertvolle Beute. Er sagt auch nicht aus, welchen Teil des Kreises du tatsächlich besuchen wirst. Eine Inselwelt mit einem niedrigen Vielfaltwert kann besser zu dir passen als ein Seed mit vielen nahen Kategorien.
Einen für dich wichtigen Seed berechnen
Öffne den Rechner, gib einen Seed ein und wähle Edition und Generierungsversion. Java akzeptiert auch Seed-Text und wandelt ihn in einen numerischen Seed um; Bedrock verwendet einen numerischen Seed. Wähle einen Radius und starte die Berechnung.
Prüfe die Aufschlüsselung nach Kategorien, bevor du die Endwerte vergleichst. Wenn dir ein bestimmtes Biom oder Bauwerk besonders wichtig ist, suche mit dem Seed-Finder nach dieser Bedingung und bewerte anschließend die umgebende Vielfalt mit dem Rechner. Die URL des Rechners behält deine Eingabeeinstellungen bei, sodass du zur selben Fragestellung zurückkehren kannst.
Was uns zufällige Seeds zeigen
Wir wählten 1.024 pseudozufällige numerische Seeds als vorzeichenbehaftete 64-Bit-Werte aus und werteten jeden Seed sowohl in Java 26.3 als auch in Bedrock 26.50 aus. Beide Gruppen verwenden die Standardgenerierung der Oberwelt, einen Radius von 2.048 Blöcken und Berechnungsrevision 1 mit 35 berücksichtigten Biomfamilien und 17 Bauwerkstypen. Dieselben Seed-Zahlen bilden eine gepaarte Untersuchung; die Verteilung jeder Edition wird getrennt zusammengefasst. Alle 2.048 Modellauswertungen wurden abgeschlossen, ohne ein fehlgeschlagenes oder unvollständiges Ergebnis auszulassen oder zu ersetzen.
Wir wählten numerische Seeds aus, ohne sie aus dem veröffentlichten Katalog zu kuratieren. Diese Untersuchung beschreibt den Rechner unter diesen Einstellungen; sie misst keine Welten, die Spieler zum Behalten ausgewählt haben.
Die Gesamtverteilung lesen
Die Tabelle beschreibt den angezeigten, gerundeten Index. P10 bis P90 nennt das 10. und 90. Perzentil der Stichprobe. Durch gleiche ganzzahlige Werte kann der Anteil zwischen diesen Werten über 80% liegen; der Bereich ist kein Konfidenzintervall.
| Generierungsmodell | Mittlerer Index | Median des Index | P10 bis P90 | Median erfasster Familien | Median vorhergesagter Typen |
|---|---|---|---|---|---|
| Java 26.3 | 62,4 | 62 | 56 bis 68 | 27 von 35 | 13 von 17 |
| Bedrock 26.50 | 62,8 | 63 | 57 bis 69 | 27 von 35 | 13 von 17 |
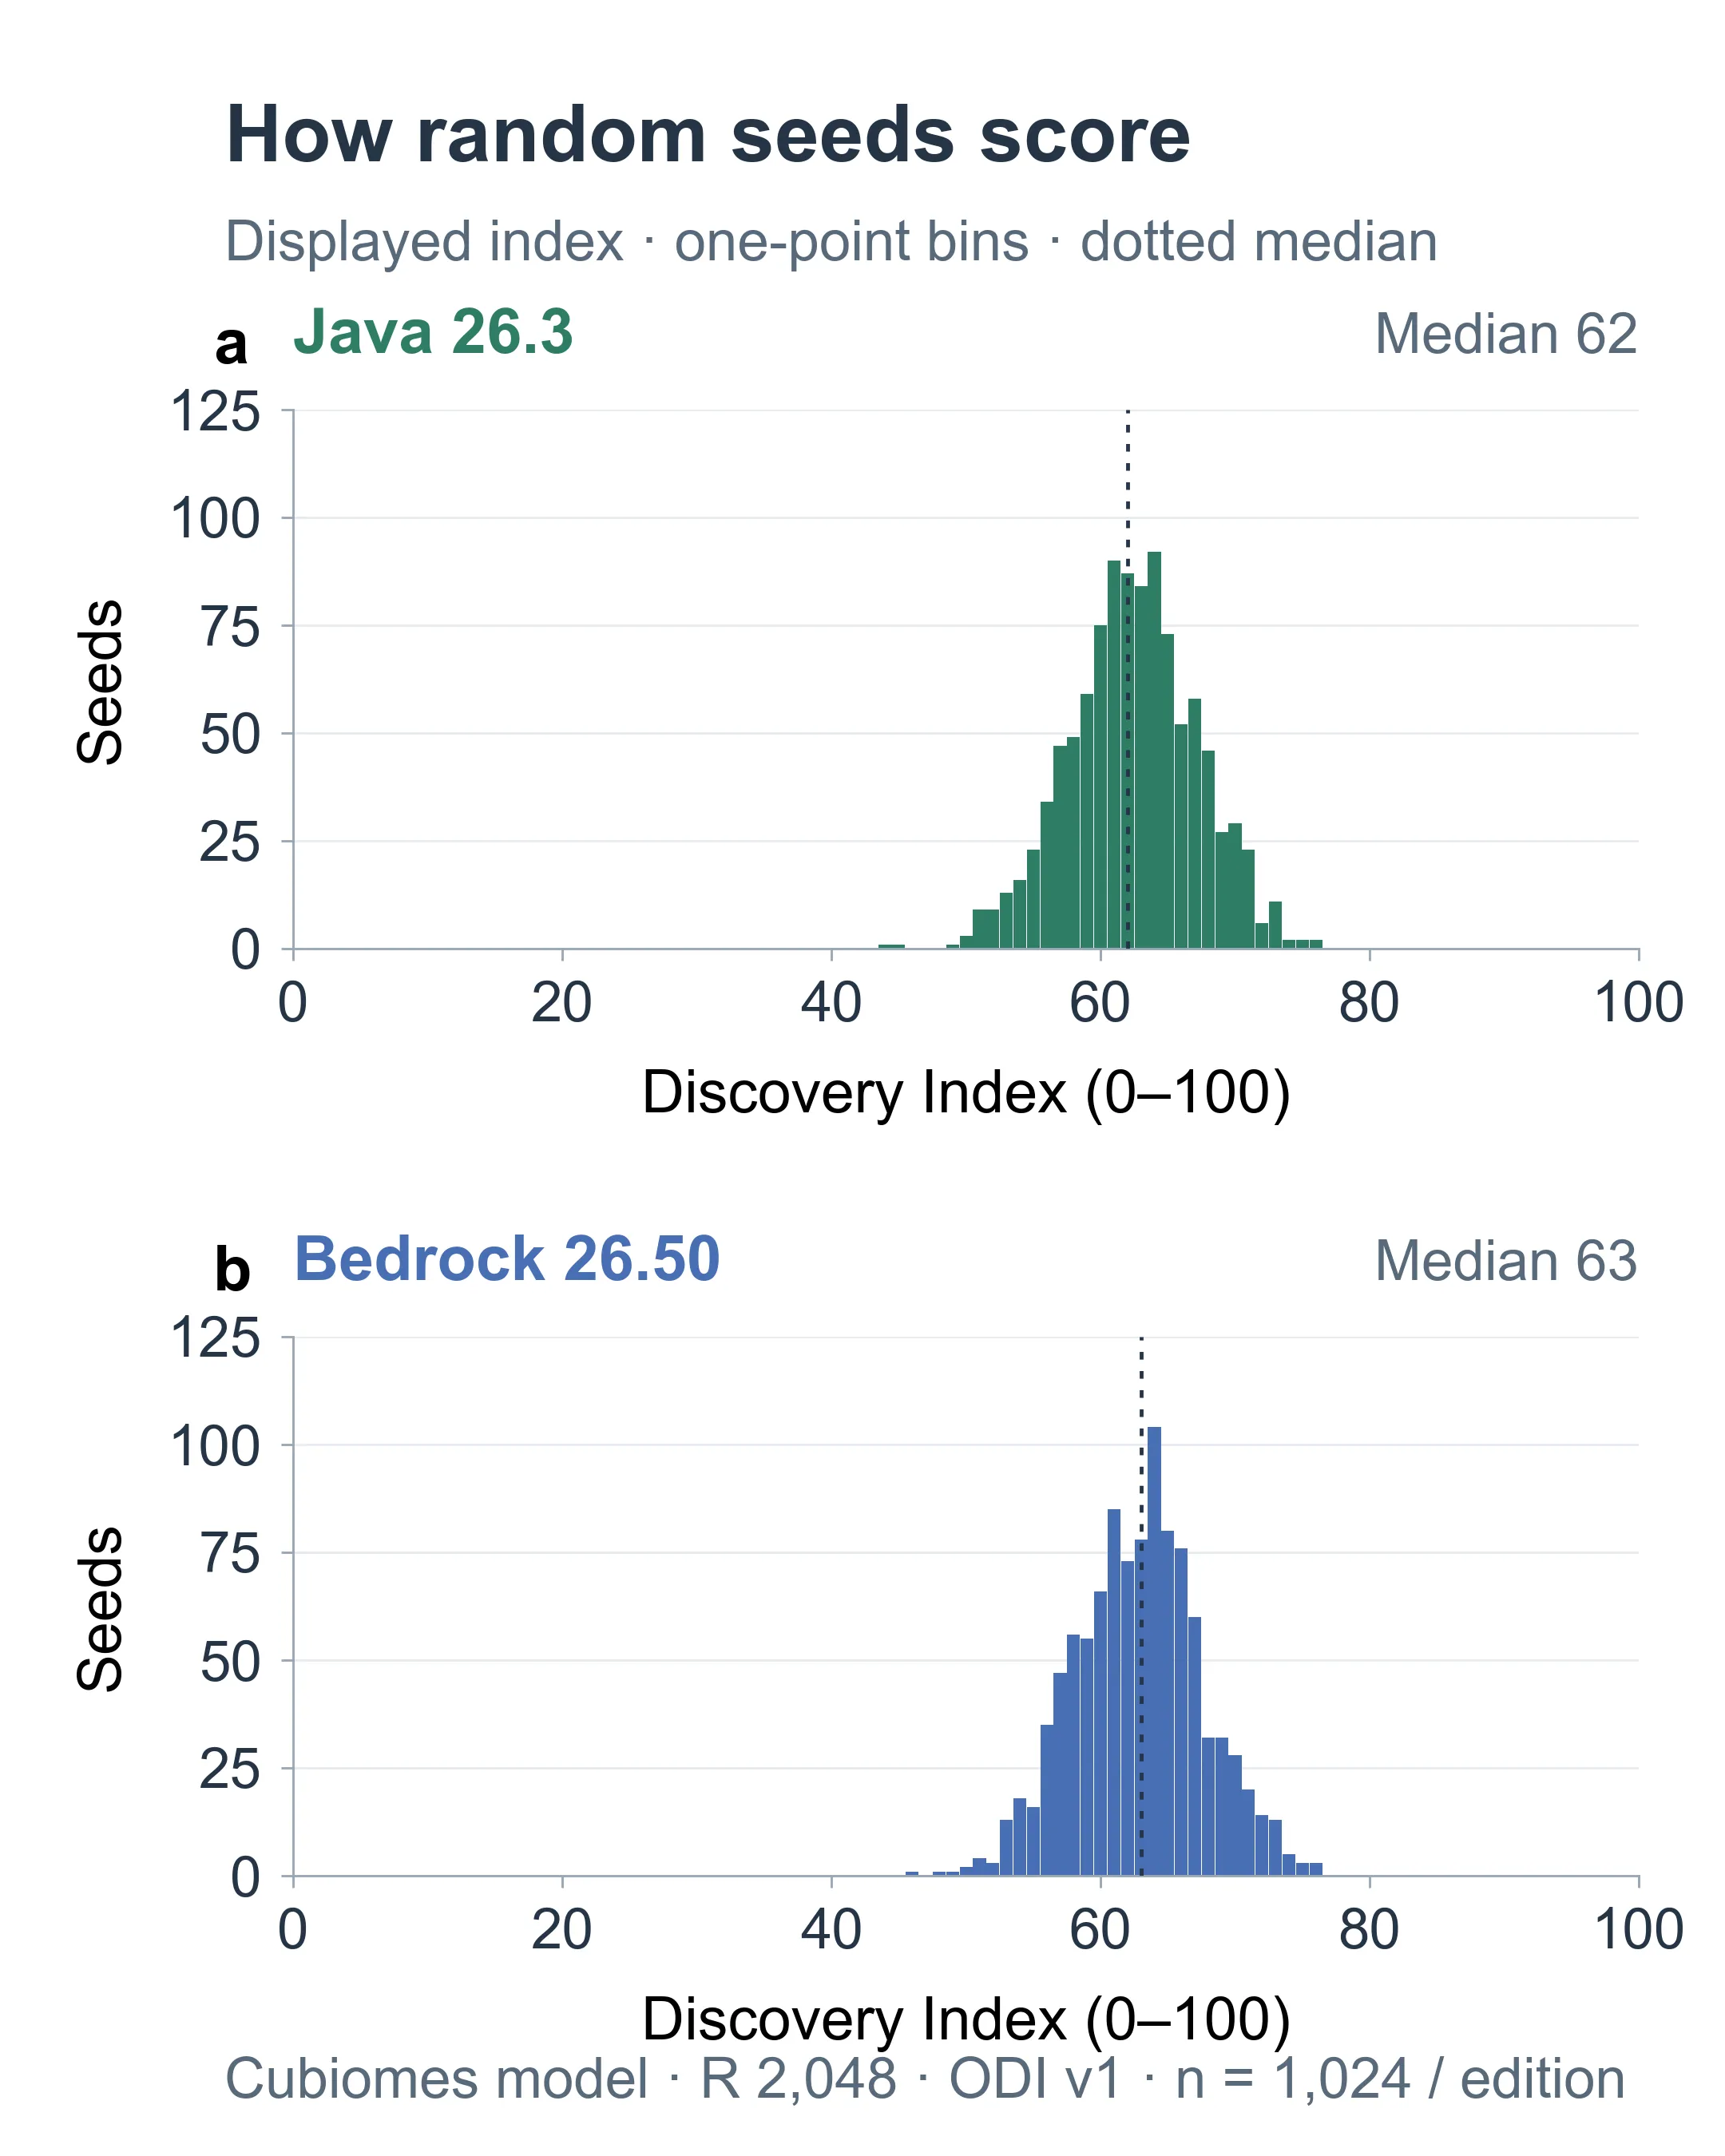
Modellvorhersagen des Rechners. Jeder schmale Balken zählt Seeds bei einem angezeigten Indexwert. Beide Felder verwenden die volle Werteskala von 0 bis 100 und dieselbe Skala für die Seed-Anzahl.
Die horizontale Achse zeigt den angezeigten Index; die vertikale Achse die Anzahl der untersuchten Seeds, die ihn erhalten. Höhere Balken kennzeichnen häufigere Werte in der Gruppe. Die Java-Werte reichen von 44 bis 76 und die Bedrock-Werte von 46 bis 76. Ihre Mediane liegen nahe der Mitte dieser beobachteten Verteilungen, weit unter der theoretischen Obergrenze von 100.
Ein Wert von 69 liegt daher für beide passenden Referenzstichproben über dem Median. Die Biom- und Bauwerksaufschlüsselung erklärt, welche Entdeckungen diese Punkte lieferten.
Vielfalt und Entfernungsbeitrag trennen
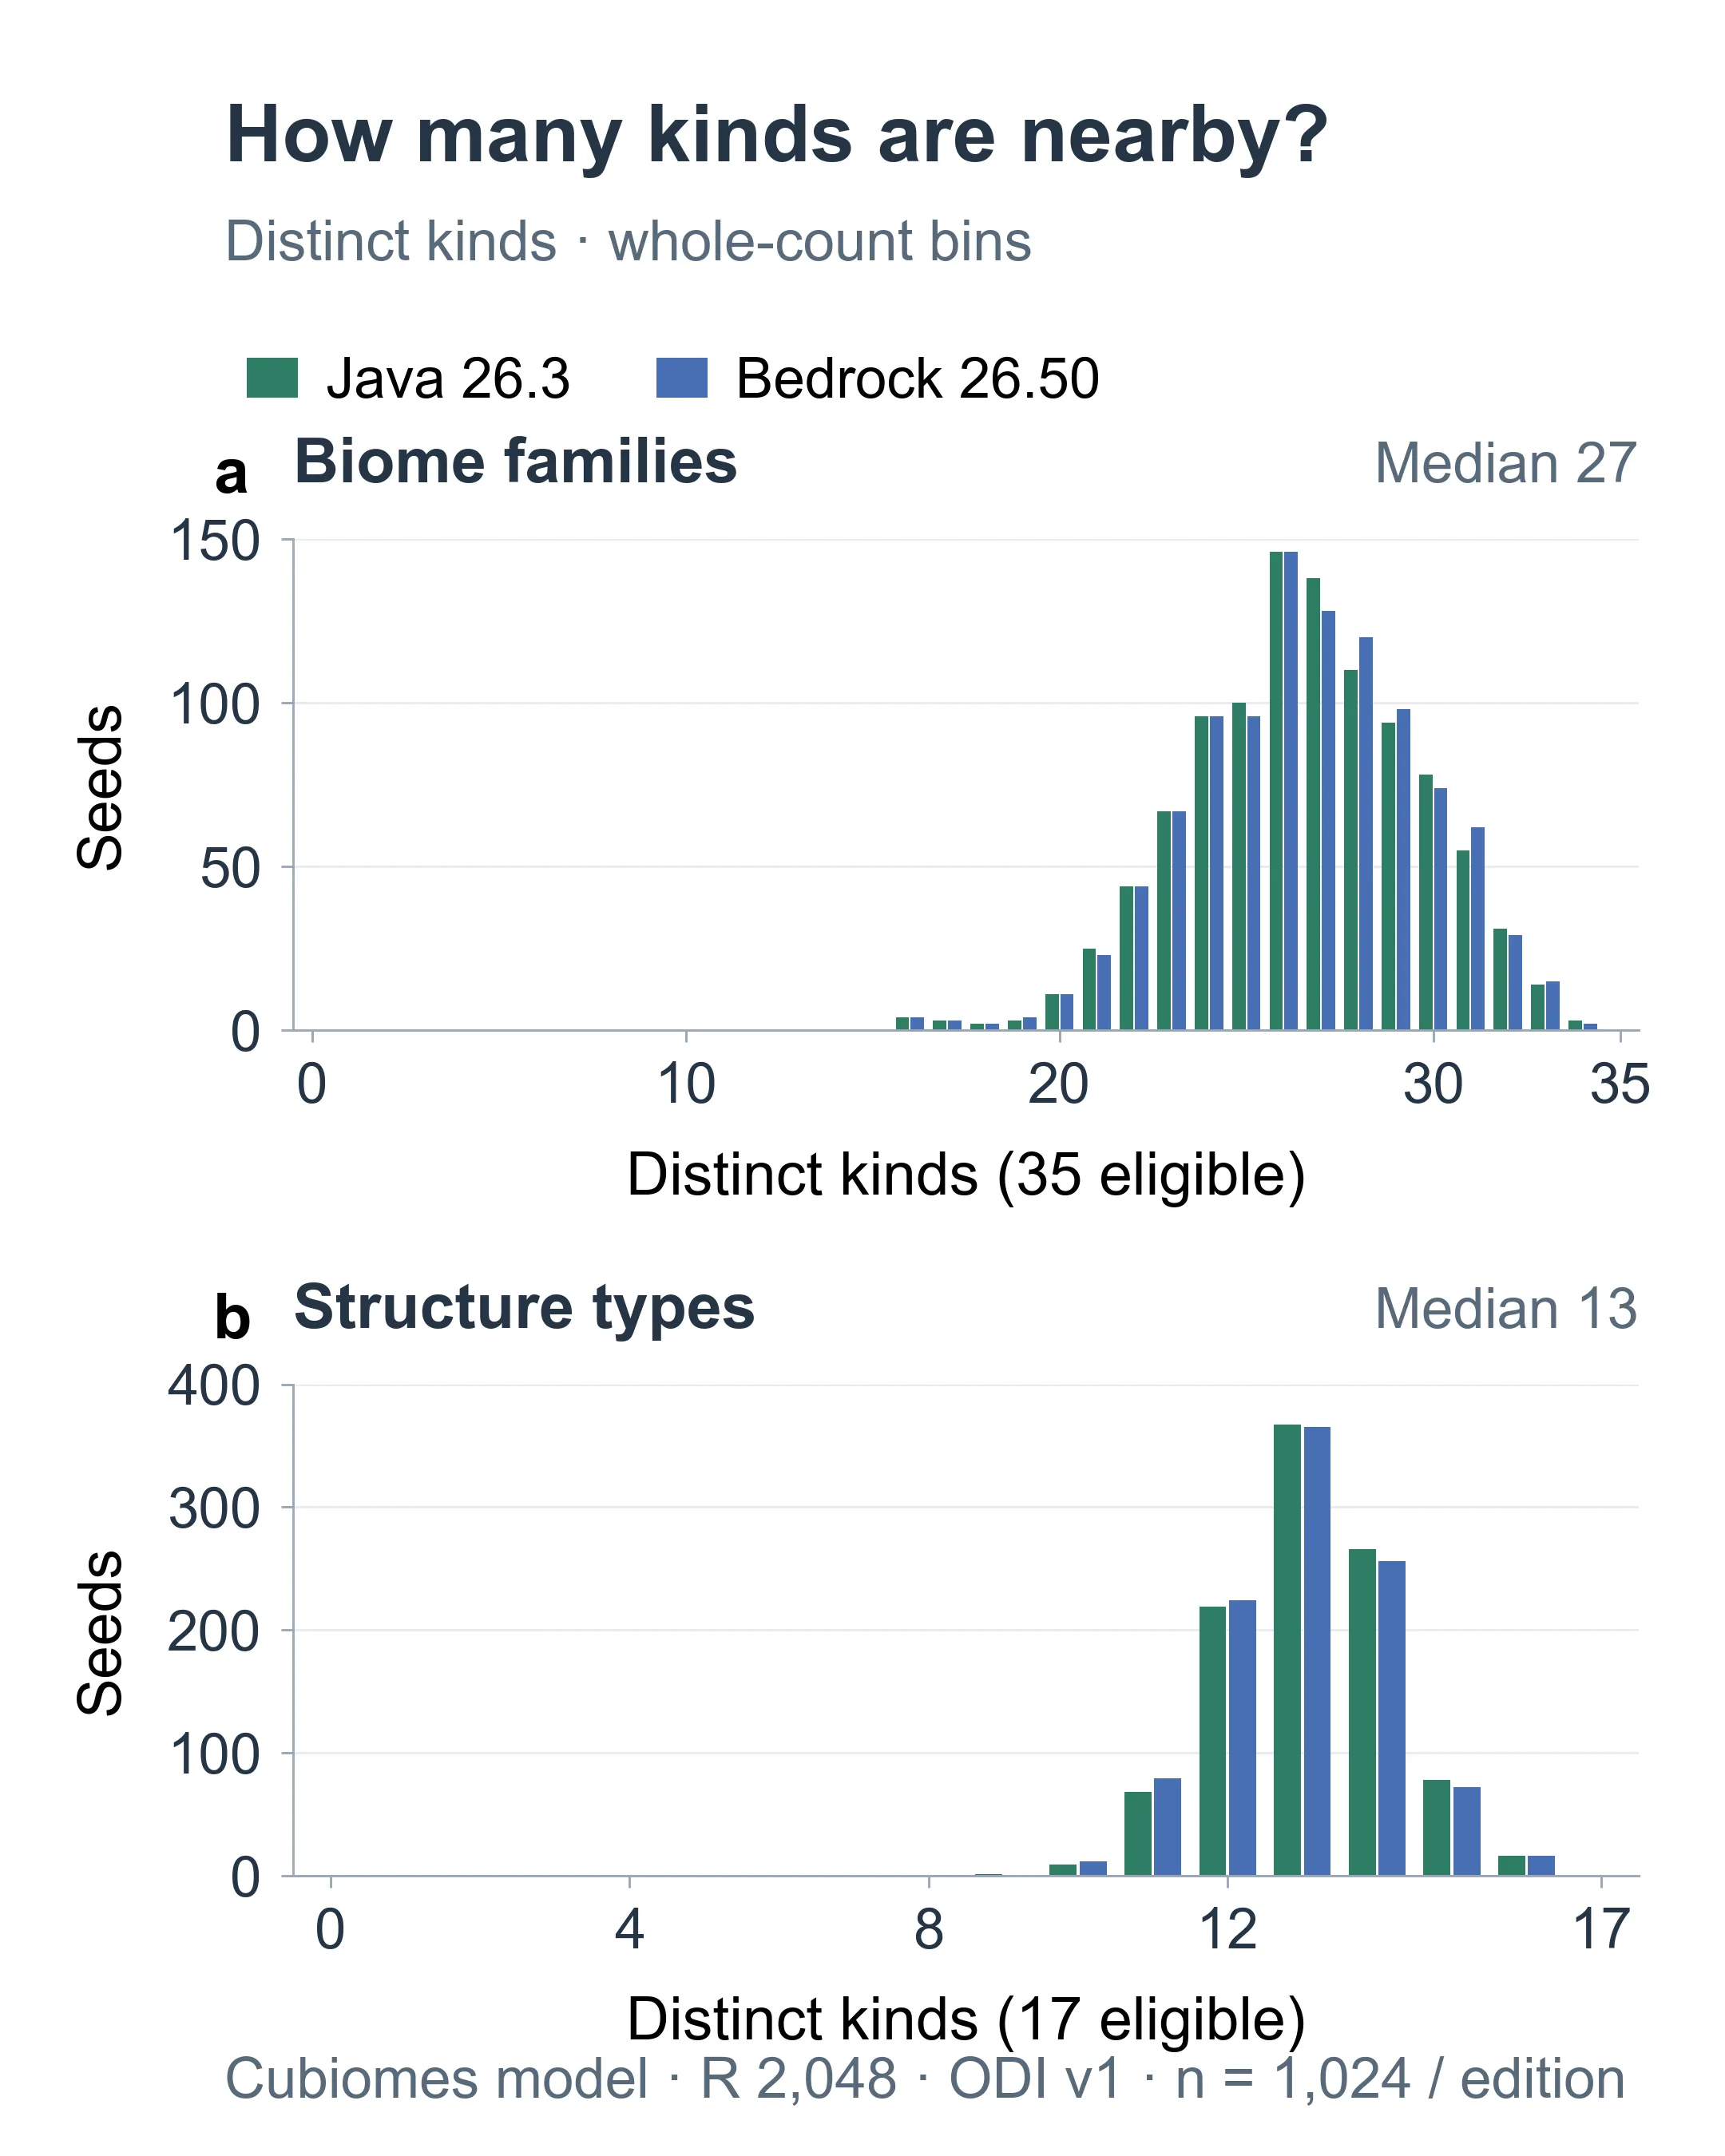
Jeder Balken zählt Modell-Seeds mit einer bestimmten Anzahl vertretener Familien oder Bauwerkstypen. Oberflächen- und Höhlenfamilien sind enthalten. Diese Zählwerte haben keine Entfernungsgewichtung.
Das obere Feld fragt, wie viele unterschiedliche Biomfamilien innerhalb des Kreises erfasst wurden. Das untere fragt, für wie viele unterschiedliche Bauwerkstypen es darin eine Vorhersage gab. Lies die grünen und blauen Balken innerhalb jeder Ganzzahlgruppe getrennt; ihre Addition würde zwei Editionen zusammenführen, deren Referenzeinstellungen getrennt bleiben müssen.
Beide Editionen haben einen Median von 27 erfassten Familien und 13 vorhergesagten Typen. Die Familienzahlen reichen in jeder Gruppe von 16 bis 34. Die Zahlen vorhergesagter Typen reichen in Java von 9 bis 16 und in Bedrock von 10 bis 16. Unter diesen Modelleinstellungen waren in keiner untersuchten Welt alle 35 Familien oder alle 17 Typen vertreten.
Die Vielfalt beantwortet, wie viele Arten vertreten sind, unabhängig von der Entfernung ihrer nächsten Proben oder Vorhersagen. Der Endwert belohnt zusätzlich Nähe. Deshalb ist weder eine Familienzahl von 27 noch eine Bauwerkszahl von 13 als Teilwert von 27 oder 13 von 100 zu lesen.
Die Biomhälfte untersuchen
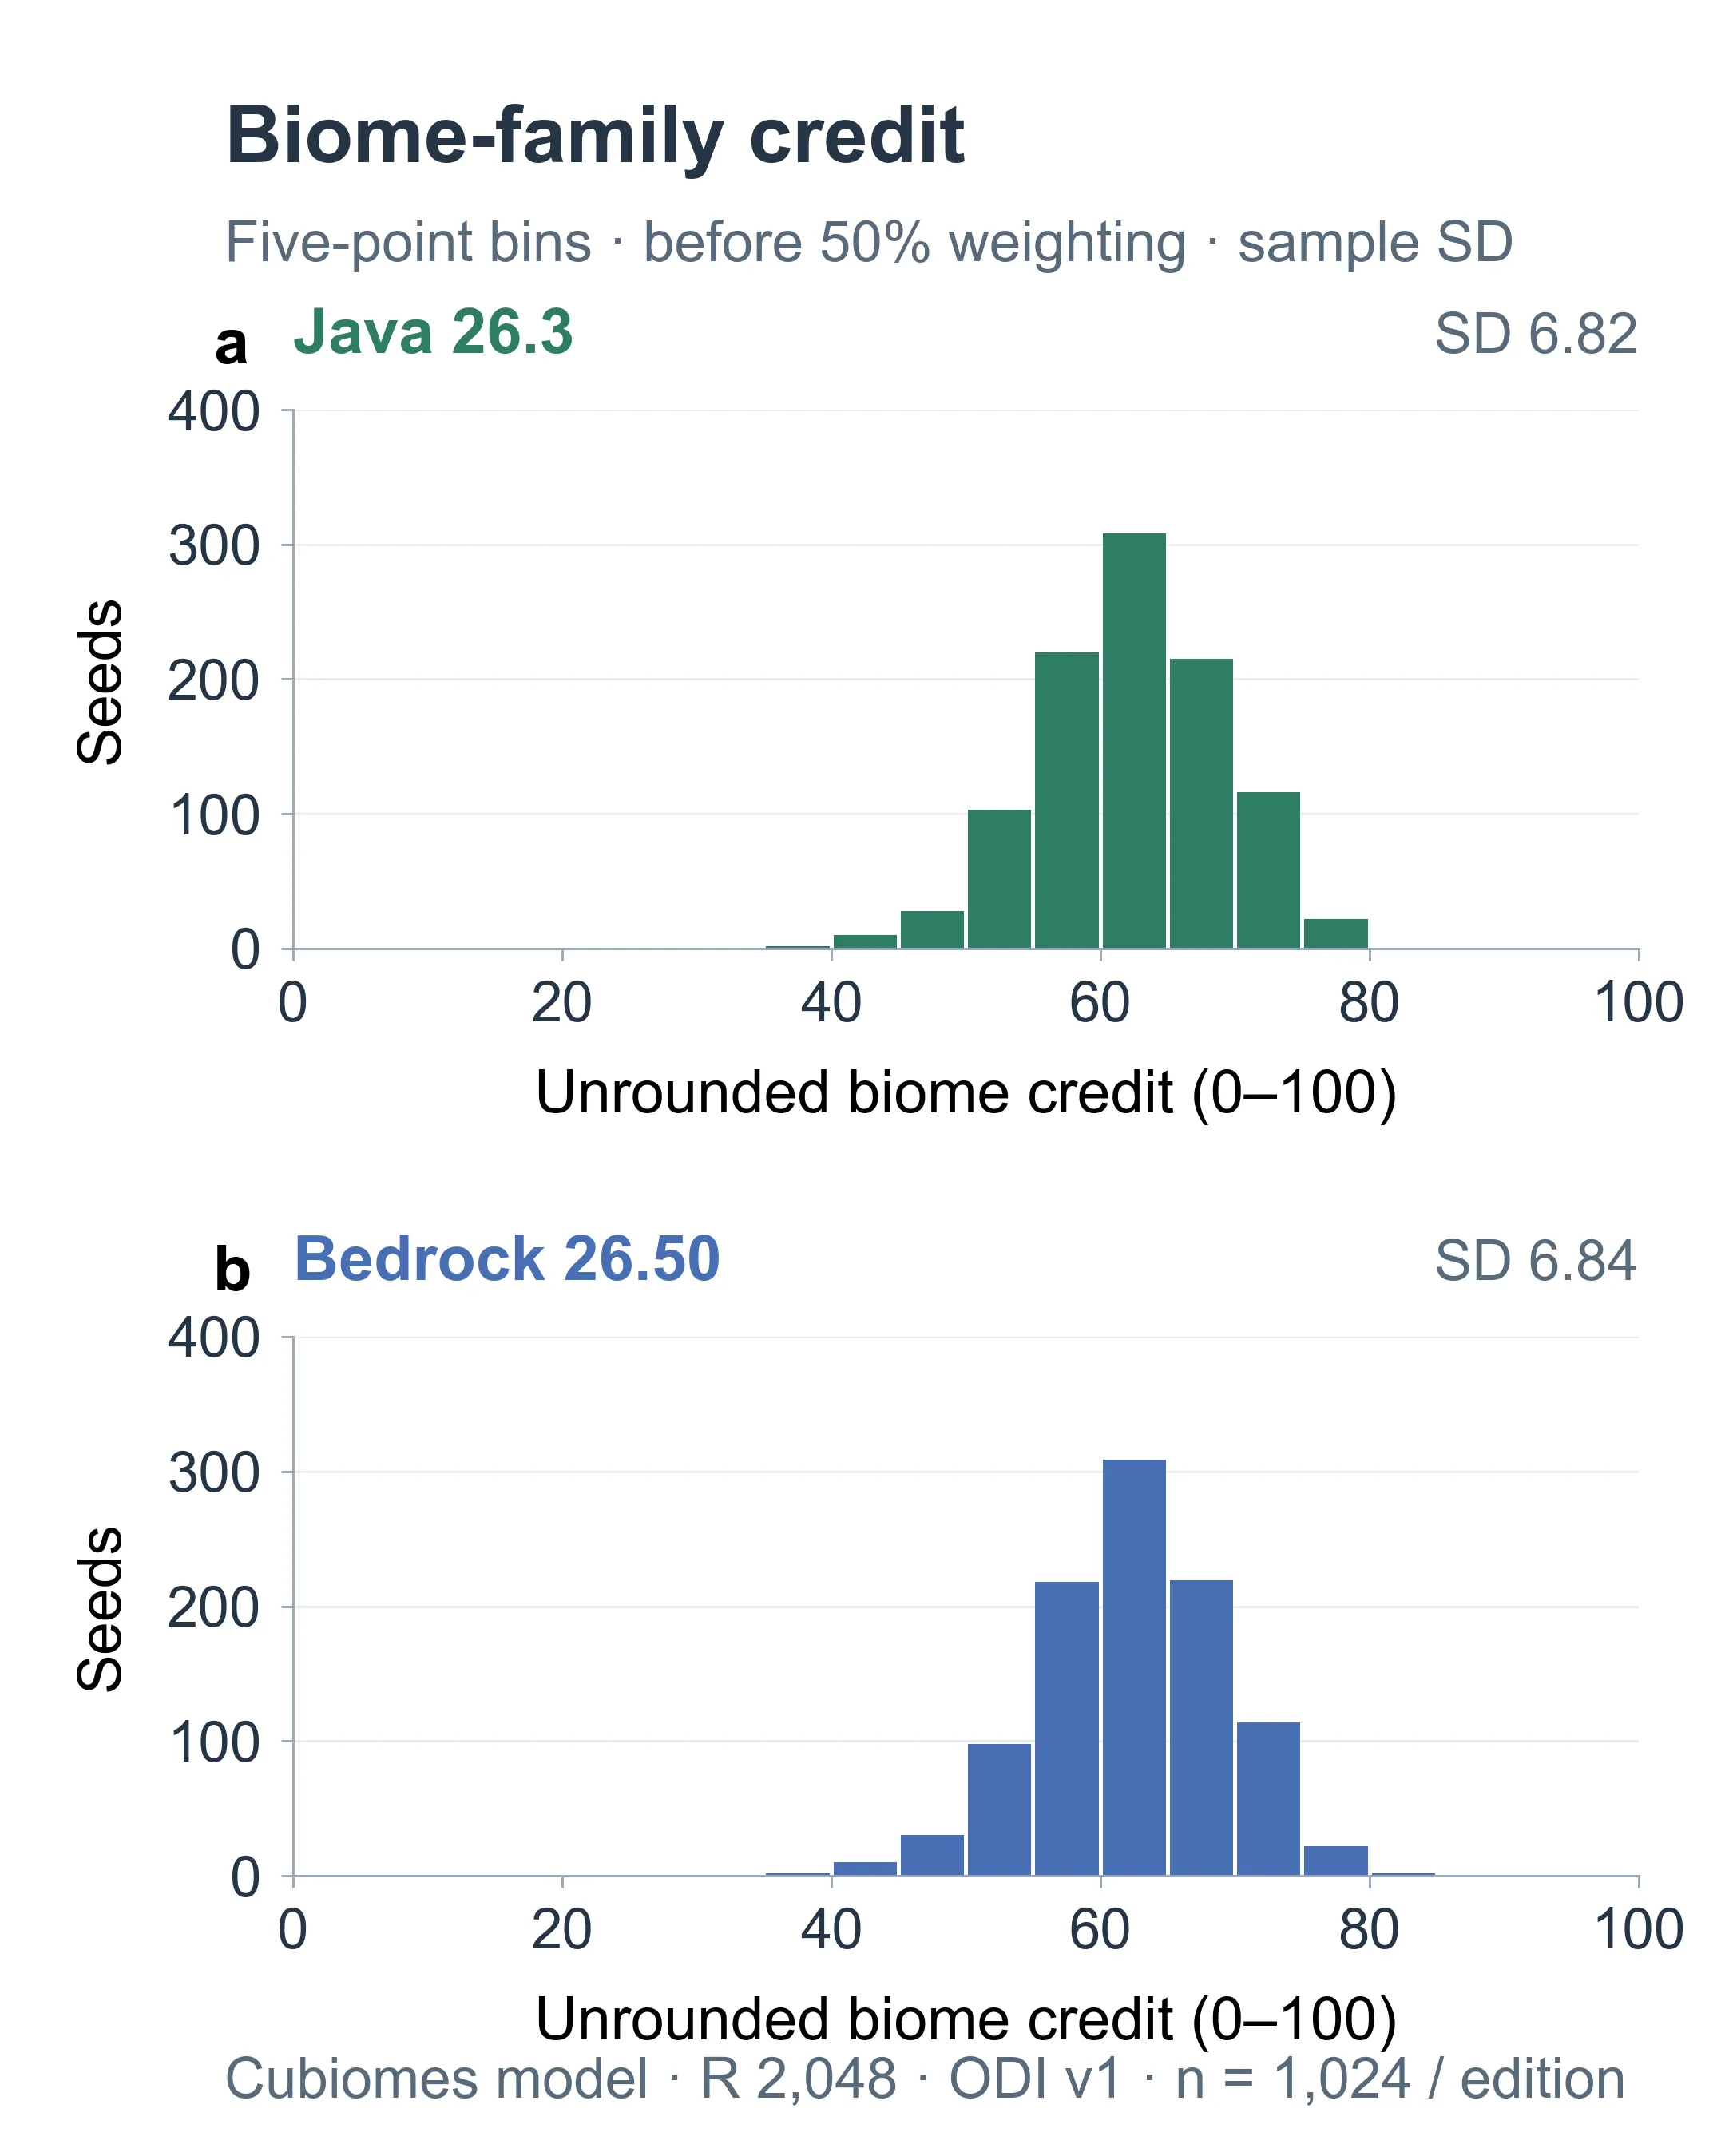
Modellvorhersagen aus derselben gepaarten Seed-Stichprobe. Die Werte der horizontalen Achse sind Biomwerte vor ihrer halben Gewichtung im Gesamtindex.
Jeder Balken umfasst ein Intervall von fünf Punkten, anders als die Balken für einzelne Ganzzahlen im Histogramm des Gesamtwerts. Ein Biomteilwert von 70 würde vor der abschließenden Rundung 35 Indexpunkte beitragen. Er bedeutet, dass der durchschnittliche Beitrag über die berücksichtigten Familien 0,70 beträgt; er bedeutet nicht, dass 70 Familien oder 70% des Kreises erkundet wurden.
Die Biomverteilungen schwanken in diesen Stichproben stärker als die Bauwerksverteilungen weiter unten. Ihre Stichprobenstandardabweichungen betragen etwa 6,82 Punkte in Java und 6,84 in Bedrock. NIST beschreibt die Standardabweichung als Maß für die Streuung um den Stichprobenmittelwert, ausgedrückt in den ursprünglichen Einheiten. Hier sind diese Einheiten Punkte des Teilwerts. Sie beschreibt Unterschiede zwischen Seed-Werten und keine Fehlerspanne des Mittelwerts. Beide Biomverteilungen zeigen außerdem in unserem diagnostischen Test nach Korrektur für mehrere Tests eine statistisch erkennbare Abweichung von einer Normalverteilung.
Familienzahl und Entfernungen erzeugen diese Streuung gemeinsam. Das Histogramm kann nicht zeigen, welche Familie einem bestimmten Seed fehlt; diese Frage beantworten die Symbole und Koordinatendetails des Rechners.
Die Bauwerkshälfte untersuchen
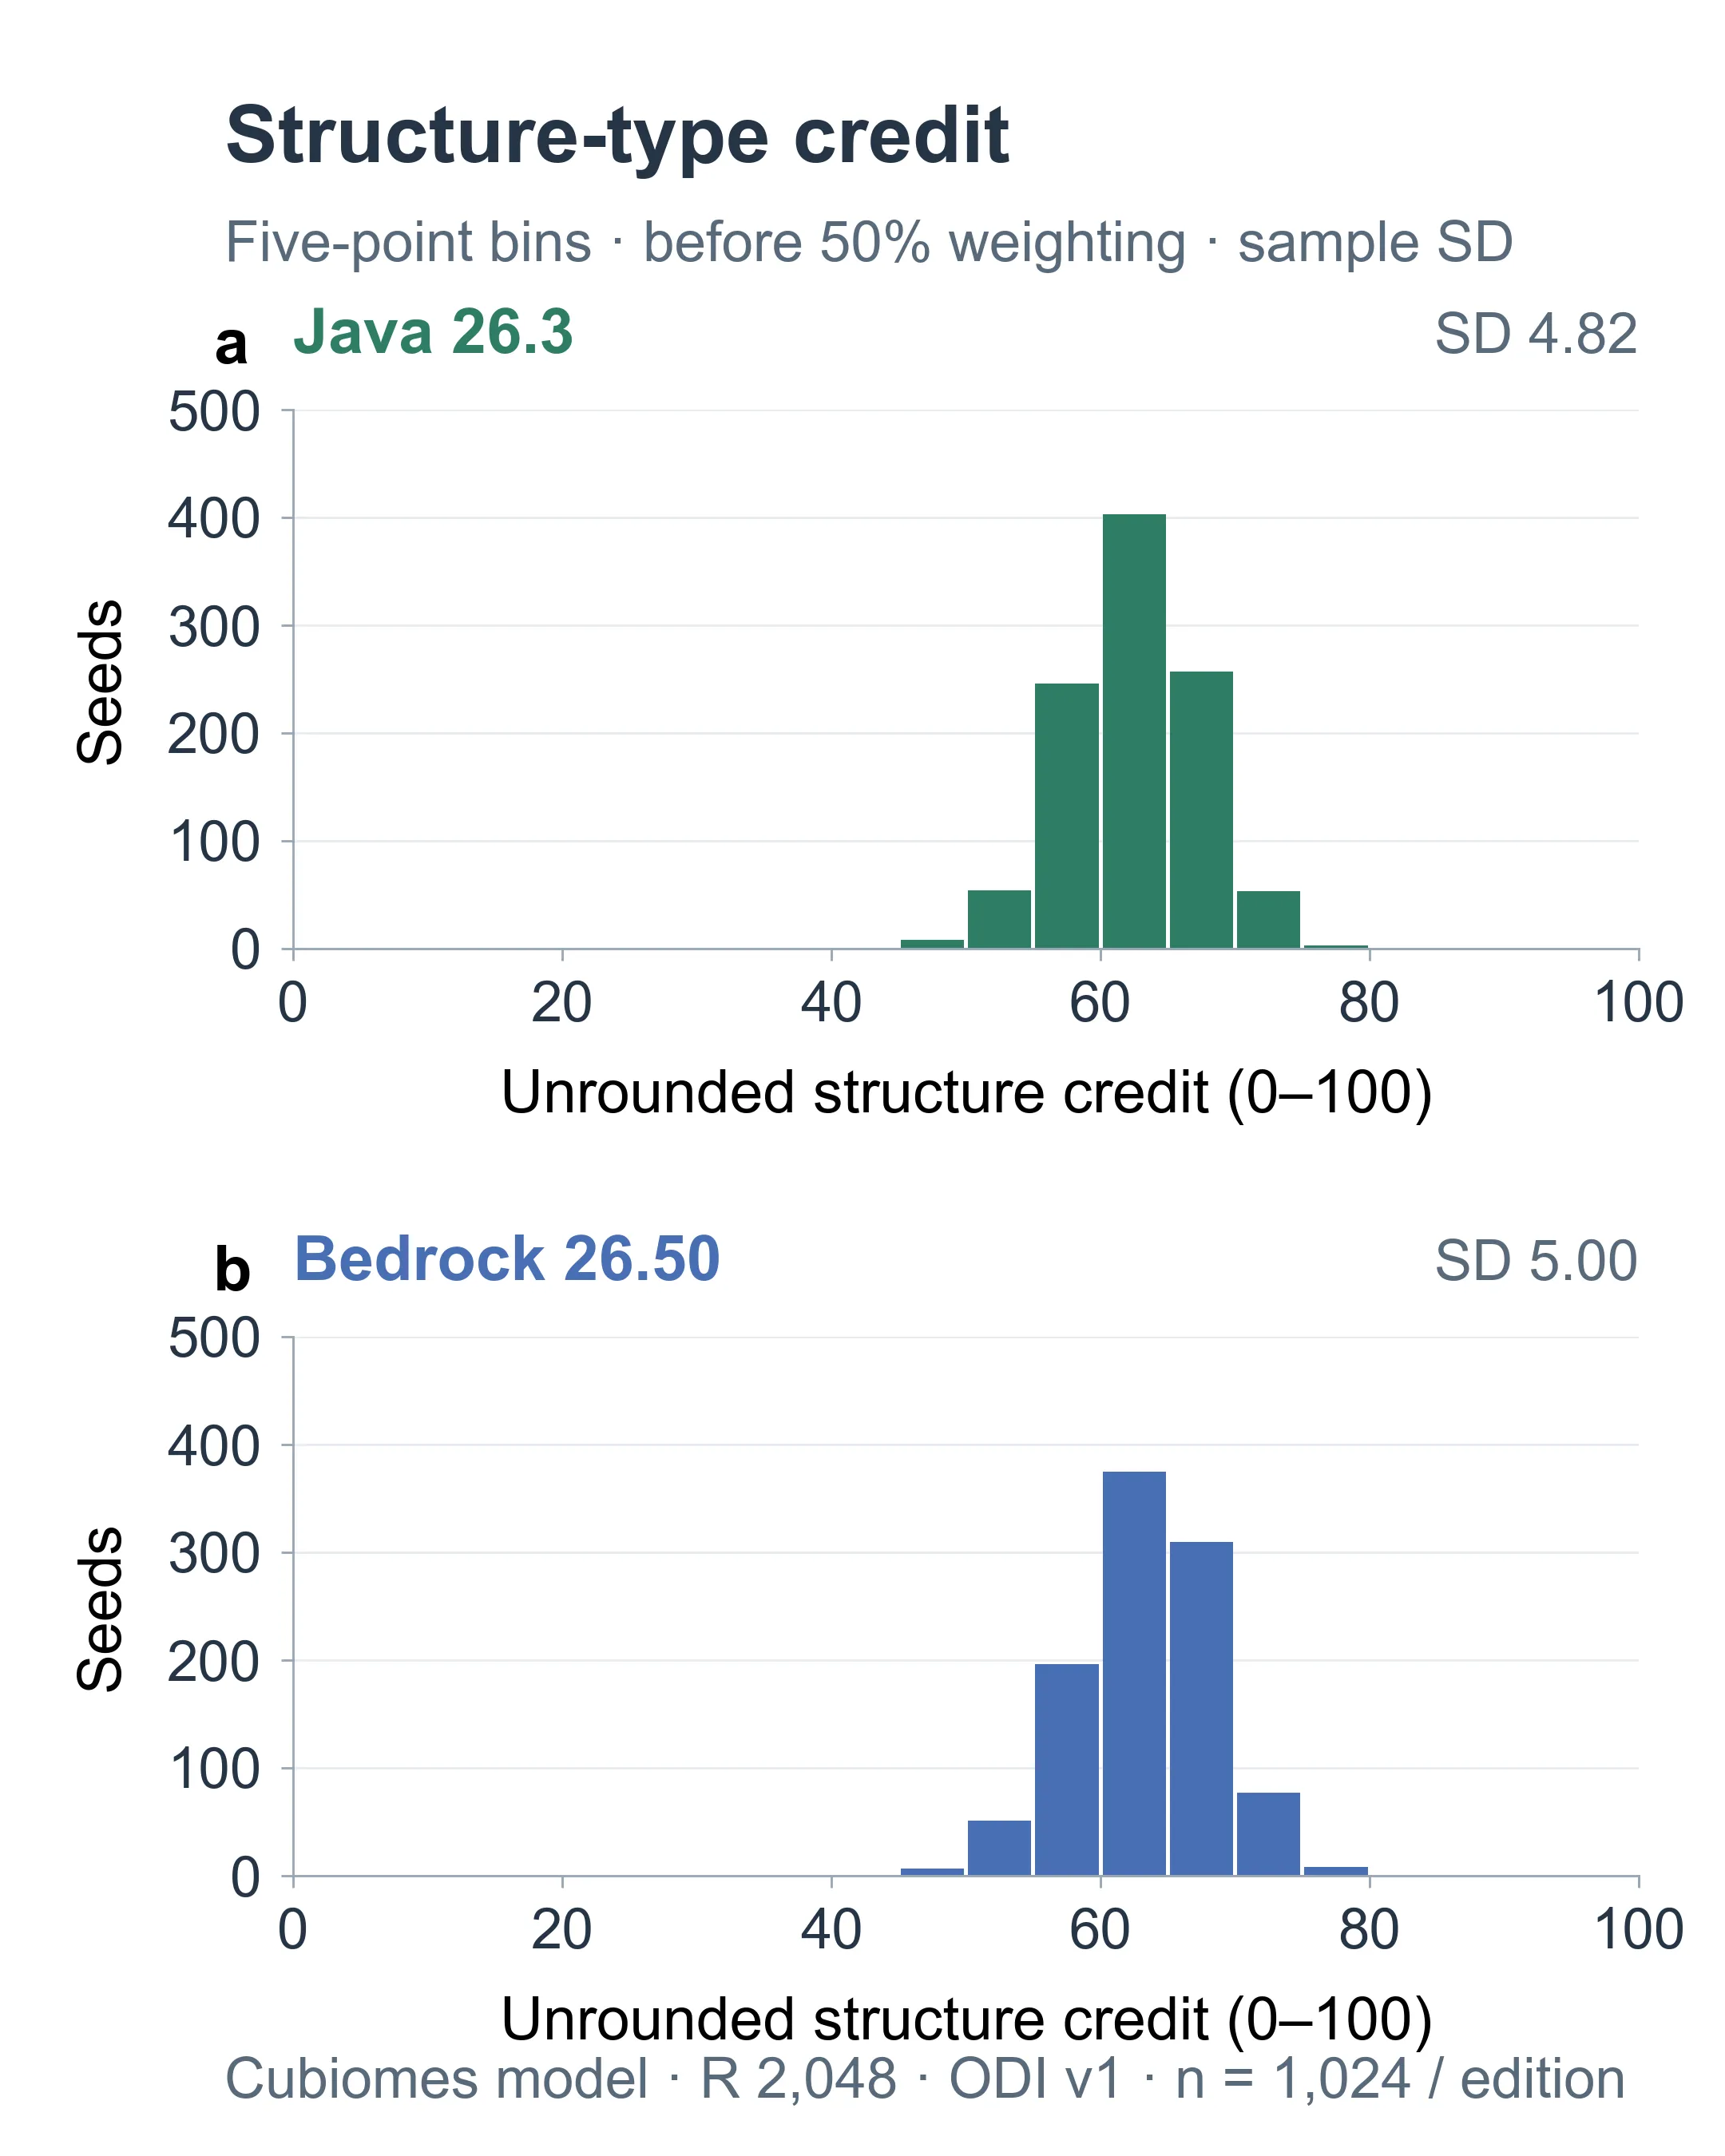
Jeder modellierte Bauwerkstyp trägt einmal über seine nächste Vorhersage bei. Das Diagramm zählt nicht alle Bauwerke einer Welt.
Die Achsen und Fünf-Punkte-Klassen haben dieselbe Bedeutung wie im Diagramm des Biomteilwerts, sodass ihre horizontalen Streuungen vergleichbar sind. Jedes Diagramm hat eigene vertikale Markierungen für die Seed-Anzahl. Die Stichprobenstandardabweichungen betragen etwa 4,82 Punkte für Java und 5,00 für Bedrock und sind kleiner als die Streuung des Biomteilwerts. Unser korrigierter Normalitätstest verwarf keine der beiden Bauwerksteilwertverteilungen.
Die Bauwerkshälfte kombiniert Zahlen vertretener Typen mit horizontaler Nähe. Zusätzliche Dörfer desselben Typs liefern keine Vielfaltpunkte, und eine nahe vorhergesagte Festung erhält keinen zusätzlichen Ausgleich für den Aufwand, sie unterirdisch zu erreichen. Das sind Eigenschaften dieses Bewertungsschemas und keine Befunde zur Schwierigkeit dieser Welten.
Der Gesamtindex mittelt diese beiden unterschiedlichen Teilwerte vor der Rundung. Seine Verteilung kann von beiden Hälften abweichen. In diesen Gruppen wirkt der Gesamtwert ungefähr glockenförmig, obwohl der Biomteilwert von einer Normalverteilung abweicht. Wir beurteilen den Gesamtwert direkt; das Zusammenfassen zweier Werte belegt keine allgemeine Regel für jede Version oder jeden Radius.
Die Randbereiche mit einem Normal-Q-Q-Diagramm prüfen
Ein Histogramm zeigt hilfreich, wo die meisten Werte liegen, seine Klassen können aber kleinere Formunterschiede verdecken. Das Normal-Q-Q-Diagramm vergleicht die sortierten ungerundeten Werte mit den Werten, die anhand des beobachteten Mittelwerts und der Stichprobenstandardabweichung jeder Gruppe aus einer Normalverteilung zu erwarten wären. NISTs Erklärung von Normalwahrscheinlichkeitsdiagrammen beschreibt, wie Abweichungen von einer geraden Referenzlinie Unterschiede zu einer Normalverteilung sichtbar machen.
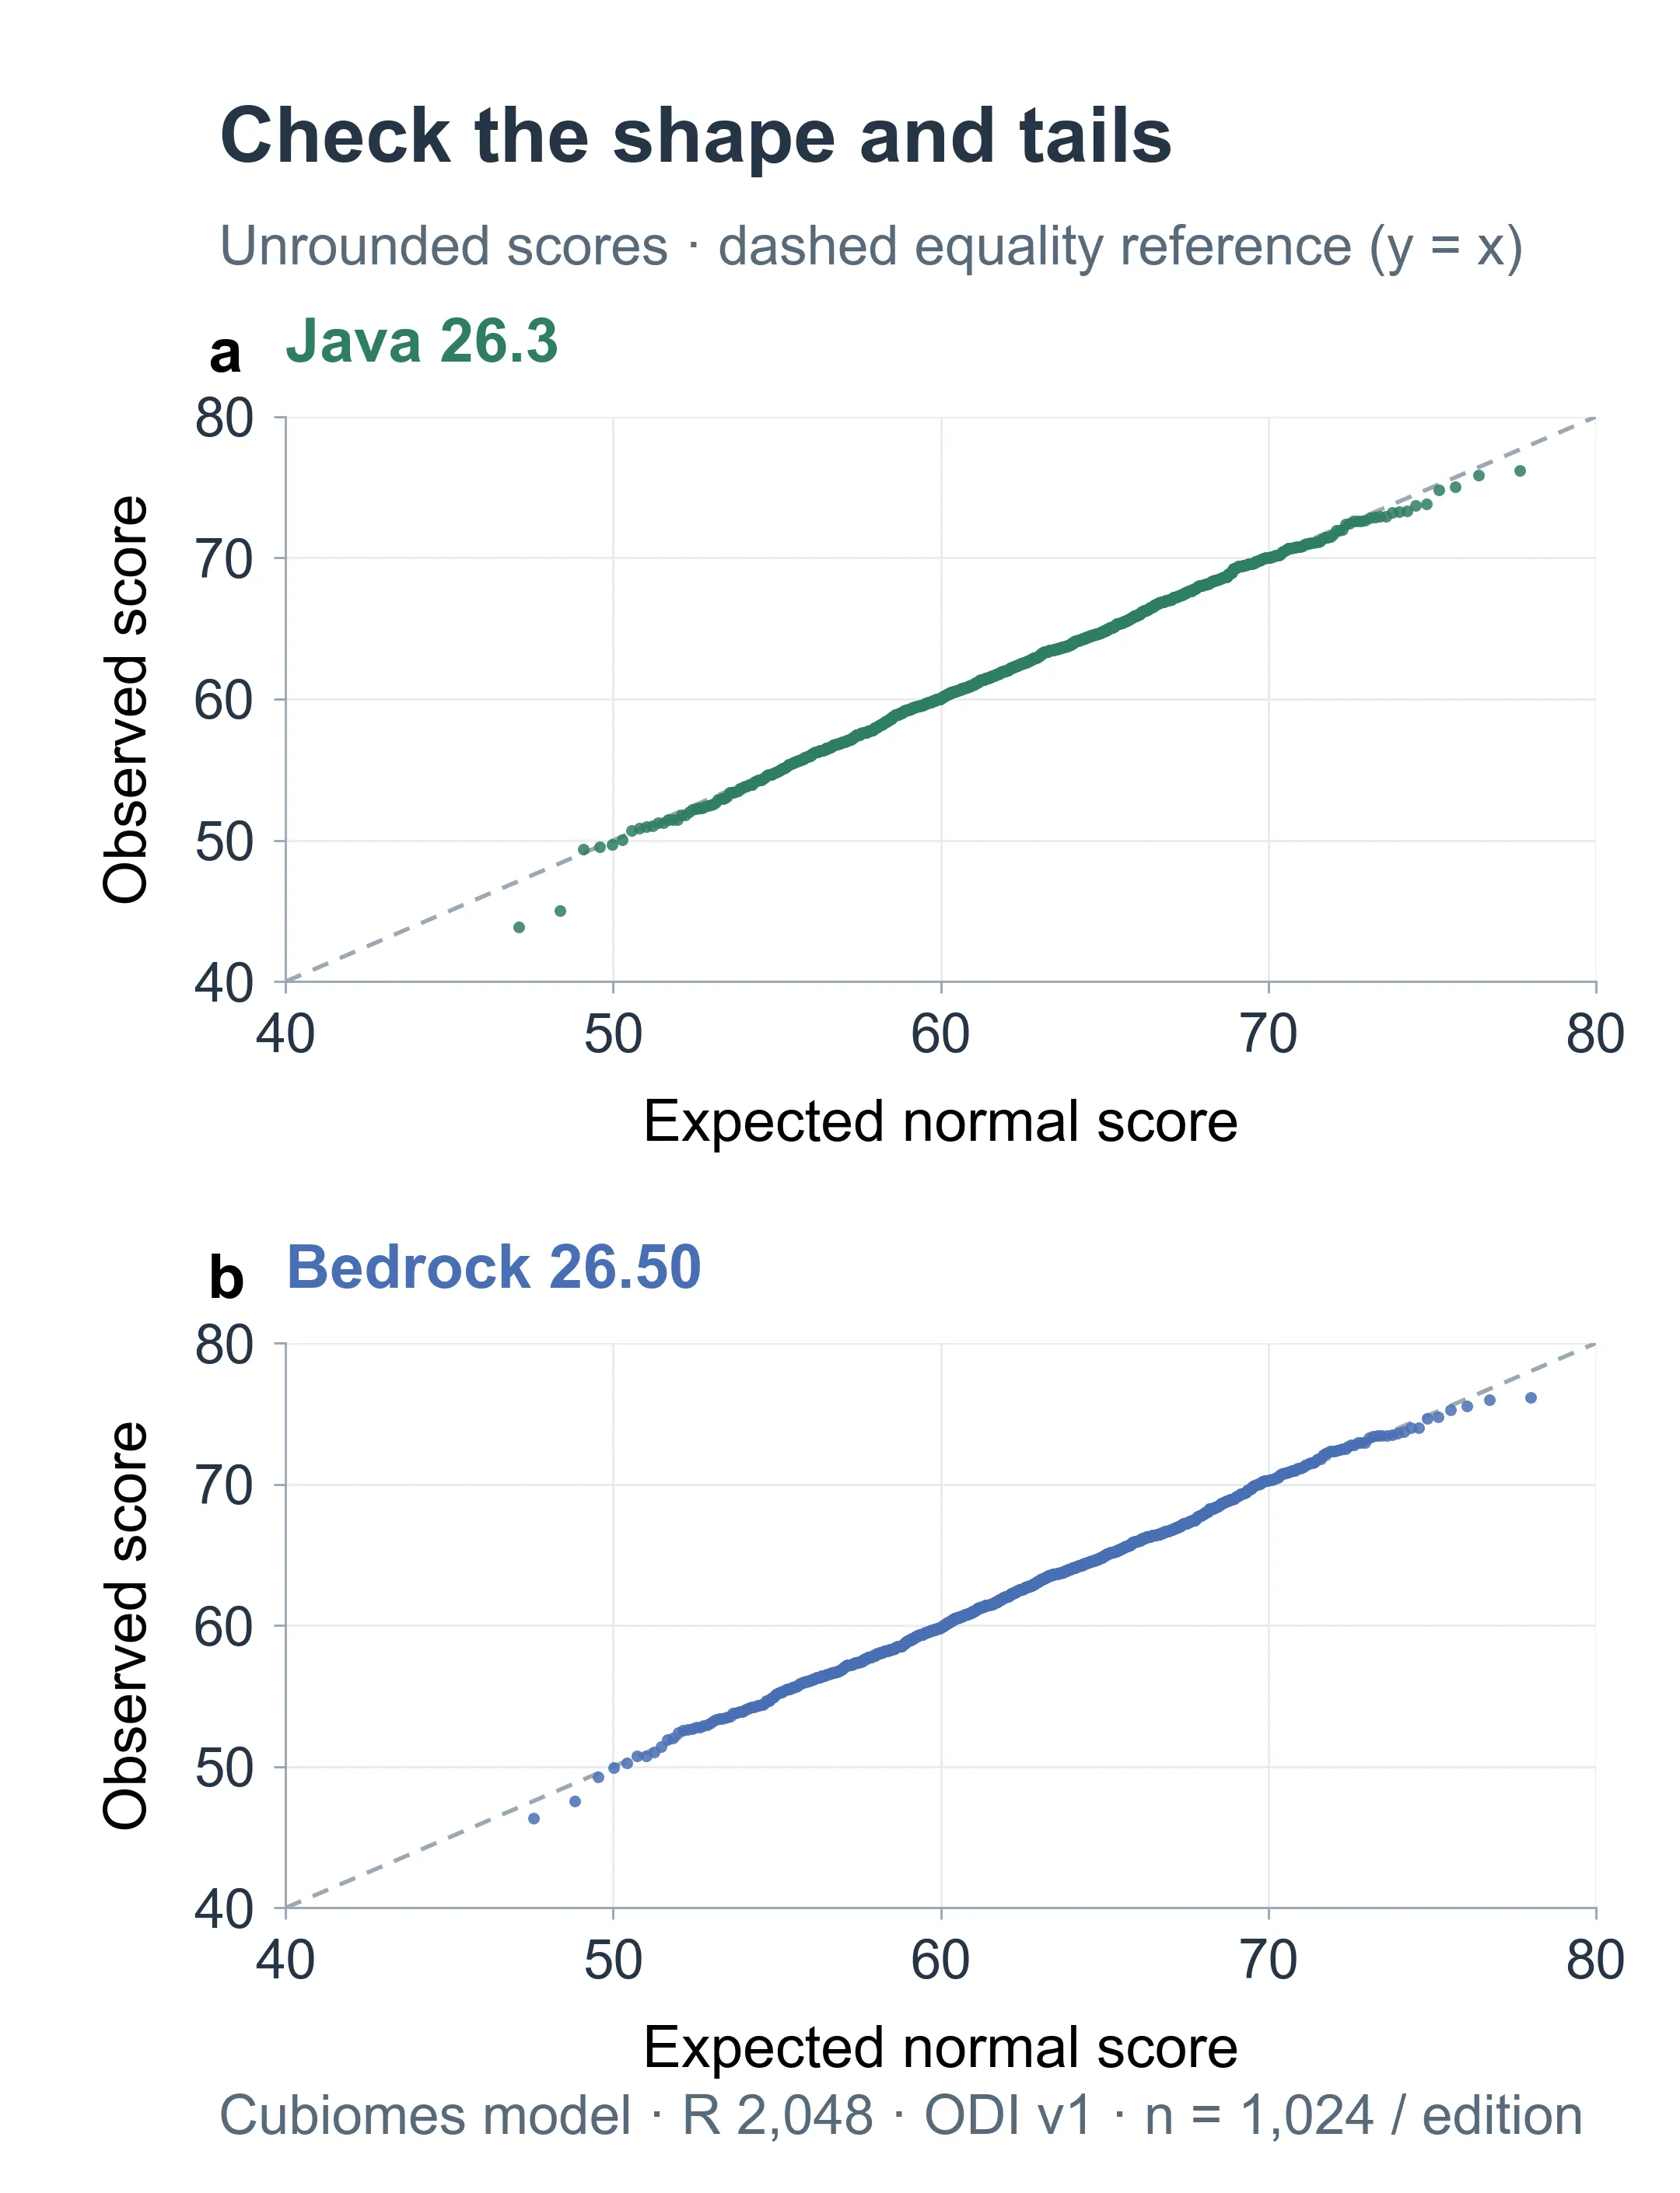
Jedes Feld enthält alle 1.024 ungerundeten Gesamtwerte. Erwartete normalverteilte Werte verwenden Mittelwert und Standardabweichung der Stichprobe; die graue Diagonale kennzeichnet gleiche erwartete und beobachtete Werte. Sie ist kein Konfidenzband.
Beide Achsen verwenden Indexpunkte. Ein Punkt auf der Diagonale hat den beobachteten Wert, der an dieser Position im Normalvergleich erwartet wird. Punkte darüber haben höhere beobachtete Werte; Punkte darunter niedrigere. Die Punkte ganz links und ganz rechts bilden die unteren und oberen Randbereiche der Stichprobe ab.
Die meisten Punkte folgen der Diagonale eng, mit Abweichungen an den Extremen. Diese Endpunkte sind wichtig, wenn die Frage ungewöhnlich niedrige oder hohe Werte betrifft. Eine enge Übereinstimmung in der Mitte belegt keine verlässliche Normalverteilungsschätzung für einen sehr seltenen Wert außerhalb des beobachteten Bereichs.
Was die Normalitätsprüfung belegt
Wir wendeten den von SciPy dokumentierten Shapiro-Wilk-Test auf den ungerundeten Gesamtwert und beide ungerundeten Teilwerte jeder Edition an. Ungerundete Werte vermeiden, gleiche Ganzzahlen der Anzeige als kontinuierliche Messungen zu behandeln. Wir verwendeten einen Schwellenwert von 0,05 und eine Holm-Korrektur über diese sechs Tests.
| Geprüfte Verteilung | Korrigierter p-Wert Java 26.3 | Korrigierter p-Wert Bedrock 26.50 | Ergebnis bei 0,05 |
|---|---|---|---|
| Gesamtindex | 0,667 | 0,667 | Keine Abweichung erkannt |
| Biomteilwert | 0,0059 | 0,0059 | Abweichung erkannt |
| Bauwerksteilwert | 0,231 | 0,472 | Keine Abweichung erkannt |
Die unkorrigierten p-Werte der Gesamttests betrugen 0,334 für Java und 0,660 für Bedrock. Ihre Nichtverwerfung ist mit den ungefähren Glockenformen dieser konkreten Stichproben vereinbar. Sie beweist keine Normalverteilung, bestätigt nicht die Generierungsmodelle und sagt nichts über die Wahrscheinlichkeit aus, dass eine Welt Spaß macht.
Die Werte bleiben auf 0 bis 100 begrenzt. Für Seed-Vergleiche verwenden wir die tatsächlich beobachteten Häufigkeiten, ohne einen Wert über eine angepasste Normalverteilungskurve umzurechnen. Die Tests und Diagramme beschreiben diese beiden Gruppen; andere Editionen, Versionen, Radien oder künftige Revisionen des Bewertungsschemas brauchen eigene Auswertungen.
Die vollständige statistische Zusammenfassung und alle untersuchten Modellergebnisse erhalten die Messungen hinter diesen Abbildungen. Die fünf Verteilungsabbildungen verwenden dieselbe gepaarte Stichprobe; die Abbildung zum Entfernungsbeitrag veranschaulicht die Formel.
Einen einzelnen Wert einordnen
Für den Beispiel-Seed Java 26.3 Seed 12345 sagt der Rechner einen Wert von 69 voraus, mit 30 von 35 erfassten Familien und 14 von 17 vorhergesagten Bauwerkstypen. Diese Abdeckungszahlen entsprechen vor Entfernungsabzügen etwa 84 möglichen Punkten: 50 × 30 / 35 + 50 × 14 / 17 ≈ 84. Die nächsten Entfernungen reduzieren das auf die angezeigten 69. In der passenden Referenzstichprobe waren 922 Werte niedriger, 27 gleich und 75 höher.
Die gleichen Werte sind wichtig. Jede angezeigte 69 steht für ein gerundetes Ergebnis, das aus unterschiedlichen Kombinationen von Biom- und Bauwerksbeiträgen entstehen kann. Die exakten Zahlen niedrigerer, gleicher und höherer angezeigter Werte erhalten diese Gleichstände. Sie erklären den Vergleich außerdem direkter, als stillschweigend jedem Seed mit gleichem Wert dasselbe geschätzte Normalperzentil zuzuweisen.
Der Rechner zeigt das beobachtete Histogramm, den Stichprobenmedian, den Bereich P10 bis P90 und die Zahlen unter, gleich und über deinem Wert, wenn Edition, Version, Radius, Bewertungsschema und Generierungsmodell exakt übereinstimmen. Andere Einstellungen erhalten weiterhin ihre Entdeckungsaufschlüsselung; sie haben derzeit keine passende Referenzstichprobe.
Auch die Begegnungshäufigkeit braucht einen eigenen Nenner. In der Java-26.3-Gruppe erfasste das Modell bei diesem Radius eine Pilzlandfamilie in 294 von 1.024 Seeds (28,7%) und sagte ein Waldanwesen in 158 (15,4%) voraus. Das sind Vorkommen irgendwo innerhalb des Kreises um den geschätzten Spawn, keine Wahrscheinlichkeit, in diesem Biom zu spawnen, und kein Maß für seinen weltweiten Flächenanteil.
Ein Histogramm des Gesamtwerts beantwortet, wie oft der Rechner in dieser Stichprobe bestimmte Summen erzeugte. Ein nach Seltenheit gewichtetes Kriterium würde eine andere Frage zur Begegnungshäufigkeit bestimmter Familien oder Bauwerkstypen stellen. Revision 1 behält gleiche Gewichte innerhalb jeder Kategorie bei; diese Messungen wurden nicht in Seltenheitsboni umgewandelt. Eine solche Änderung bräuchte Begegnungsgrundlagen passend zu Edition, Generierungsversion, Radius und Stichprobenregeln sowie eine neue geprüfte Revision des Bewertungsschemas.
Dies ist eine Referenzstichprobe von Modellvorhersagen und kein Seltenheitsperzentil einer Grundgesamtheit, keine Stichprobe gespielter Welten und keine Messung der Wege von Spielern. Ein Wert von 80 bedeutet nicht, dass ein Seed vielfältiger als 80% aller Seeds ist. Verwende den Rechner, um die modellierten Entdeckungen in deinem geplanten Erkundungsbereich zu vergleichen, und untersuche anschließend die für dich wichtigen Positionen auf der Seed-Karte.