seedlookout
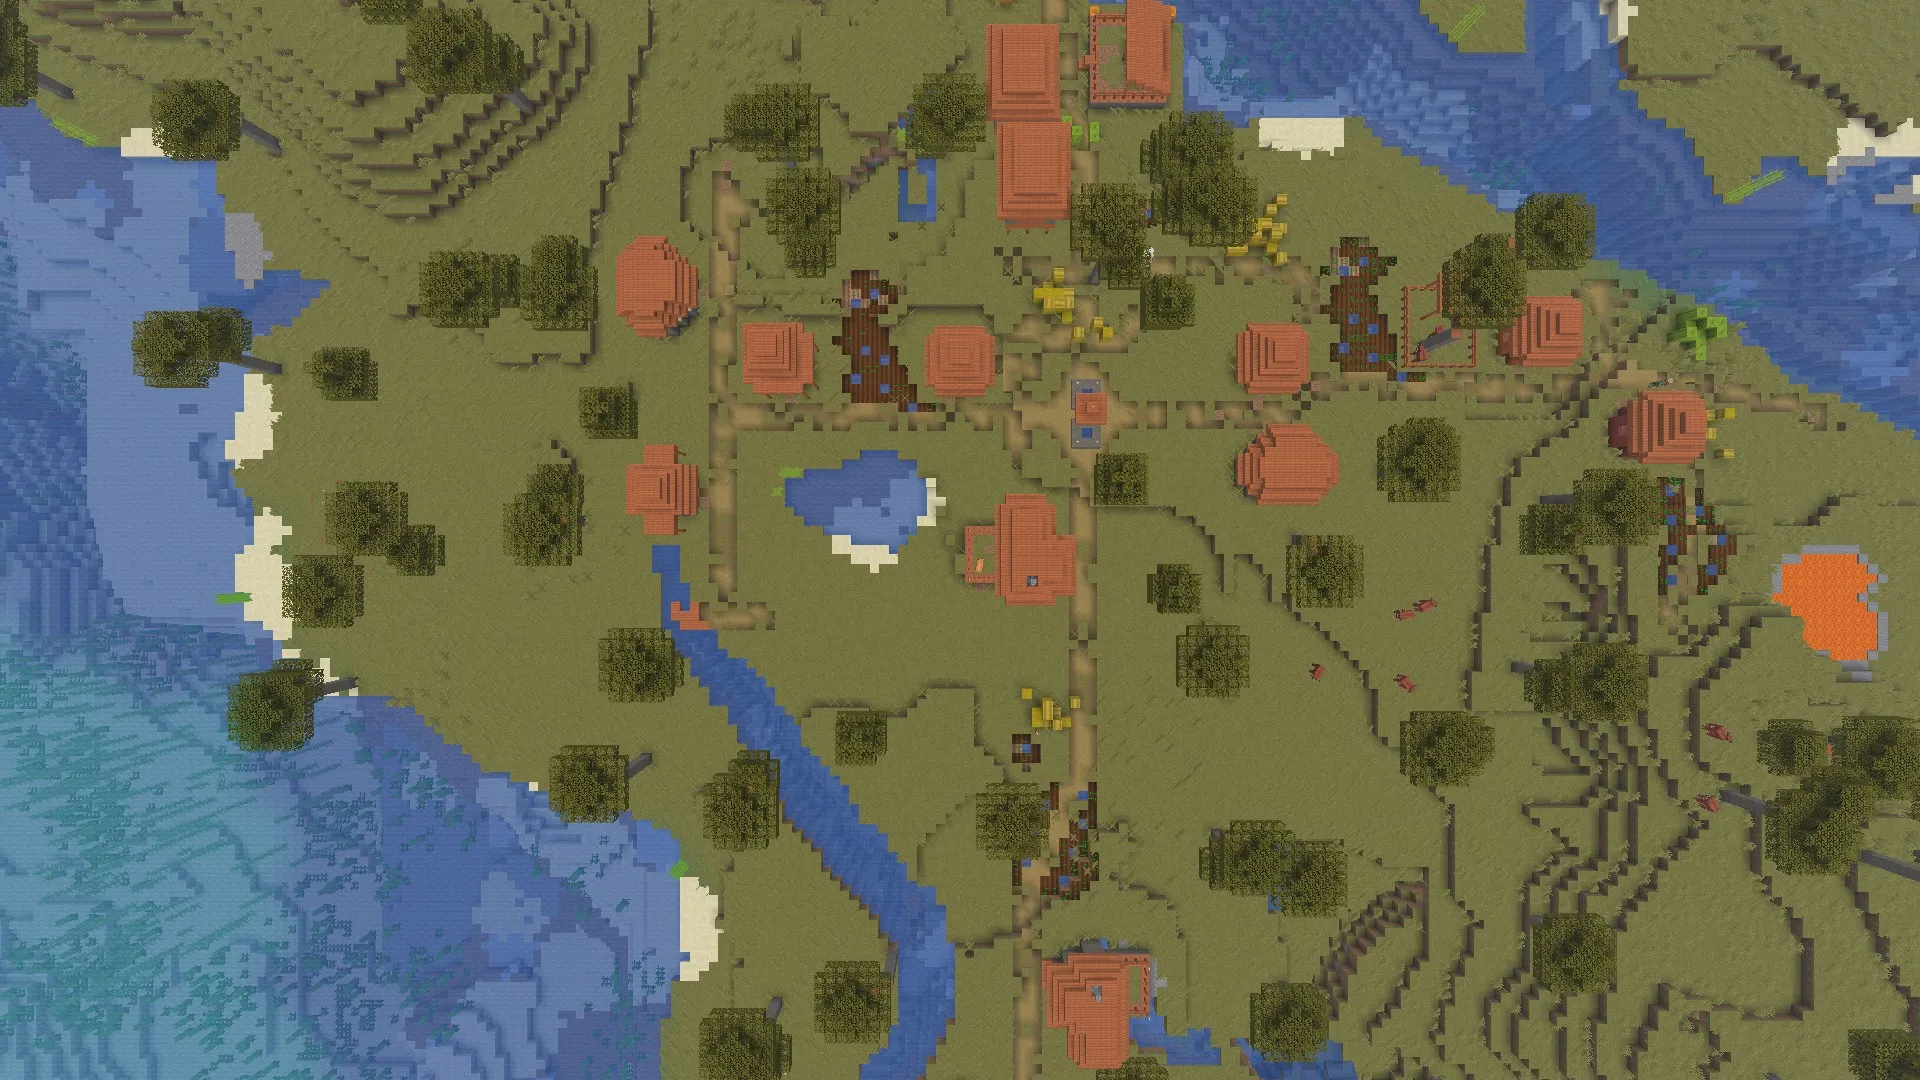
Quelle est la probabilité d’apparaître réellement à l’intérieur d’un village ? Nous ne l’avons pas encore mesurée dans le jeu. Cette étude mesure la fréquence à laquelle un marqueur de village prédit se trouve près du point d’apparition estimé du monde.
Java 26.3 est la dernière version Java stable au 1 octobre 2026. Ces chiffres s’appliquent à sa génération de monde par défaut.
Ce que nous avons mesuré
Notre échantillon principal portait sur 1 000 000 graines numériques pseudo-aléatoires réparties sur la plage des entiers signés de 64 bits. Nous avons mesuré la distance horizontale entre le point d’apparition estimé et le marqueur de village le plus proche ayant passé les vérifications de biome du modèle. Nous n’avons étudié ni la génération avec une graine laissée vide ni les choix de graines textuelles. Les villages abandonnés étaient inclus.
Résultats
Notre échantillon principal du modèle Java 26.3 prédit un marqueur de village à une distance d’au plus 64 blocs du point d’apparition estimé du monde pour environ 0,94% des graines numériques, soit 1 sur 107. Commencer parmi les bâtiments dépend de l’agencement du village et de votre première position réelle.
| Distance maximale du marqueur de village (borne incluse) | Graines correspondantes | Estimation principale |
|---|---|---|
| 16 blocs | 1 431 | 0,14% |
| 32 blocs | 3 138 | 0,31% |
| 64 blocs | 9 379 | 0,94% |
| 128 blocs | 32 349 | 3,23% |
| 256 blocs | 156 708 | 15,67% |
| 512 blocs | 545 891 | 54,59% |
Ces taux sont cumulatifs : un résultat à 32 blocs ou moins compte aussi dans le seuil de 64.
Le résultat à 64 blocs possède un intervalle d’échantillonnage de Wilson à 95% d’environ 0,92% à 0,96%, en traitant les entrées pseudo-aléatoires comme des tirages uniformes. Il exclut les erreurs du modèle.
Nous avons effectué trois échantillonnages répétés, chacun avec 1 000 000 nouvelles graines numériques. À 64 blocs, leurs décomptes étaient de 9 379, 9 535 et 9 465. Leur moyenne est de 0,9460% ± 0,0045 point de pourcentage (moyenne ± SEM, N = 3). L’échantillon principal reste distinct. Tous les essais utilisent le même modèle de génération.
Le SEM correspond à l’écart-type d’échantillon des trois taux répétés, divisé par √3. Nous supposons les échantillons pseudo-aléatoires indépendants ; le simple fait que les ensembles de graines soient disjoints ne suffit pas à établir cette indépendance. Avec seulement trois répétitions, le SEM est estimé de façon imprécise. Il décrit la stabilité de l’échantillonnage, exclut l’erreur commune du modèle et n’est pas un intervalle de confiance à 95%.
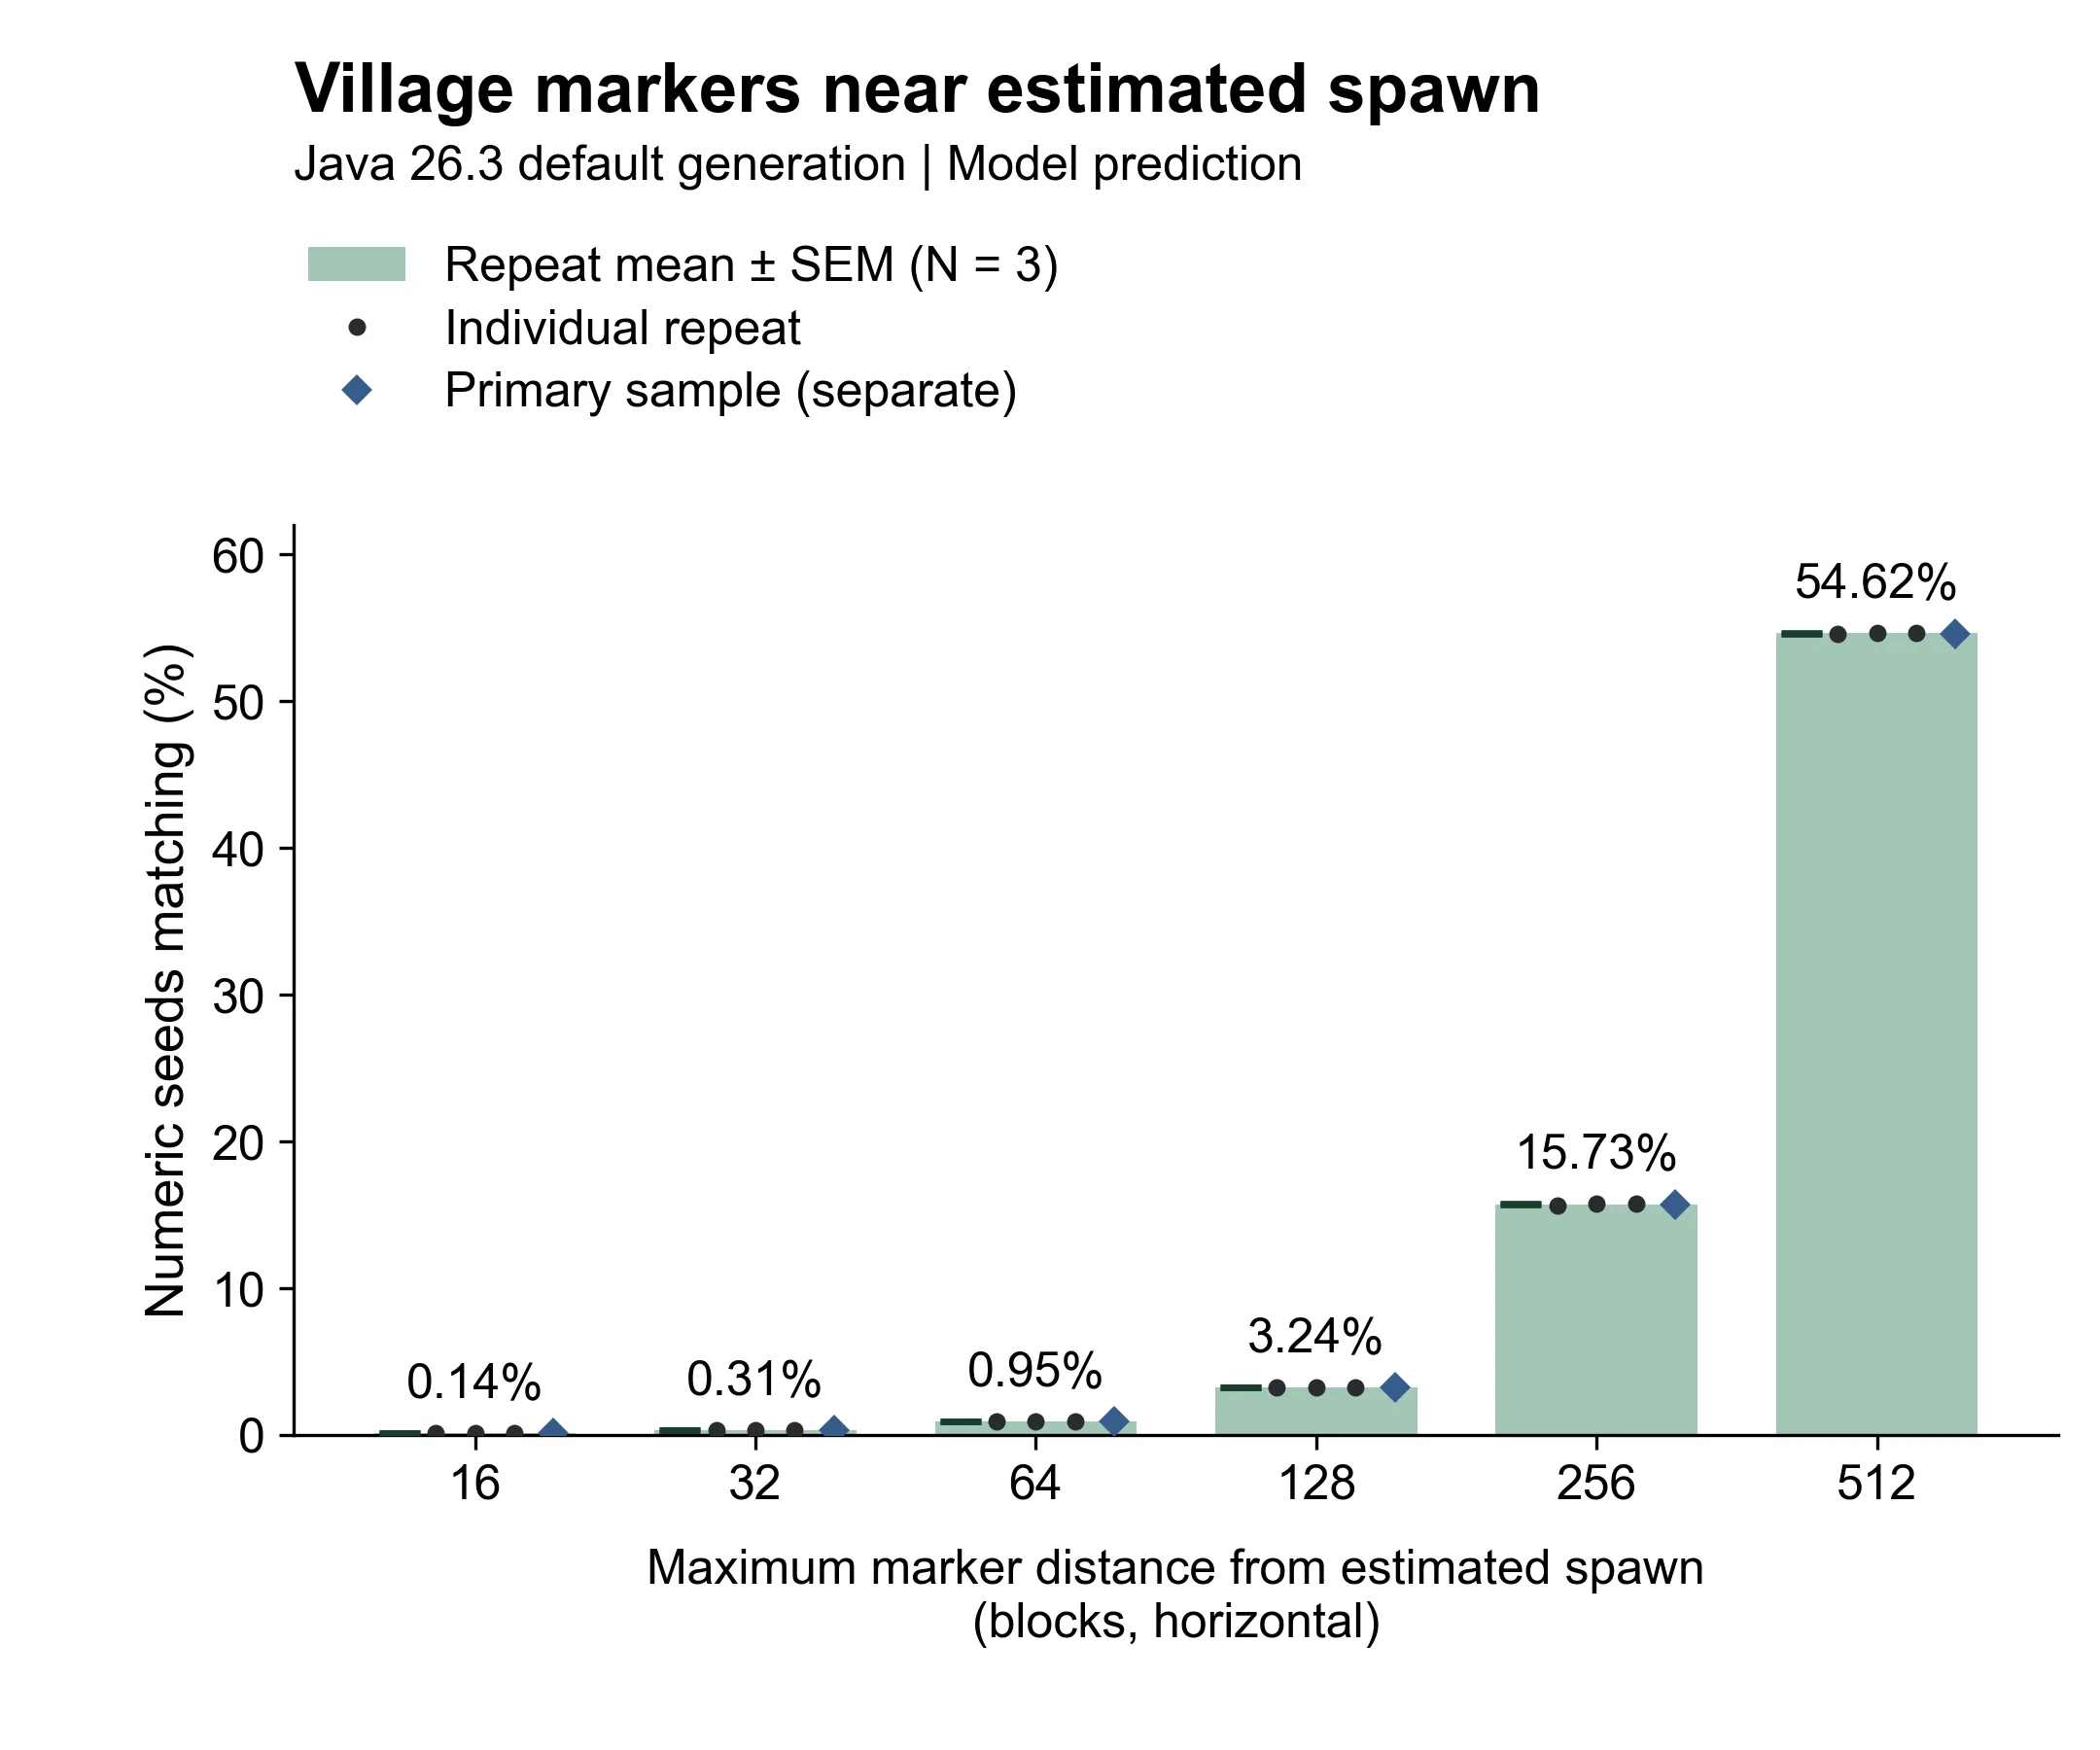
Figure 1. Moyenne des trois répétitions ± SEM ; les points représentent les répétitions et les losanges l’échantillon principal distinct. Chaque essai utilisait 1 000 000 graines. Les seuils se chevauchent : ne les additionnez pas. Le SEM exclut l’erreur du modèle et n’est pas un intervalle à 95%. Décomptes et intervalles de Wilson (CSV), moyennes des répétitions et SEM (CSV).
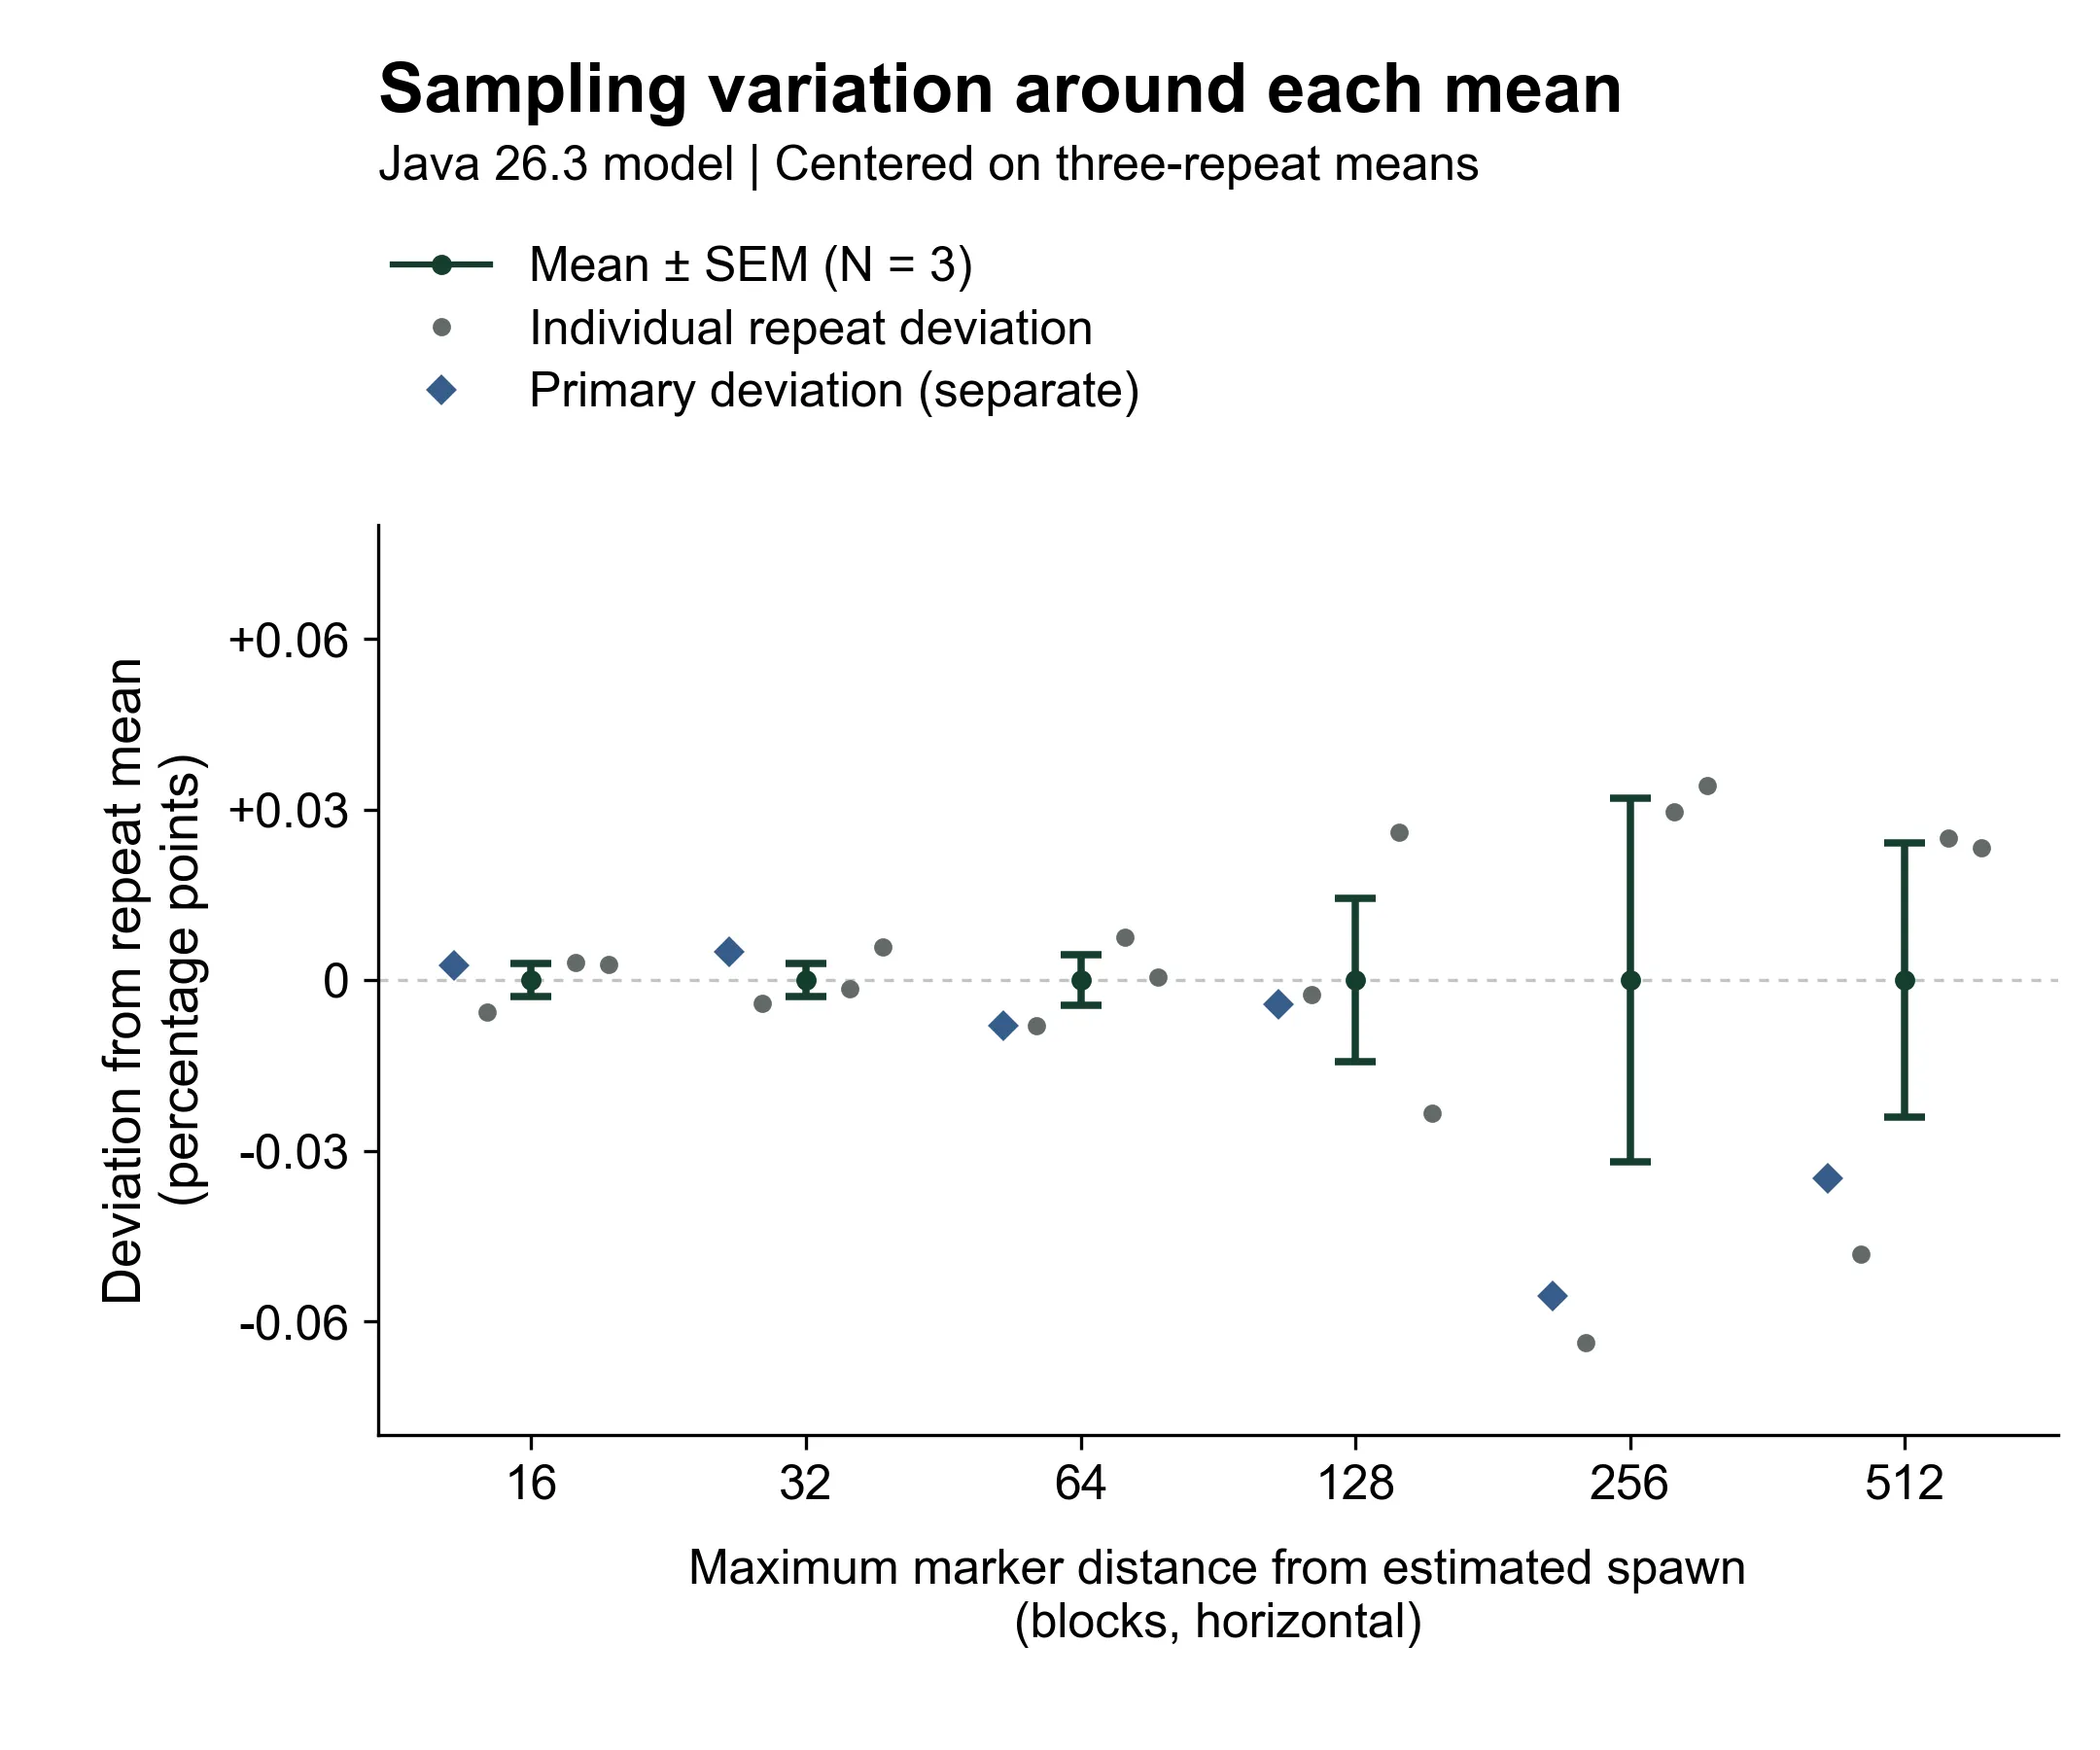
Figure 2. Chaque rayon est centré sur sa moyenne des trois répétitions, avec des bornes −SEM et +SEM. L’axe montre des écarts en points de pourcentage ; les valeurs négatives ne sont pas des probabilités négatives. Chaque essai utilisait 1 000 000 graines. Le SEM exclut l’erreur du modèle.
Notre méthode d’étude et sa provenance (JSON) relient le protocole fixe, les révisions des sources et les données enregistrées. L’accord entre les implémentations du modèle vérifie leur cohérence, pas leur précision par rapport au jeu.
Cela signifie-t-il que vous apparaissez dans le village ?
Tracer un cercle de 64 blocs autour de chaque marqueur transforme l’événement compté en « le point d’apparition estimé se trouve dans ce cercle ». C’est une illustration géométrique du seuil de proximité. Nous n’avons pas mesuré l’emprise des villages, et le cercle ne donne aucune probabilité mesurée de commencer parmi des bâtiments ou des chemins réels.
Les vrais villages s’étendent sur des bâtiments et des chemins. Un marqueur ne décrit pas cet agencement, et le point d’apparition estimé peut différer de la première position de votre personnage. Le terrain et les étapes ultérieures de génération peuvent aussi affecter les structures. Notre guide de précision explique ces limites. Le taux réel d’apparition dans un village, à l’échelle de la population, n’a pas encore été mesuré dans le jeu.
Trois positions de départ dans Java 26.3
Chaque graine illustrée possédait un marqueur prédit à 16 blocs du point d’apparition estimé. Dans un monde neuf par graine, la première position se trouvait parmi les bâtiments et les chemins du village. Ces exemples sélectionnés n’établissent ni un taux à l’échelle de la population ni un bloc de départ garanti.
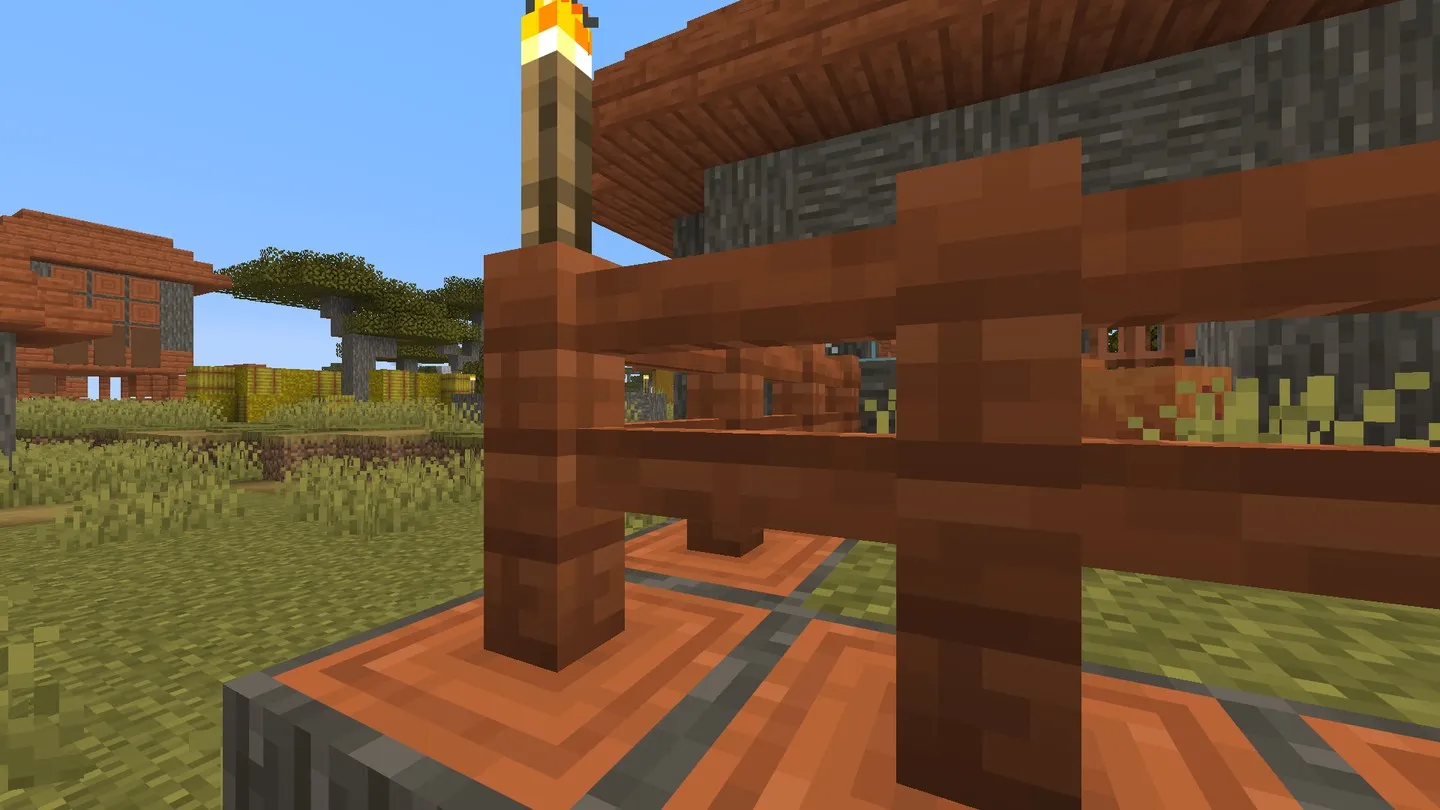
Village de savane : graine 2098594625401166349. Bloc de départ lors de cette vérification : X -1, Y 63, Z 8.
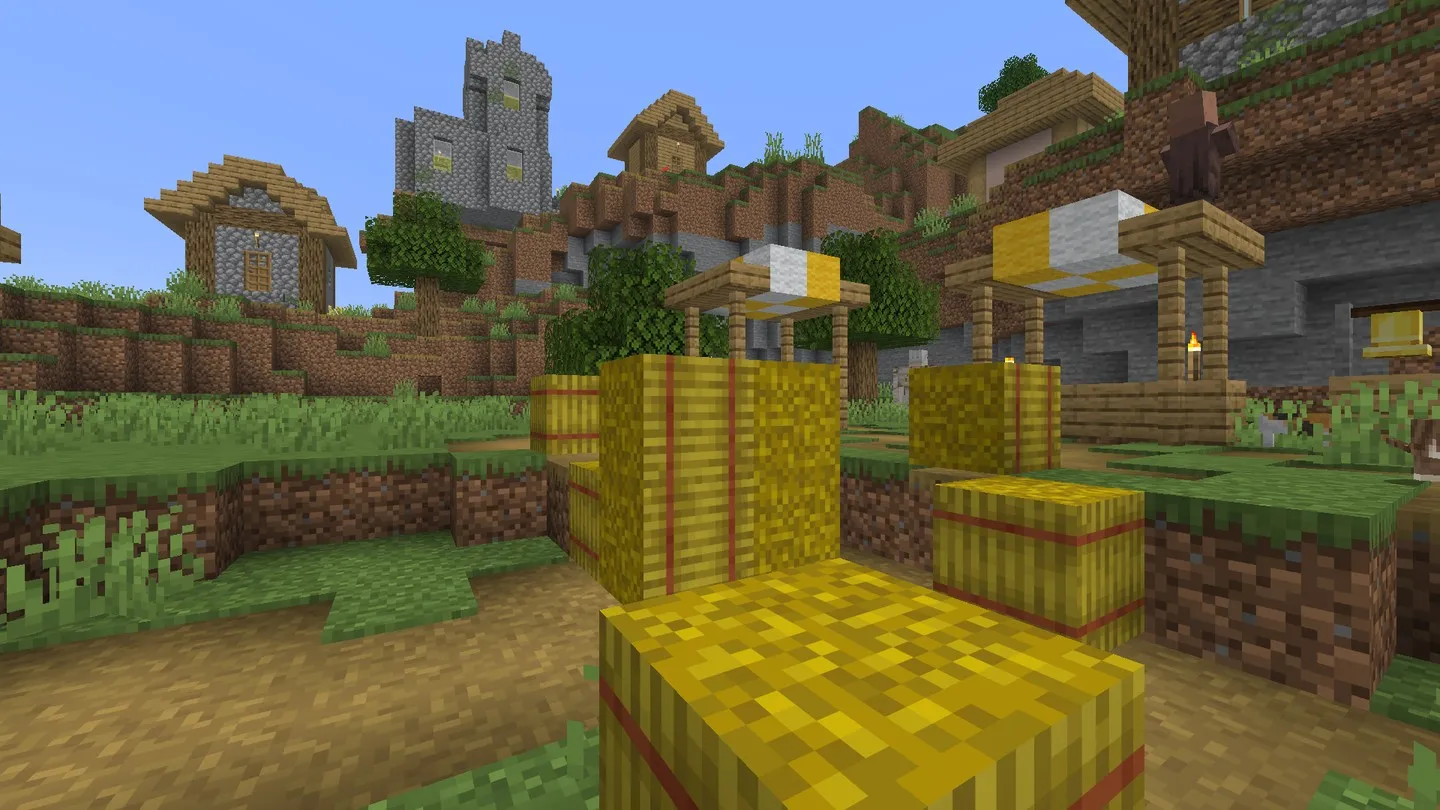
Village de plaine : graine -2608443705072891015. Bloc de départ lors de cette vérification : X 6, Y 78, Z 5.
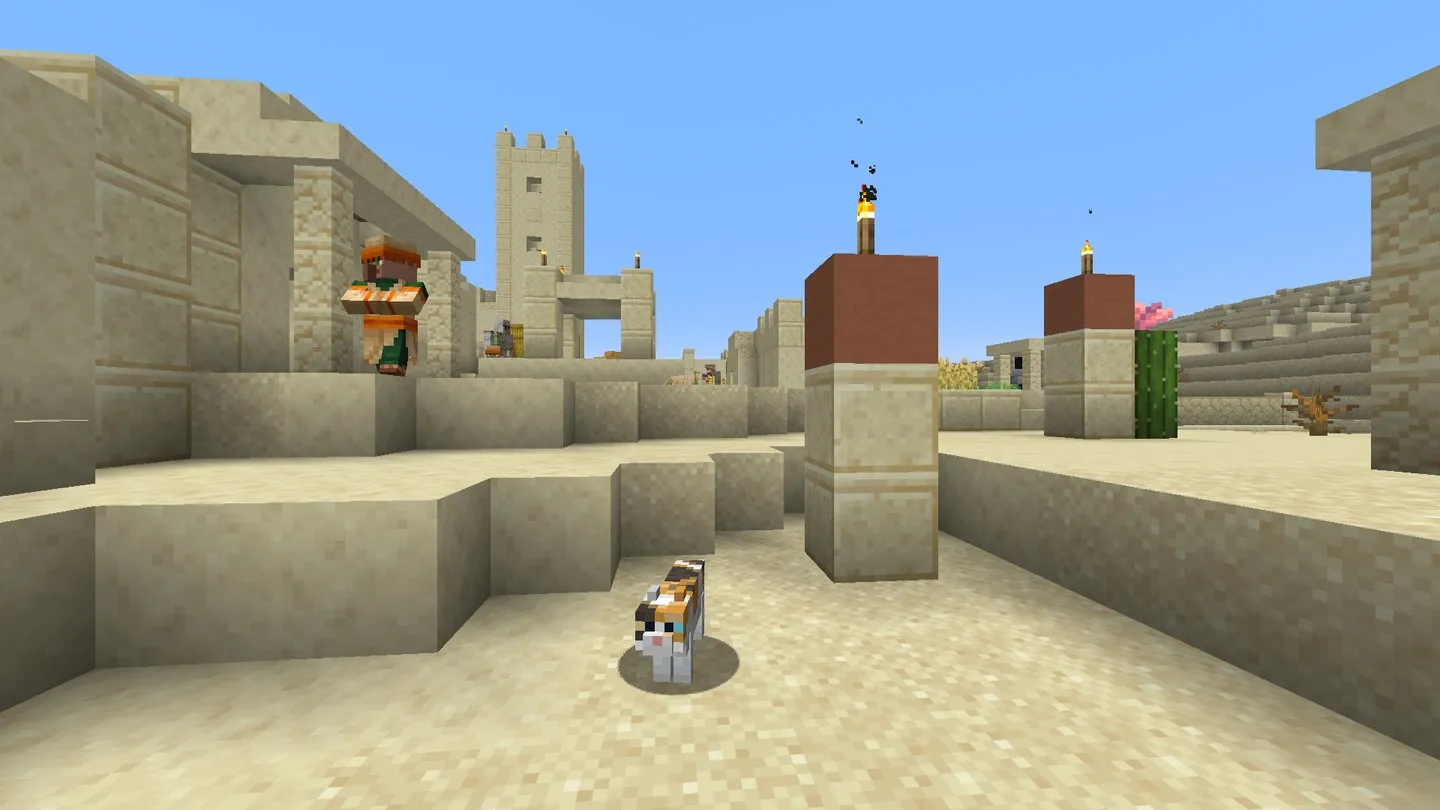
Village du désert : graine 2296403535492355971. Bloc de départ lors de cette vérification : X -3, Y 73, Z 56.
Conclusion
Les trois échantillons répétés ont donné des taux de proximité similaires : l’estimation était donc cohérente entre ces essais du modèle. Nous n’avons toujours pas de probabilité mesurée de commencer dans un village. Les captures montrent trois départs sélectionnés parmi des bâtiments et des chemins ; elles ne disent pas à quelle fréquence cela se produit.
Prochaine étape
Notre étude de suivi vérifiera dans le jeu des mondes choisis aléatoirement, avec une définition fixe de « à l’intérieur d’un village ». L’échantillon inclura des mondes sans prédiction de village proche. Nous comparerons les positions de départ réelles aux bâtiments et aux chemins générés, puis indiquerons dans quelle mesure la proximité du marqueur prédit un départ dans le village.
Trouvez un village pour votre prochain monde
Utilisez l’outil de recherche de villages avec Java 26.3 pour trouver des prédictions près du point d’apparition. Notre fiche sur les villages explique leur génération et leurs variantes. Vérifiez votre position de départ dans un monde neuf.