seedlookout
實際出生在村莊裡的機率是多少?我們還沒有在遊戲內測量這個機率。本研究測量的是:預測村莊標記多常落在估算世界出生點附近。
在 2026 年 10 月 1 日,Java 26.3 是 Java 的最新穩定版本。以下數據適用於該版本的預設世界生成。
測量內容
主要樣本涵蓋帶正負號 64 位元範圍中的 1,000,000 個偽隨機數字種子,測量估算出生點到最近村莊標記的水平距離;該標記須先通過模型的生態域檢查。我們沒有研究空白種子欄位的生成方式或文字種子的選擇,並將廢棄村莊納入樣本。
結果
主要 Java 26.3 模型樣本預測:約 0.94% 的數字種子,也就是每 107 個約有 1 個,在估算世界出生點的 64 個方塊內有村莊標記。是否會從建築之間開始遊戲,取決於村莊配置與你的實際首次位置。
| 村莊標記位於此距離內 | 符合的種子數 | 主要估計值 |
|---|---|---|
| 16 個方塊 | 1,431 | 0.14% |
| 32 個方塊 | 3,138 | 0.31% |
| 64 個方塊 | 9,379 | 0.94% |
| 128 個方塊 | 32,349 | 3.23% |
| 256 個方塊 | 156,708 | 15.67% |
| 512 個方塊 | 545,891 | 54.59% |
這些比例是累計值:距離在 32 個方塊內的結果,也計入 64 個方塊內。
將偽隨機輸入視為均勻抽樣時,64 個方塊的結果之 Wilson 95% 抽樣區間約為 0.92% 到 0.96%。此區間不包含模型誤差。
我們進行了三次重複抽樣,每次使用 1,000,000 個新的數字種子。在 64 個方塊內的數量分別為 9,379、9,535 和 9,465;平均為 0.9460% ± 0.0045 個百分點(平均值 ± SEM,N = 3)。主要樣本另行保留,所有執行都使用同一生成模型。
SEM 為三次重複抽樣比例的樣本標準差(SD)除以 √3。我們假設各次偽隨機抽樣彼此獨立;種子集合沒有重疊,本身並不能證明獨立性。只有三次重複時,SEM 的估計並不精確。它描述抽樣穩定程度,不包含共同的模型誤差,也不是 95% 信賴區間。
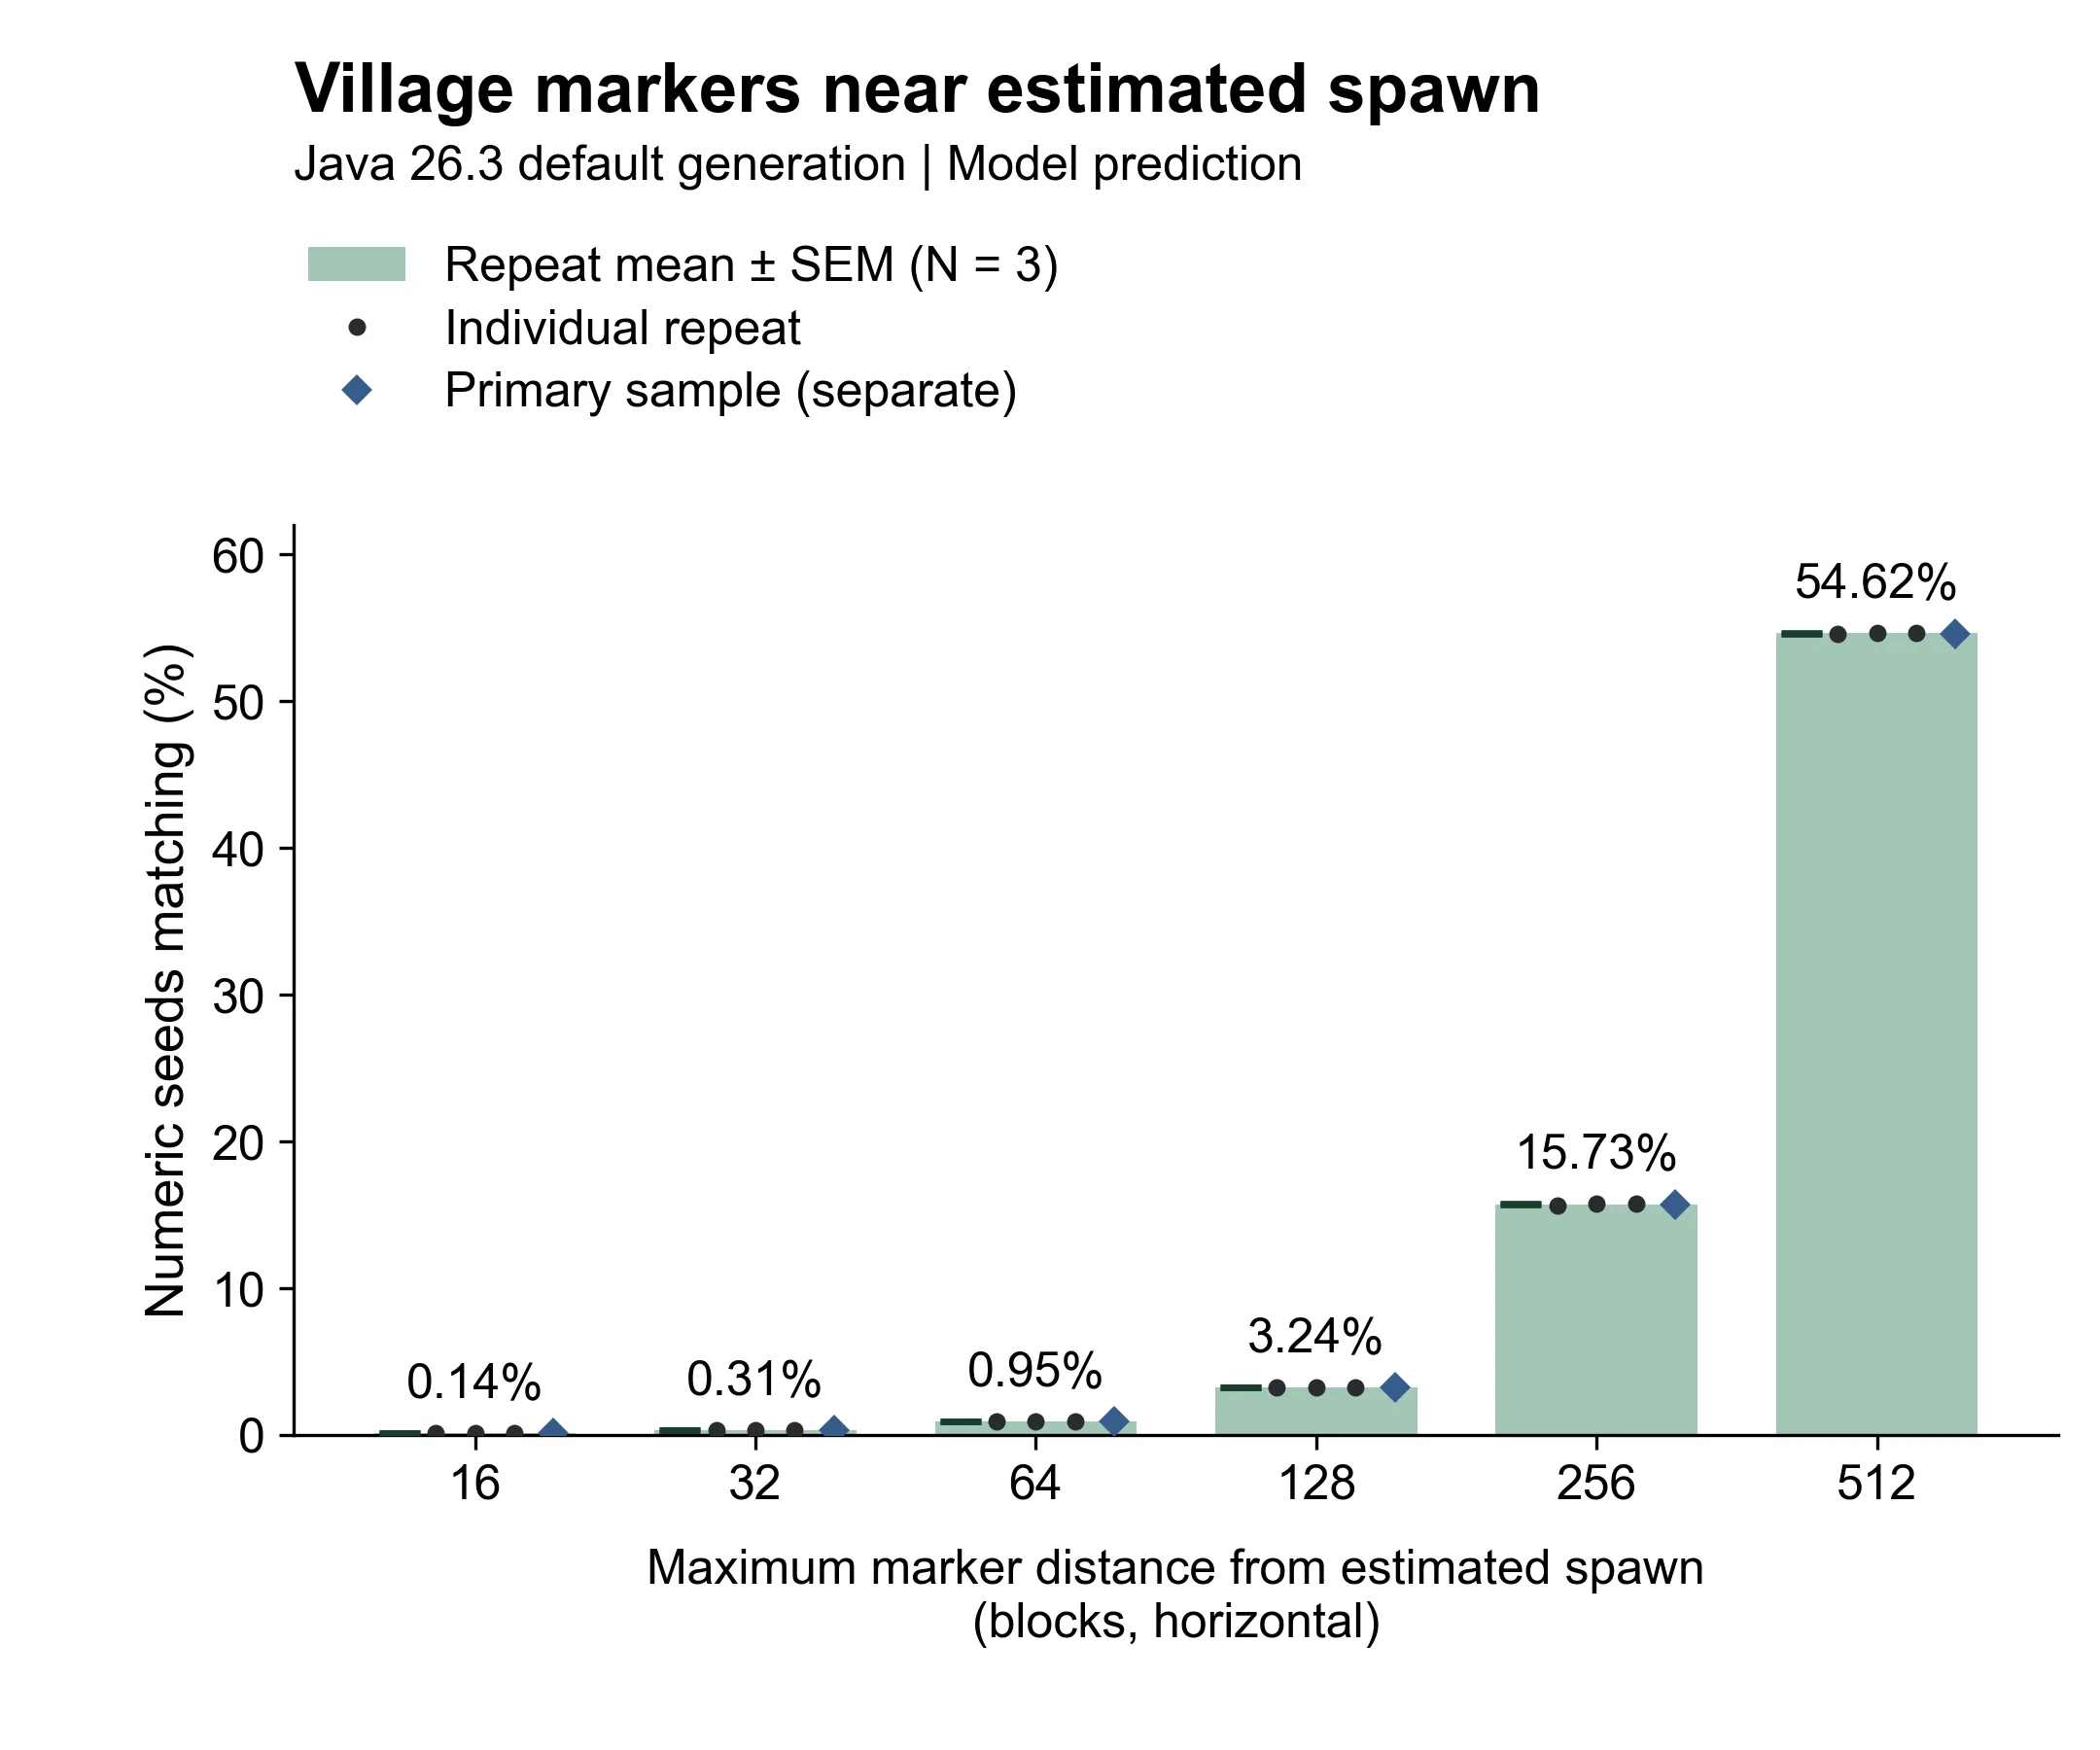
圖 1.三次重複的平均值 ± SEM;圓點為各次重複,菱形為另行保留的主要樣本。每次使用 1,000,000 個種子。各距離門檻彼此重疊,請勿相加。SEM 不包含模型誤差,也不是 95% 區間。數量與 Wilson 區間(CSV)、重複平均值與 SEM(CSV)。
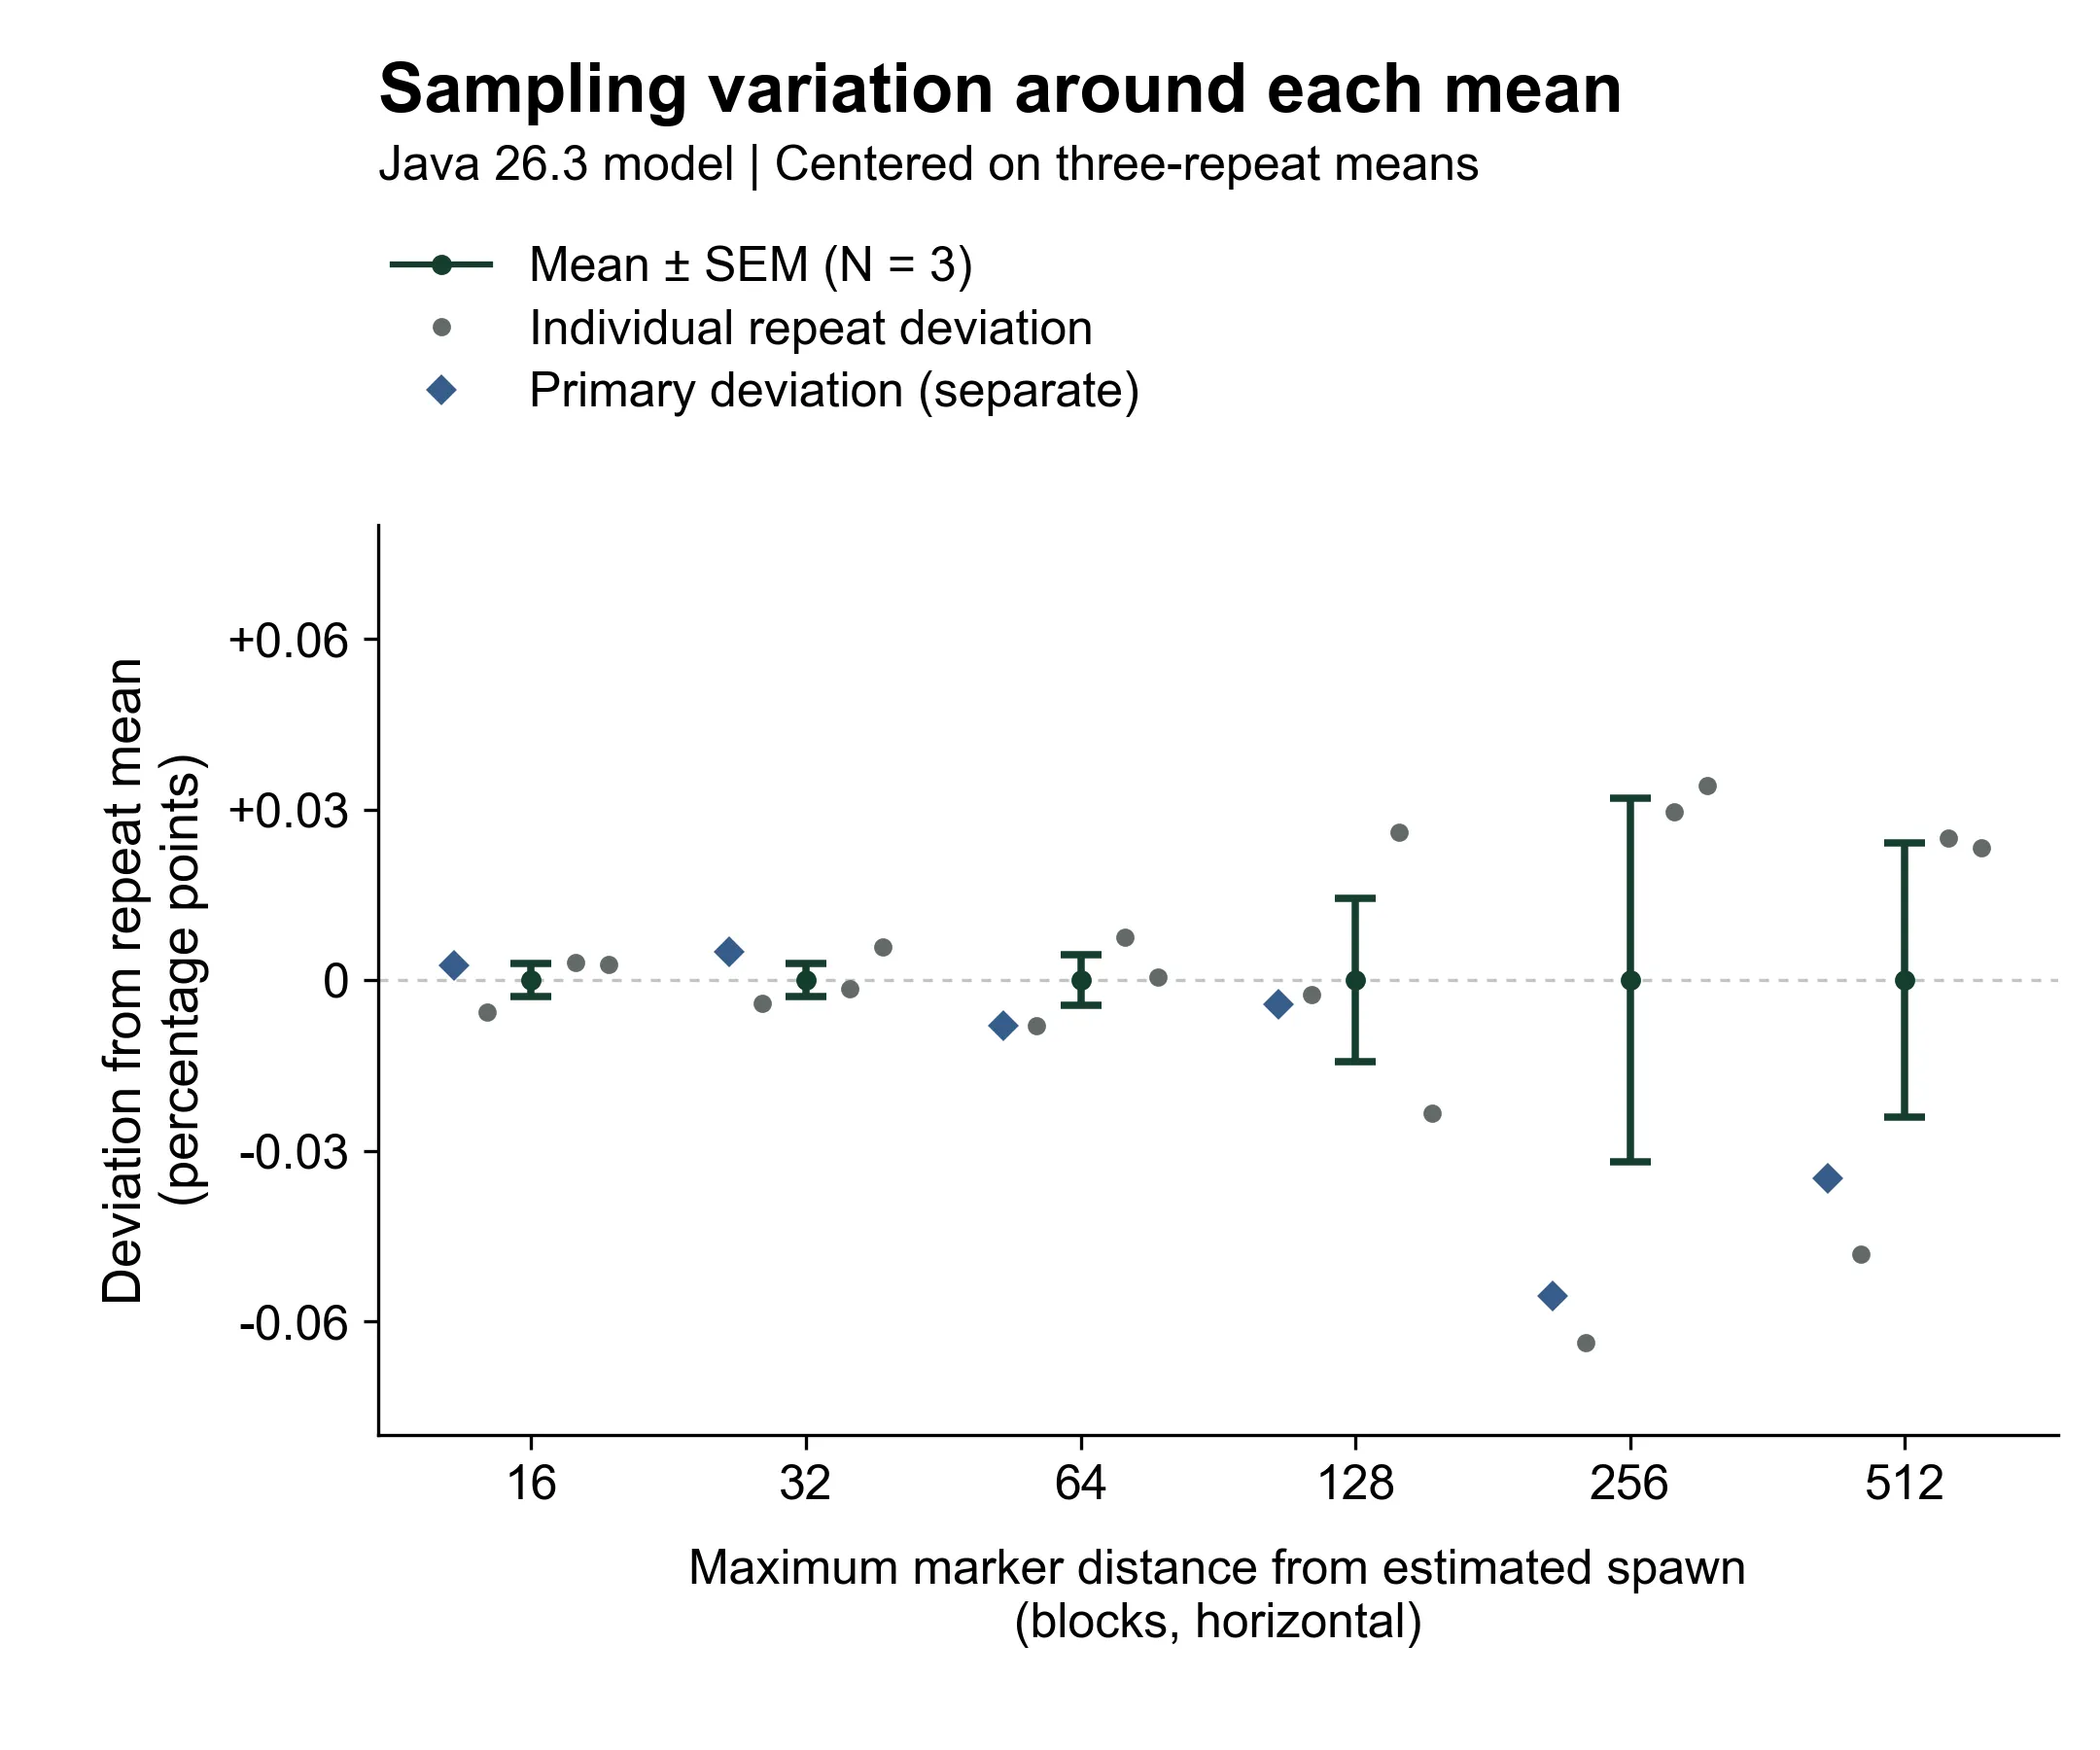
圖 2.每個半徑以其三次重複平均值為中心,誤差線端點為 −SEM 和 +SEM。座標軸顯示以百分點計算的偏差;負值並不代表負機率。每次使用 1,000,000 個種子。SEM 不包含模型誤差。
研究方法與資料來源(JSON)連結固定的研究程序、來源修訂版本與紀錄資料。不同模型實作的結果一致,只能檢查一致性,不能證明與遊戲相比的準確度。
這是否代表你會出生在村莊裡?
在每個標記周圍畫半徑 64 個方塊的圓,計入的事件就是「估算出生點位於該圓內」。這只是接近距離門檻的幾何示意。我們沒有測量村莊的占地範圍;這個圓也不提供從實際建築或道路之間開始遊戲的實測機率。
實際村莊由建築與道路分布而成。標記不描述這種配置,估算出生點也可能與角色首次出現的位置不同。地形與後續生成步驟同樣可能影響結構。準確度說明介紹了這些限制。整體種子中,實際在遊戲內出生於村莊的比例仍未測量。
Java 26.3 的三個起始位置
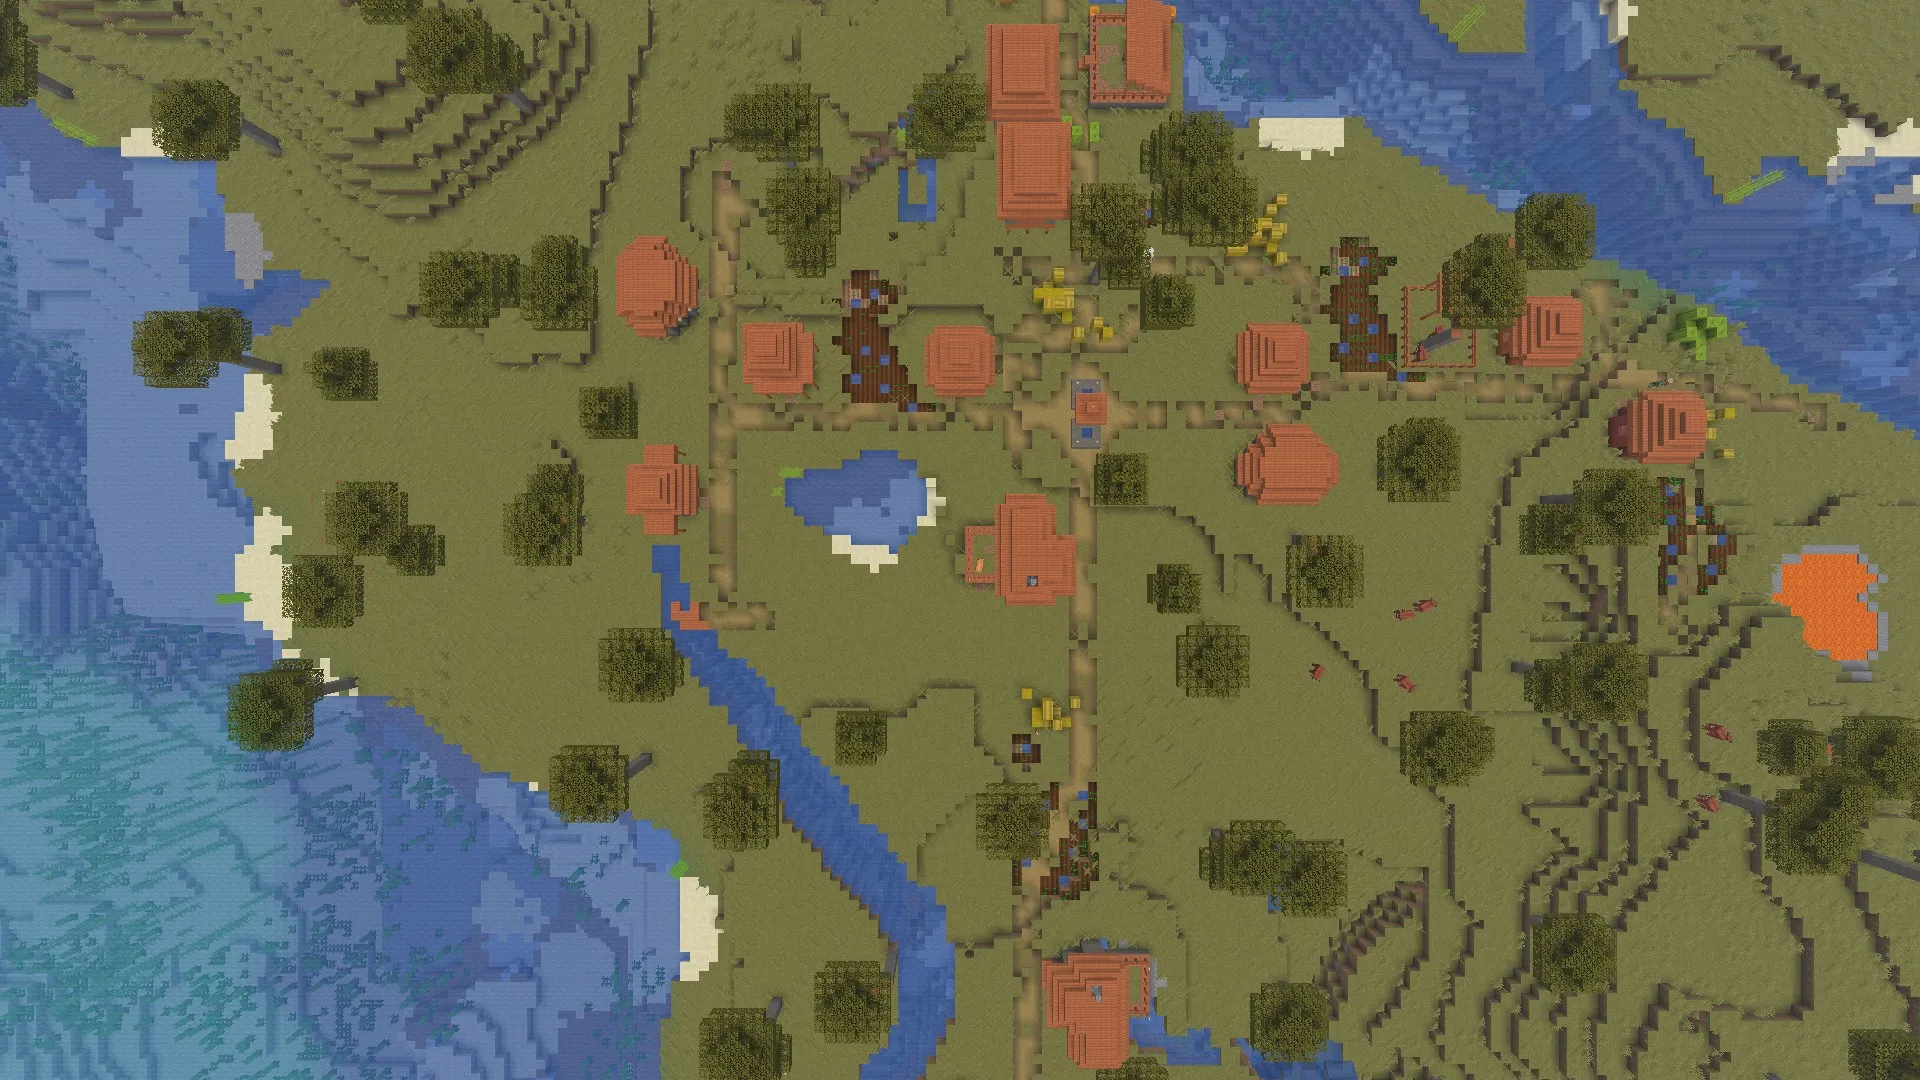
圖中的每個種子,其預測標記距離估算出生點都是 16 個方塊。我們為每個種子各建立一個新世界,首次位置都在村莊建築與道路之間。這些選定例子不能建立整體比例,也不保證一定從某個方塊開始。
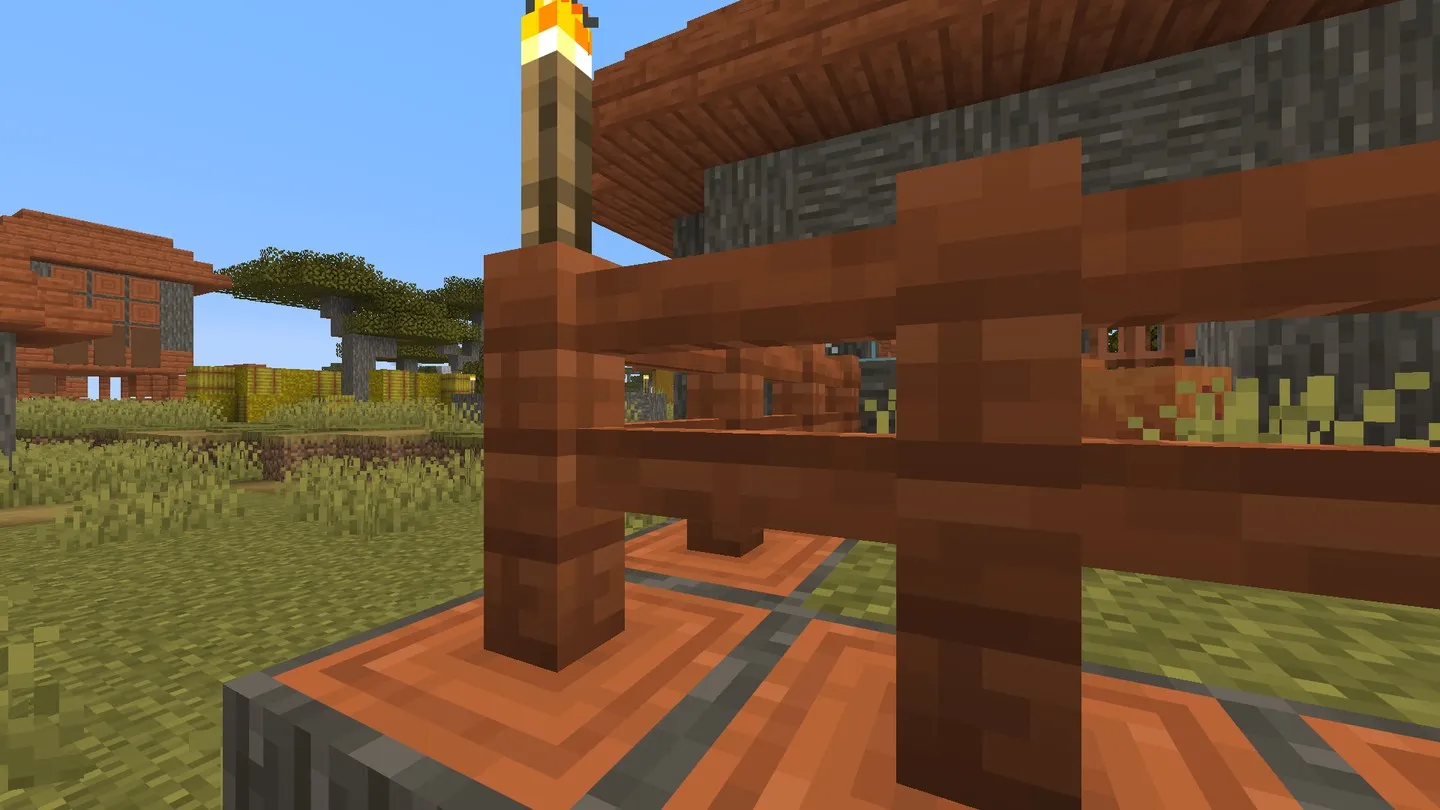
莽原村莊:種子 2098594625401166349。本次檢查的起始方塊:X -1, Y 63, Z 8。
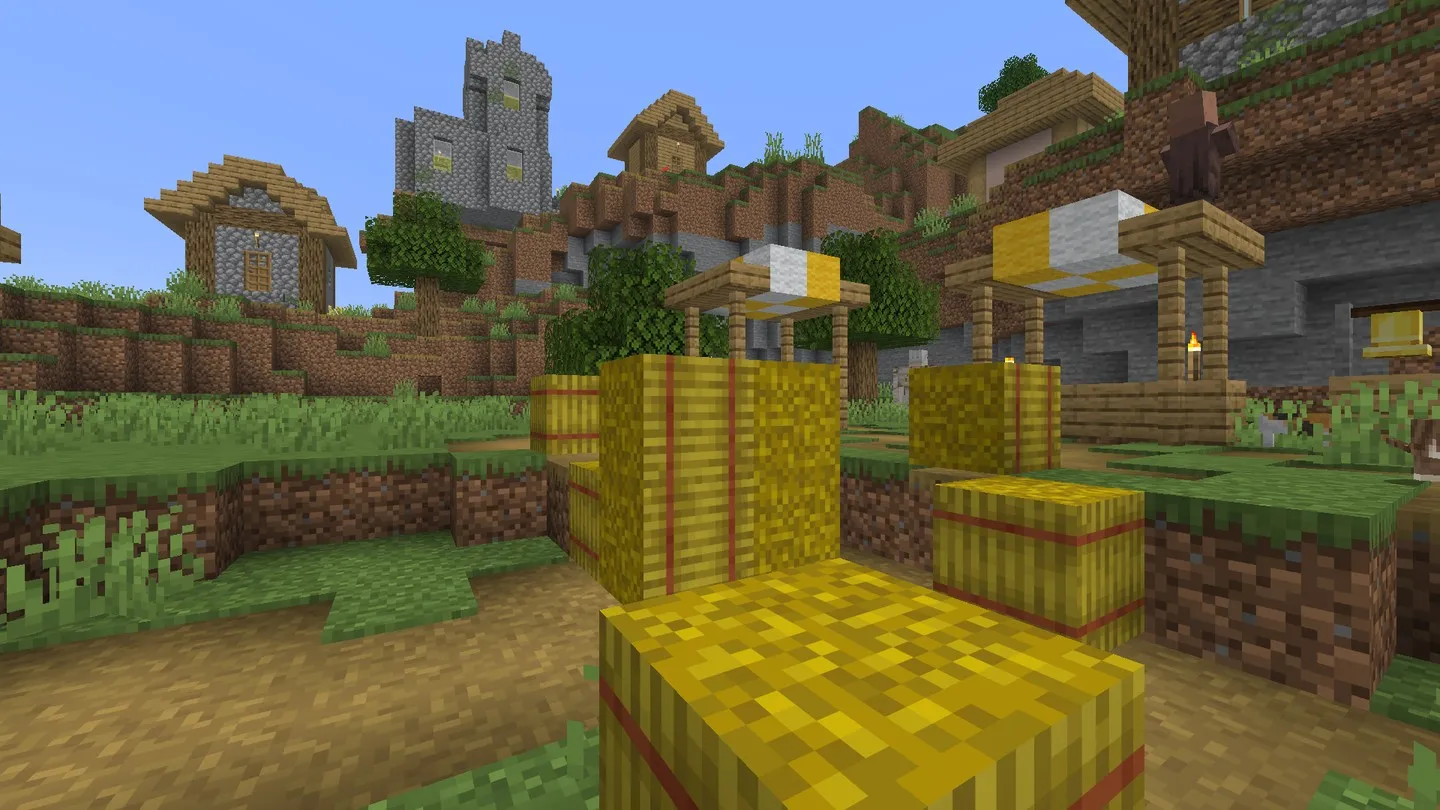
平原村莊:種子 -2608443705072891015。本次檢查的起始方塊:X 6, Y 78, Z 5。
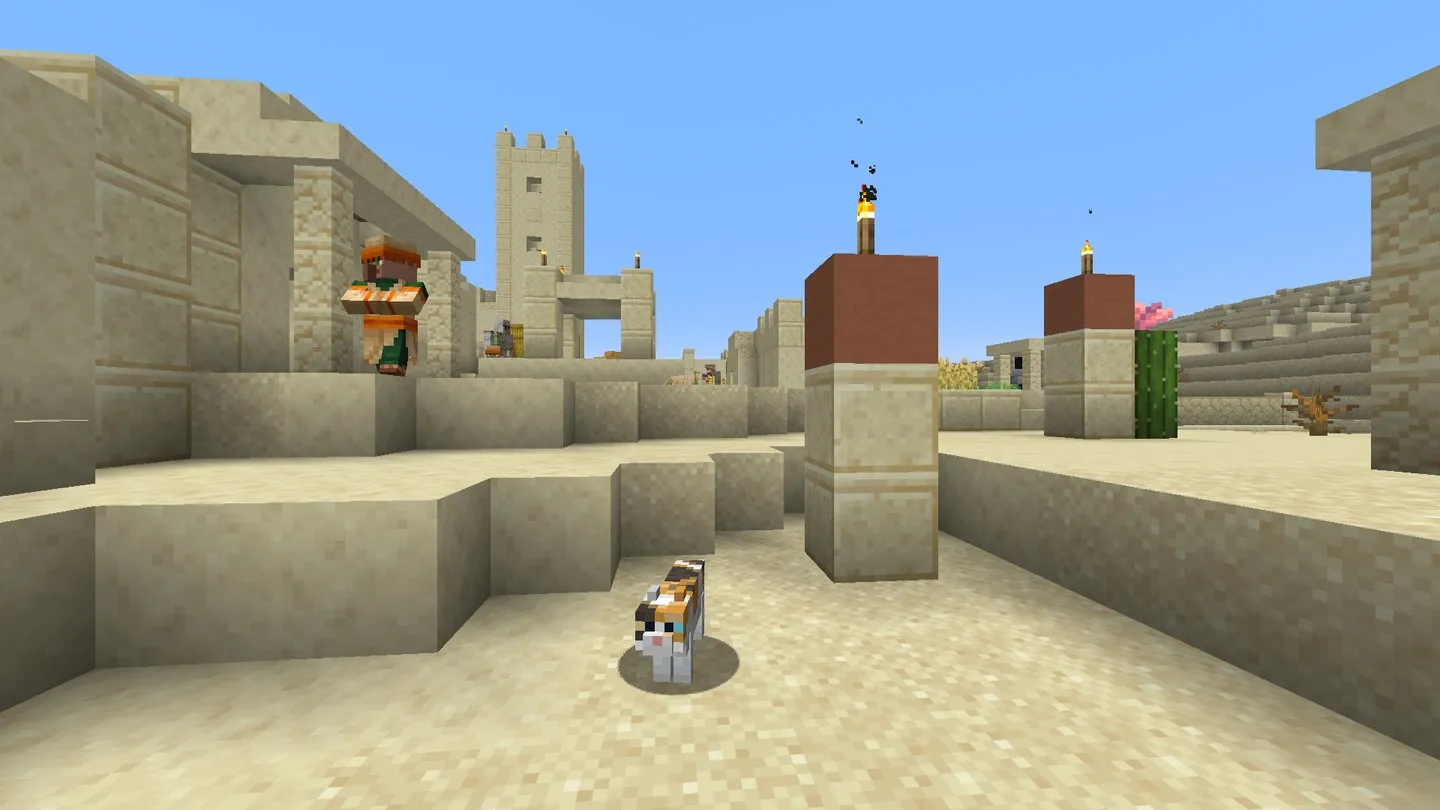
沙漠村莊:種子 2296403535492355971。本次檢查的起始方塊:X -3, Y 73, Z 56。
結論
三次重複樣本得到相近的接近比例,因此估計值在這幾次模型執行中一致。我們仍沒有實測出生在村莊裡的機率。截圖顯示三個選定的起始位置位於建築與道路之間,卻不能告訴我們這種情況多常發生。
未來方向
後續研究會使用固定的「村莊內」定義,在遊戲中檢查隨機選定世界。樣本也會包含沒有附近村莊預測的世界。我們將比較實際起始位置與生成的建築、道路,再報告標記距離對出生於村莊的預測能力。
為下一個世界找村莊
使用 Java 26.3 的村莊搜尋工具,尋找出生點附近的預測。村莊參考資料介紹生成方式與變體。請在全新世界中檢查自己的起始位置。